Flowness 工程进展:从需求到交付 · 阅读系列导读 →
一位读者的公司共享盘上有六十多万份文件,每天还在增加。我们讲讲自己的做法:先登记每份文件在哪、内容是什么、有没有变,再让不同的 AI 从同一个入口去找。
这位读者告诉我们,他们每天还要新增五百份左右,我们分享的这套方法很贴合他们的场景。
文件多的企业,常常还有另一层困扰:资料一直有人写,AI 也越用越多。销售用一个助手找报价,设计用另一个助手查旧方案,每个助手都要重新认识一遍目录。过几天文件更新了,大家又得判断手上的资料还对不对。
我们做 Local Context Engine(本地上下文引擎,简称 LCE),关注的就是这些材料怎样持续进入人和 AI 的工作。围绕这个问题,我们采用了一组相互配合的机制:登记文件的位置和内容身份,追踪变化,把业务叫法翻译成查询,再用文件之间的关系帮助继续查找。
这些机制可以从现有共享盘起步。下面用“找一份开瓶器效果图”这个例子,讲讲我们为什么这样组织它们。
先让 AI 找得到原件,再逐步理解业务
“帮我找一下上次做过的开瓶器效果图。”人听到这句话,可能会想到某位客户、某个产品系列,或者设计部常用的目录。AI 面对的却可能是年份文件夹、英文缩写和一串产品代号。它缺少的是从这句话走到那份文件的路。
如果每次都让 AI 从共享盘根目录开始读,文件越多,重复查找越多。于是我们先在原文件之外建立可查询的登记:文件在哪里、来自哪个目录、什么时候检查过、有哪些内容能搜到。查询先经过这层登记,找到候选后再打开原件。
这给企业留出了一条渐进的建设路径。原来的目录可以继续使用,同事也可以照常保存文件;先让常见查找变得顺手,再把反复遇到的客户、产品和版本关系整理出来。
有些企业已经需要完整的业务对象和操作规则。例如,订单状态改变后应该触发什么动作,哪些角色可以执行。这是本体建模很有价值的地方,Palantir 的 Ontology 就把对象、关系和业务动作组织在一起。[1] 对于眼下最想解决“资料在哪里”的团队,可以先把材料入口建好,等具体业务需要出现时,再加深那一部分结构。
同一份内容,可能有三个有用的位置
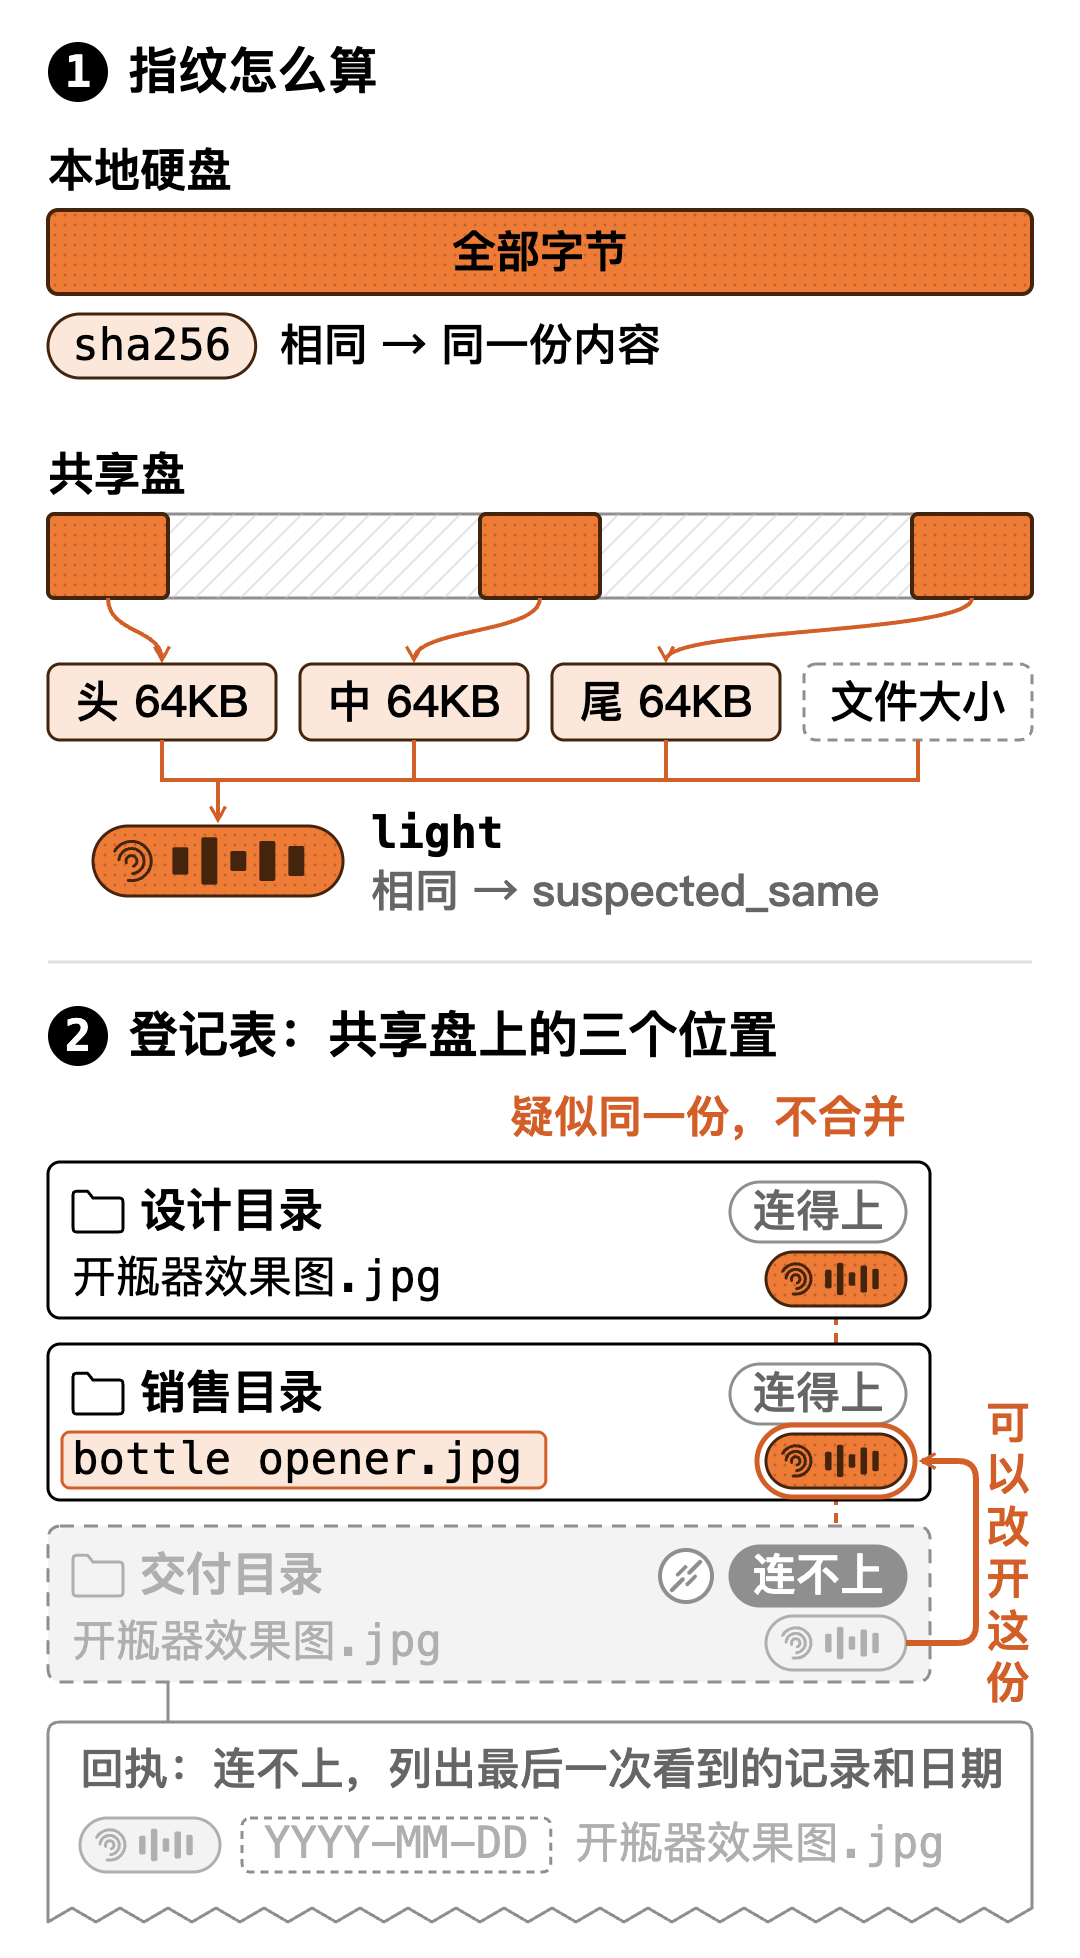
假设那张效果图同时出现在设计目录、销售目录和客户交付目录里。三份内容一样,但三个位置各有用途:设计同事沿用工作目录,销售同事打开自己能访问的副本,交付目录则保留当时发出去的材料。
所以我们把文件的“位置”和“内容身份”分开保存。位置记录它出现在哪里,内容身份用指纹表示。本地硬盘上的文件按全部内容算指纹,指纹相同就是同一份内容。共享盘上不读整份文件,只用文件大小加开头、中间、结尾三小段算指纹,这样的指纹相同,系统只标成“疑似同一份”,不直接合并。把位置和内容身份分开,既能保留每个来源,又能为减少重复处理提供依据。
这层登记还承担一件很日常的事:记住共享盘是否连得上。网络盘临时断开时,扫描器保留已有文件记录,并登记来源离线。连接恢复后,再继续检查变化。否则,一次网络故障就可能让整批资料在搜索里突然“消失”。
对使用者来说,这种区别直接影响下一步行动。看到来源暂时离线,可以等连接恢复或选择另一个副本;文件夹被搬走或改了名,按旧路径或旧名字去找,系统会注明“原来在哪、现在在哪”。一个笼统的“没有结果”,给不了这些线索。
把每天的变化接进来,减少旧文件的重复读取
共享盘中,大部分文件在两次检查之间没有变化。我们的扫描器先比较文件大小和修改时间:记录未变、内容指纹也已经存在,就跳过内容重读;发现变化,再处理相应文件。
这个顺序把较重的读取工作集中到了变化部分。尤其是大文件,少读一次正文就少了一次实际的磁盘和网络传输。维护程序仍会遍历目录、检查元数据,因此共享盘的目录结构和网络访问速度也会影响一轮检查需要多久。
沿着这条链继续看,更新成本还会出现在文本提取、全文索引和关系图中。我们最早的版本每次都把全文索引和关系图整个重建一遍。后来 PDF、Office 文档和图片里的文字提取接进了扫描流程,全文索引也改成只补新抽出的文字和有变化的文件名,免得前面只读了少量变化,后面又重做全部索引。关系类的汇总视图现在仍是整体重建,重建期间查询先读旧的那一份。
这也是“每天新增五百份”带来的一个具体设计问题:怎样让这五百份进入查询,同时照顾修改、移动和暂时离线的旧文件。增量维护要沿整条处理链考虑,才能把减少重复读取的收益传递下去。
把同事的叫法,接到文件里的叫法上
文件已经登记,搜索仍可能落空。同事输入“开瓶器”,文件名写的是 bottle opener;同事说“效果图”,目录里用的又是另一个习惯表达。
我们在全文检索前加了一层业务词处理,统一常见写法,并扩展同义表达。“开瓶器”和“效果图”分别形成一组查询条件,每组容纳对应的不同叫法,再按一份文件对上几组来排先后。企业已有的产品别名和缩写,在这里就能发挥作用。
全文检索用的是 SQLite 的全文索引(FTS5 的 trigram 模式),它按连续三个字符切开来匹配,所以只记得文件名或正文里的一截也能搜到。可企业材料里常有“PI”这样只有两个字母的短词,凑不满三个字符。这类词单独搜时,改由数据库的 LIKE 查询在文件名和路径里兜底;和别的词一起搜时,只给已经找到的候选加分。[2]
找到候选之后,还要决定先给人看哪一份。文件名就叫“开瓶器效果图”的材料,通常应当排在一份正文偶然提到开瓶器的长表格前面。我们的排序因此区分文件名、路径和正文命中,再结合 BM25(搜索引擎常用的一种相关度打分)等分数组织结果。
两个词不一定同时出现在同一份文件上。现在的检索不把它们当成硬门槛,而是把各路找到的候选合在一起排序:像“开瓶器 效果图”这样的找图查询,路径里对上“开瓶器”的整体排在前面,其中同时对上“效果图”的再往前提。每条结果还标着它是经哪一路检索找到的。没对上“效果图”、只对上“开瓶器”的文件也留在结果里,AI 就可以继续问一句“找到同系列的图,要不要看看”,或者沿某个产品目录缩小范围。查询由此有了可以接着走的分支。
业务词也值得逐步整理。产品的中英文名称可以是同义词,同系列的两款产品则适合保留为关联词。前者帮助直接命中,后者帮助在找不到目标时发现邻近材料。把这两种关系分开,搜索就更容易贴近同事实际找东西的习惯。
找到一份文件之后,顺手找到它的上下文
效果图找到了,接下来常常还会问:“有同系列的吗?”“这个客户后来改过哪一版?”“配套报价在哪里?”此时,继续返回一长串文件名,就不如把相关材料组织到一起方便。
我们先从目录结构里认客户:存放客户资料的那个文件夹,下面按国家、客户分好了子文件夹;我们直接把每个客户的子文件夹当成这个客户的目录。问到某个客户,就把这个文件夹里的文件拿来当候选;问“有哪些客户”,就列出每个客户的文件数和最近一次修改的日期。每条结果都带着出处和完整路径,需要确认时能回到原文件查看。
文件名里的 v3 只是一条线索;要知道哪一份已经发给客户,还得看交付记录或确认信息。两种线索各自回答一个问题,组合起来才贴近实际工作。
这种关系图可以随使用逐步生长。先整理经常被一起查找的材料;如果某种关系反复影响交付,再给它增加明确的业务含义和确认方式。团队花在建模上的精力,就能跟着真实需求走。
换一个 AI,继续使用同一套材料入口
当文件登记、业务词和关系导航有了共同入口,维护工作就可以被不同工具复用。现在这个入口就是一条查询命令。AI 助手找文件时调用它,拿回候选、完整路径,以及每条是经哪一路找到的,再按需打开原件;从另一台电脑发来的查询,也交给同一段查询程序处理。
这使材料整理与模型选择能够分别推进。换一个助手,不必跟着重新设计目录、整理一遍产品别名。不同助手可以承担各自擅长的工作,共同依赖一套持续维护的材料入口。
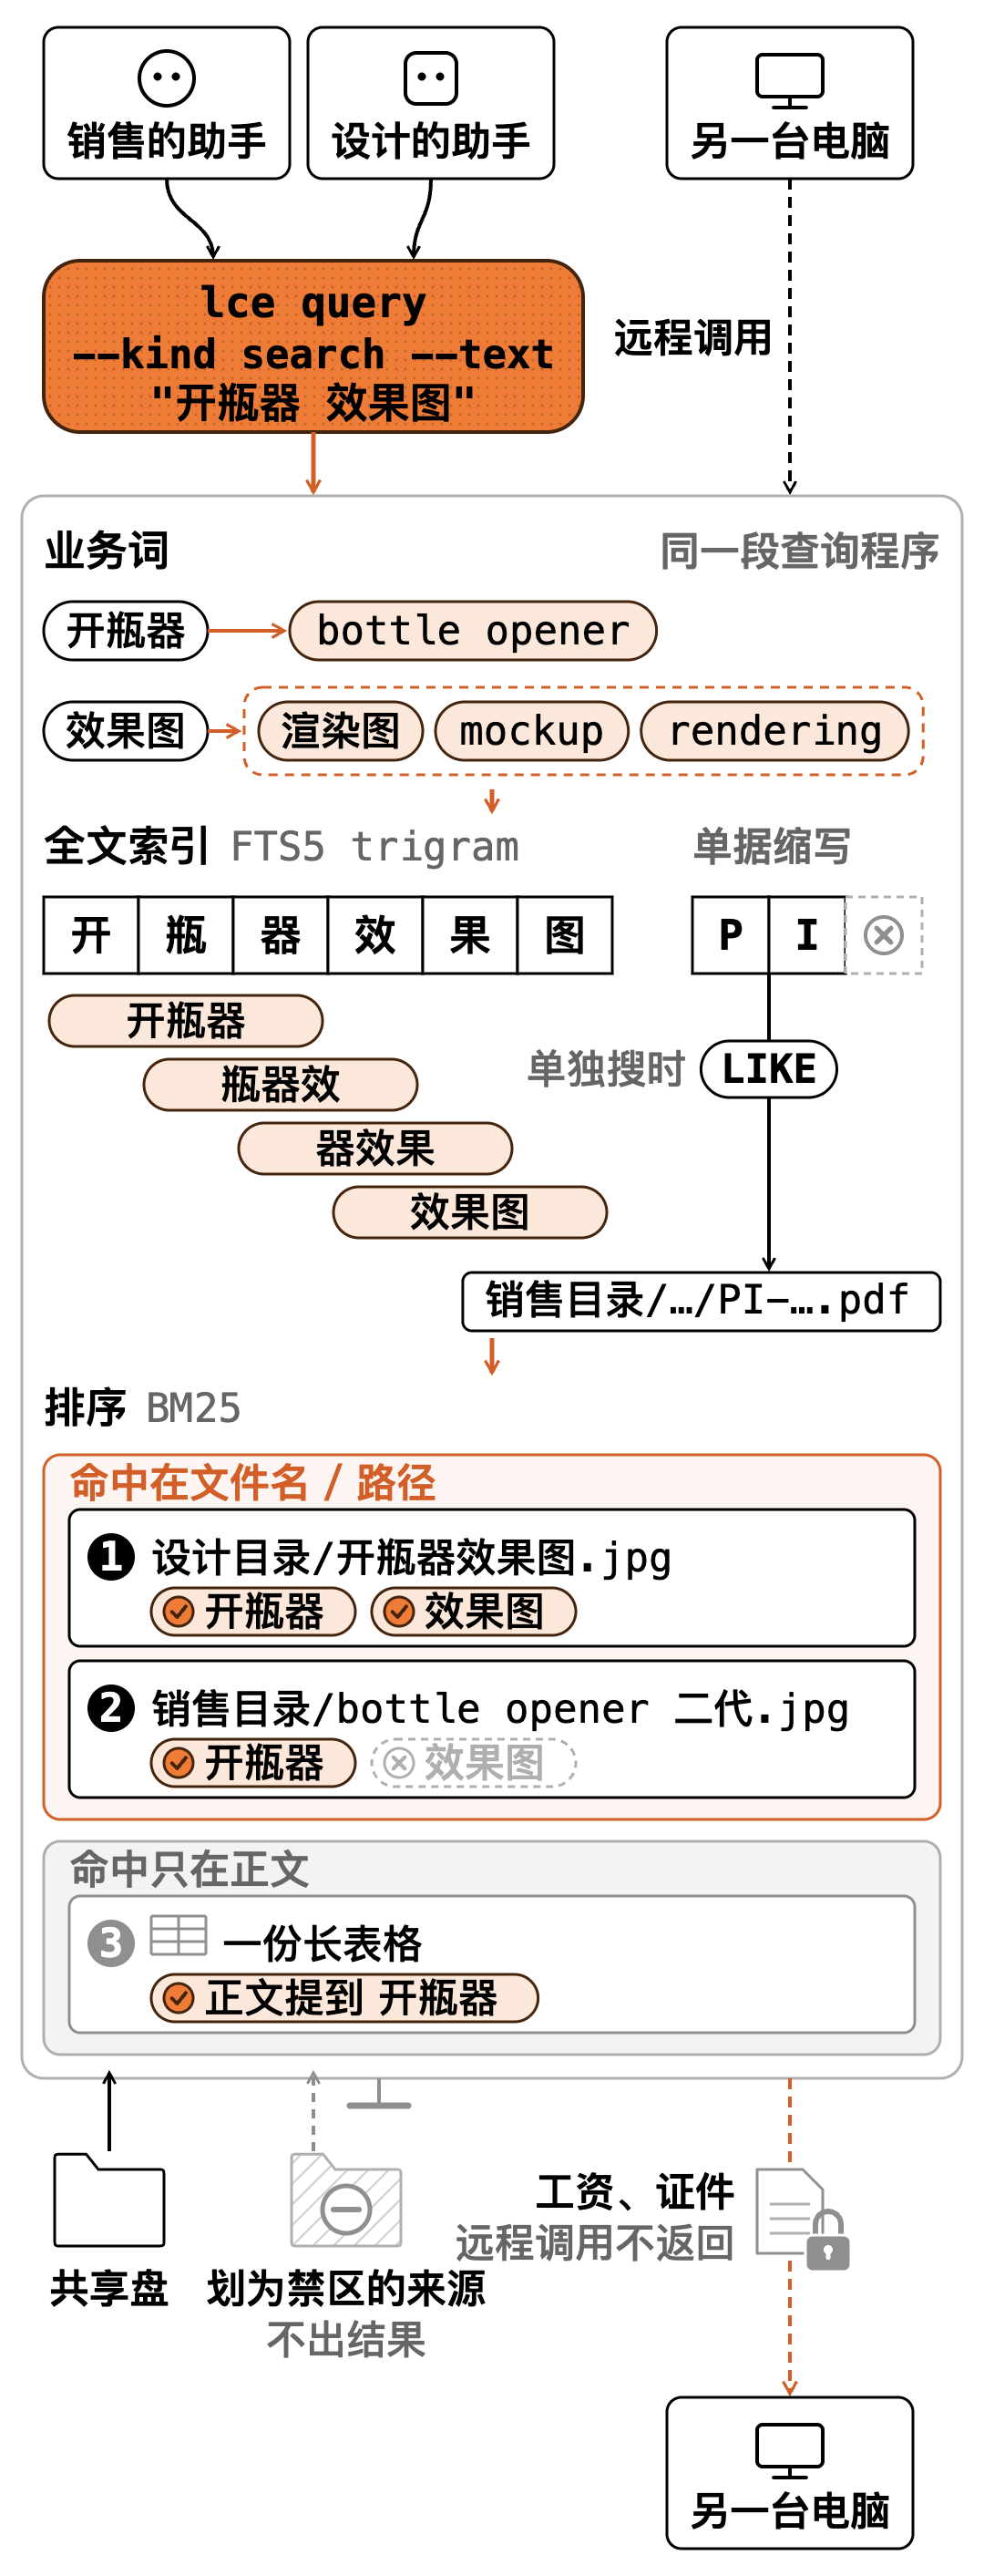
落到企业使用中,接入还要沿用原来的资料访问范围:谁来查询、能看到哪些结果、能否打开原文,需要在工具入口一起处理。这样销售与设计可以共用检索能力,同时各自使用工作中可访问的材料。我们现在的版本做到的是,划为禁区的来源不出结果,工资、证件这类私人材料在远程调用时不返回;按每个人的权限区分可见范围,还没有接上。
AI 写出来的东西也需要一个清楚的去处。我们的做法是把 AI 助手的工作目录也当成一个来源扫进来:对话记录、生成的图属于上下文,照常登记;缓存、临时文件这类运行时产物整个跳过,凭据文件一律不打开。实际使用时,可以把工作草稿与正式资料分开保存,再给确认后的产物设置登记入口。下一位同事或 AI 查找时,便更容易知道拿到的是一份建议稿,还是团队已经采用的文件。
从同事每天找的那几份材料开始
如果正在面对六十万份文件,可以从一组反复发生的查找开始:旧方案在哪里,某个产品还有哪些叫法,客户最后收到的是哪一份,刚更新的资料什么时候能搜到。
这些问题能帮助团队决定先整理什么。叫法对不上,就补业务词;候选太散,就改善排序和关系导航;更新跟不上,就沿扫描、提取和索引逐段找耗时。每一次调整都有一个可以回到日常工作中检验的用途。
我们希望 LCE 带来的体验,就是同事问“上次那份开瓶器效果图在哪里”时,AI 能给出可打开的候选,说明命中的线索,并陪他继续找到相关版本和配套资料。
参考资料
[1] Palantir Foundry 文档“The Ontology system”。
[2] SQLite 官方文档“FTS5 Extension”。