No comparative winner
The 2026-08-01 settlement recorded zero fair-comparison runs and winner = NONE. Sovereign A2A is not established as universally superior to centralized coordination.
TOWOW RESEARCH · FORMAL PAPER · PUBLIC DERIVATIVE
A theory, protocol, and operating system for generative coordination among super-individuals and one-person companies
A readable, downloadable, and checksum-verifiable historical research record. The public derivative keeps the theory and evidence boundaries while removing executable protocol specifications and internal implementation symbols.
READ THIS FIRST
The 2026-08-01 settlement recorded zero fair-comparison runs and winner = NONE. Sovereign A2A is not established as universally superior to centralized coordination.
The two lines may be combined, but public evidence does not establish an integrated, accepted product stack.
The production stack, minimum implementation order, and product-value discussion are research designs—not claims of deployment or adoption.
Tables and figures must travel with their generator, evidence level, and limitations; isolated screenshots or metrics are misleading.
Section 20 is a single-coder historical-process construction, not a customer sample or estimate of product effects.
Durable delegation, a complete RelationEpisode, net value, legal or physical effects, and power externalities are not established.
Archived v1.1 SHA-25642b3c6fa1da3a56ce07a20be6283d1efcfa4b15e9069b84d0634934067f86b6c
START BY QUESTION
Start with Attempt, Effect, Adoption, and Acceptance, then inspect two bounded Harness studies.
Start with a developer who is stuck and see how revising the question opens a new path to action.
See how specific scope, authority, and traceable evidence make a decision executable and reopenable after change.
Go directly to the ZIP, manifest, file-level SHA-256, citation metadata, rights boundary, and public research data.
FULL TEXT · CHINESE
当大模型和 Agent 从信息处理工具转变为能够调用账户、调度资源、生成承诺并影响现实状态的行动主体时,协调问题不再只是消息互通、任务编排或多 Agent 分工。真正困难的情形是:参与者分别拥有持续变化且不可被中心无损复制的私有世界,具有彼此不同的工具、资源、责任、利益和权威;任务、角色、可行动作、可接受条件与评价标准也未必预先存在。在这种条件下,系统必须回答的不仅是“谁能完成一个已知任务”,而是“多个不可相互替代的主体如何发现原本不可见的关系,构造新的联合行动空间,并把候选可能性逐步推进为可理解、可认领、可授权、可承诺、可执行、可验证、可采用、可接受和可结清的共同事实”。
本文提出一套面向该问题的统一理论与系统:主权代理操作系统。其研究对象不是单个模型或某一通信协议,而是一个对外具有连续身份、认证边界和责任归属,内部却可由人、组织角色、多个模型、工具、账户、工作流和不可数字化判断共同构成的 Agent Entity。本文首先区分 Principal、Agent Entity、Authority Locus、Mandate、AgentExecution 与 Sovereign World,证明静态公共画像无法普遍充分表示开放任务中的未来行动空间,并以任务相关的交互式边界作为更弱、更可实现的充分性目标。随后,本文将“搜索”扩展为“行动构成”:通过 Coordination Schema、版本化共同协调介质、可能性形成、能力兑现、范围化认领、承诺、现实效力和局部编译,形成一条从私有世界到共同现实的完整生成链。
理论上,本文建立三个相互嵌套的循环:语义构成、可行域发现和规范闭合;给出合格联合行动空间、关系模式物质性、CollapseSafe、局部稳定与依赖闭包重开的定义;并提出十一项形式命题,包括静态投影非普遍充分、交互式边界在受限条件下的任务充分性、高阶互补下成对匹配的不完备性、能力与权威的正交性、可达性不推出现实可靠性、版本图对特定审计查询的表示优势、原子资源预留的并发安全性,以及局部编译与范围化重开的保持性质。
系统上,本文不把中心化与 A2A 设为二选一,而是把自执行、确定性服务、平台市场、中心优化、人类经纪、双边形成、临时联盟和人工裁决纳入同一机制组合器。A2A 的必要性来自不可被中心代行的权威拓扑,而非网络部署的分布式外观。对超级个体与一人公司而言,同一自然人经常同时承载品牌、预算、交付、数据、法律与生活角色,因而“一个人、一个 Agent、一个 Principal、一个权限”是不成立的;系统必须围绕外部责任根、多个局部权威和版本化委托运行。
证据上,本文统一重审多轮理论、合成机制实验、参考实现、真实仓库审计、真实模型协商、跨技术权威域闭环、公开制度过程、52 份去标识化访谈、盲化历史诊断和 OPC 构造压力测试。结果表明:任务自适应边界可在显著减少披露的同时维持合成可行性;概率低熵与高置信并不排除系统性错误;未经原子预留的并发承诺会产生高频超卖;ActionAttempt、Effect、Adoption 与 Acceptance 的显式分离能修正真实仓库中的终态误判;真实模型多轮协商可增加规范条件,却不必然形成新能力;现实 probe、权威拒绝、最小反条件、目标域 readback 与恢复路径能够在技术域内形成此前不存在的可运行关系。公开过程和 QDR 材料进一步表明,类似顾虑并不唯一决定协调机制,Declared Schema 与 Enacted Schema、Authority 与 Standing、技术稳定与治理稳定必须分开。
在 v1.1 中,本文进一步建立一个面向 OPC 的公开历史过程语料、可执行权威内核、形式状态模型和强基线构造实验。公开语料包含 20 个案例与 59 个过程事件,其中 18 个为一手访谈转录、2 个为低保证前沿自报;其主要用途是区分责任根、能力图、机制组合、编译资产和重开风险,而非估计总体频率。可执行内核把 Mandate、精确 RelationVersion、资源容量、Commitment、Operation、目标域 Effect 与 Acceptance 置于同一状态机;17 项单元测试通过。有界探索在正确模型中遍历 374 个状态和 1,084 个转移,未发现所列安全违规,而九类注入错误均产生反例。OPCBench 以 24 个理论构造案例比较固定平台、扁平中心 Agent、权威感知中心、联邦关系系统和组合 Router,并通过 formation、local Oracle、Effect witness、撤销和编译复用消融,明确区分语义价值、拓扑价值、形成价值和复用价值。上述结果仍属于历史校准、E1/E3 形式—工程证据和理论构造压力测试,不构成现实成功率。
本文不声称已经证明真实 OPC 会授予 Agent 高权委托,也不声称该系统已优于优秀人类经纪或成熟平台。当前最强结论是:已经形成一套能够区分候选、能力、权威、承诺、效力、采用和接受,能够组合多种协调机制,并能够将未知转化为建设性形成动作的理论—协议—运行框架;其剩余的决定性证据门是前瞻性的真实 Principal 委托、长期接受、净价值和权力外部性。本文同时给出可证伪实验设计、正式对象、状态机、不变量、证据等级和完整的历史概念处置,以使后续研究在同一篇论文中持续累积,而不再以摘要式“统一”丢失已有成果。
关键词: Agent Entity;主权世界;生成式协调;共同现实;一人公司;超级个体;关系模式;授权;承诺;现实效力;多机制协调;Agent-to-Agent
As large language models and autonomous agents gain the ability to invoke accounts, allocate resources, issue commitments, and change external states, coordination can no longer be reduced to message interoperability, workflow orchestration, or task allocation among pre-specified agents. The difficult cases arise when actors possess large, evolving, and non-collapsible private worlds; when authority, responsibility, tools, incentives, and risk remain locally held; and when the task, roles, feasible actions, admissible evidence, and acceptance criteria are themselves not fully specified in advance. The central problem is therefore constitutional rather than merely computational: how can non-substitutable actors discover previously invisible relations, construct new joint-action possibilities, and progressively turn them into claims, mandates, commitments, effects, adoptions, acceptances, and settlements that have both normative and real-world force?
This paper develops a unified theory and system, termed a Sovereign Agent Operating System, with an initial focus on super-individuals and one-person companies. An Agent Entity is treated as an externally continuous, addressable, and accountable instance whose internal composition may include human principals, organizational roles, multiple models, tools, accounts, workflows, and non-digitizable judgment. We distinguish Principals, Agent Entities, Authority Loci, Mandates, Agent Executions, and Sovereign Worlds; show why fixed public profiles cannot be universally sufficient for open-ended tasks; and replace universal representation with task-relative, interactive boundary sufficiency. We then formulate coordination as joint-action constitution through a versioned coordination schema, a shared but non-sovereign artifact, possibility formation, capability realization, scoped recognition, commitment, target-world effect, and local compilation.
The framework contains three coupled loops—semantic constitution, feasible-region discovery, and normative closure—and a portfolio router spanning self-execution, deterministic services, platform markets, centralized optimization, human brokerage, bilateral formation, temporary coalitions, and human adjudication. The need for A2A is determined by authority topology rather than network topology. Evidence from synthetic mechanisms, repository-grounded execution, real-model negotiation, cross-domain technical formation, public institutional traces, a 52-interview qualitative archive, time-censored diagnosis, and OPC stress fixtures is re-evaluated under a common claim–evidence–design-delta standard. The evidence supports several scoped invariants but does not yet establish superior real-world value or durable human delegation. Version 1.1 adds a public OPC process corpus (20 cases and 59 process episodes), an executable authority kernel, a bounded formal model, and a constructed strong-baseline benchmark. The corrected abstract model explored 374 states and 1,084 transitions without violating the enumerated invariants, while nine injected mutations each yielded counterexamples. A 24-case OPC benchmark separates semantic, topological, formation, and compilation effects; because the fixtures and utility functions are theory-authored, those scores are treated as executable consequence tests rather than estimates of real-world superiority. The paper concludes with a falsifiable research program for real OPC cases and supplies the formal objects, state machines, invariants, evidence ledger, and concept genealogy required for cumulative development.
Keywords: sovereign agents; generative coordination; joint-action constitution; one-person company; authority; mandate; commitment; effect; acceptance; multi-mechanism coordination
本文是一篇正式、统一、可审查并持续累积的研究论文,而不是产品路线图、项目提案或阶段汇报。它承担四项职责:第一,重建完整理论而不是只保留最新术语;第二,把多轮实验按统一证据标准重新解释;第三,给出从形式对象到运行系统的可实现结构;第四,明确哪些主张已经建立、哪些仅获得限域机制证据、哪些仍然开放。
本文使用如下主张标记:
正文中的“系统应当”“必须”通常表示设计不变量,而不是已经被现实统计证明的普遍规律。所有精确实验数字均应连同生成器、基线和适用边界阅读。合成实验样本量很大,不会自动升级为现实证据;公开档案过程完整,也不会自动恢复主体未公开的私有世界。
\newpage
在传统软件系统中,程序通常在预先定义的数据库、接口、权限和业务流程中执行;在经典多 Agent 系统中,参与者、通信语言、任务结构、效用函数或至少动作集合通常由建模者提前给出 [1–5]。大模型改变了其中一部分:它们能够理解非结构化语境、生成候选计划、调用工具、与人交互,并在相当宽的任务分布中完成此前需要专门程序的工作。然而,理解力和生成力的增加没有自动消除协调稀缺,反而使一个过去被软件边界掩盖的问题变得更明显:模型可能知道“可以怎么做”,却不因此拥有决定权;系统可能完成一次动作,却不因此产生了被目标世界承认的 Effect;接收方可能技术上采用结果,却不意味着相关 Principal 已经接受;多个主体可能各自很强,却仍然缺少一条可被共同认领和承担责任的联合路径。
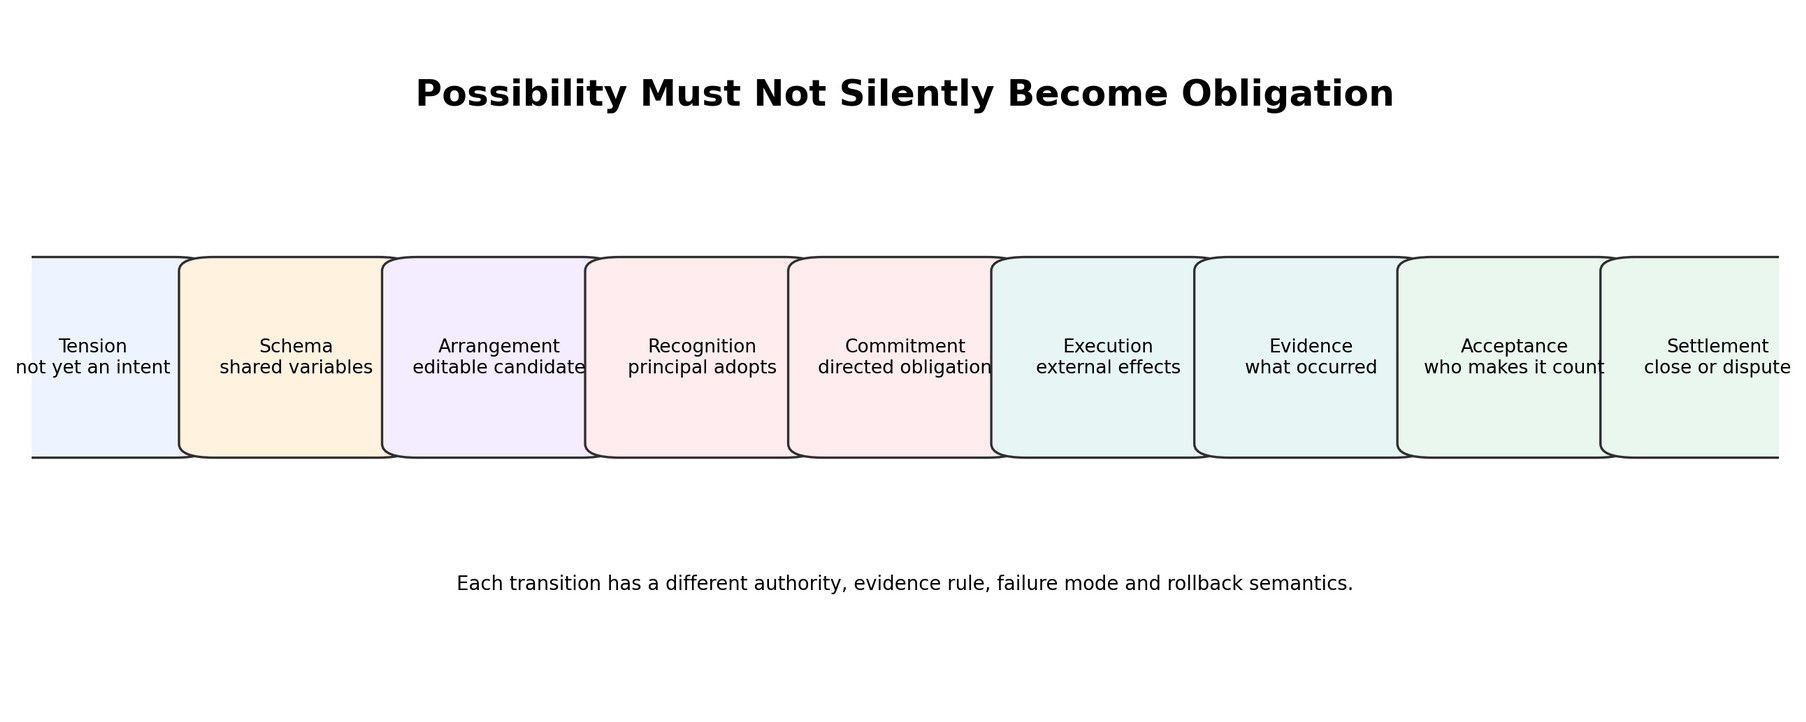
因此,未来 Agent 系统的关键瓶颈并不只在模型推理质量,而在于以下转换是否成立:
[ \text{可能性} \rightarrow \text{能力} \rightarrow \text{权威} \rightarrow \text{承诺} \rightarrow \text{现实效力} \rightarrow \text{采用} \rightarrow \text{接受}. ]
任何一步被错误折叠,都会制造一种“看起来已经完成”的假现实。例如:模型生成了一个价格方案,不等于销售主体授权该报价;自动化脚本返回退出码 0,不等于目标系统状态已改变;API 返回成功,不等于业务采用;一个人没有反对,不等于他理解并认领了具体版本;两个 Agent 达成文本一致,不等于各自背后的主体拥有实现条件。
本文把研究问题定义为:
当不同的人、Agent、组织和系统拥有巨大且持续变化的私有世界、独立工具与资源、不可被中心代行的权威和责任,而任务、角色与条件又未被预先完整定义时,它们如何形成一种新的共同可行动性,并把它推进为能够进入现实的共同事实?
“共同”不表示所有主体拥有同一份世界模型。更现实的目标是:各主体保持本地世界和解释主权,只在具体行动所需要的部分形成可相互引用的声明、条件、授权、承诺、效力和接受关系。本文因此使用“联邦式共同现实”而非“全局共享真相”。
该问题包含三个由浅入深的层级:
现有 A2A Protocol 主要处理相互独立 Agent 之间的发现、消息、Task 和 Artifact 交换 [6];MCP 主要处理模型或 Agent 对工具、资源和数据的连接与授权 [7];可验证凭证、OAuth 与新近的 Agent 委托草案处理身份、声明和任务绑定授权 [8–11]。这些都是本文系统可采用的组件,但并不自动解决“联合行动对象本身尚未形成”的上游问题。
超级个体和一人公司(one-person company, OPC)是本研究当前最合适的第一类现实主体,而不是理论的最终边界。它们同时具备两种性质:外部责任集中,内部行动结构却高度复数。一个人可能同时以公司所有者、品牌主体、产品经理、销售、交付者、预算权威、数据控制者、账户持有人和法律责任人的身份行动;其内部还可能运行多个模型、自动化工作流、外包团队和临时合作伙伴。传统的“一个用户—一个账户—一个权限角色”无法描述这种结构。
本文提出:OPC 的基本单位不是“一个自然人”,而是一个**外部责任根(responsibility root)**及其内部多个 Authority Locus。一个日程 Agent 可以替本人安排普通会议,但不能因此代表品牌签署联名合作;一个交付 Agent 可以调用代码仓库,却不能改变报价、把客户数据用于训练,或替本人接受争议结论。模型越强,这种区分越重要:能力增长扩大了执行可达性,却不自动扩大委托边界。
OPC 还具有实验优势。与大企业相比,其流程更短、决策权更集中、真实事项更容易执行;与纯个人任务相比,其现金流、信誉、数据、客户和法律后果又足够真实,能够暴露授权、资源预留、交付和接受问题。若一套系统无法在 OPC 中减少注意力负担、形成新的可执行关系并保持责任边界,它更难在大型组织中成立。
本文的贡献不在于首次提出 Agent、承诺、权限、合同、边界对象或多中心治理。这些概念分别已有成熟研究传统 [2–5, 15, 19–22, 32–37]。本文尝试建立的是它们在开放世界 Agent 协调中的一套统一依赖结构与运行闭环。具体包括:
本文不宣称:
本文当前最强的现实边界是:已经证明若不区分权威、效力和接受,系统会在真实代码和跨域技术闭环中产生可观察错误;已经证明部分形成机制能够在技术权威域内创造新可运行路径;尚未证明真实 OPC 在长期使用中会授予精确 Mandate,也尚未证明组合机制相对强基线的净价值。
第 2 节说明研究方法和证据等级;第 3 节定位相关工作;第 4—13 节依次重建主体、边界、三维统一模型、行动构成、可能性形成、能力资格化、权威、现实效力、编译运行和多机制协调;第 14—15 节将理论专门化为 OPC 操作系统并给出协议架构;第 16 节形式化主要命题;第 17—19 节统一呈现历史实验、公开制度和 QDR 证据;第 20 节给出 OPC 公开过程语料;第 21 节给出可执行语义与有界模型检查;第 22 节给出强基线、消融和编译复用压力测试;第 23 节给出前瞻性真人实验方案;第 24—28 节综合 Design Delta、经济价值、权力安全、可证伪边界和结论;附录提供对象、状态机、实验账本、概念谱系、数据标准和内容回收审计。
本研究经历了协议设计、语义坐标、边界预言机、生成式协调、能力保障、Harness、现实效力审计、真实模型谈判、跨技术域形成、公开制度过程、QDR 访谈重分析和 OPC 机制构造等多轮工作。若按时间顺序汇编,读者会看到许多术语,却难以判断它们解决的是同一问题的不同层,还是彼此竞争的理论。更严重的是,后续证据经常限定早期主张:NAC 的发现接口仍有价值,但不能承担普遍语义本体;R5.4 证明多轮模型协商能生成丰富条件,却不能证明能力形成;R5C 证明技术域路径可被构造,却不能替代真实 Principal 认领。
因此,本文以问题依赖而非历史阶段组织材料,并为每项主张维护五元组:
[ \mathcal{C} = \langle statement, scope, evidence, alternatives, design\ delta \rangle. ]
其中 statement 是可检验陈述,scope 指适用域,evidence 指当前最高证据等级,alternatives 是尚未排除的竞争解释,design delta 是该证据实际改变的系统结构。没有 Design Delta 的实验可以增加形式完整度,却不应自动升级为核心科学贡献。
本文采用 E0–E7 的证据阶梯:
| 等级 | 类型 | 能够承担的主张 | 不能承担的主张 | |---|---|---|---| | E0 | 概念与定义 | 术语一致性、对象边界 | 现实有效性 | | E1 | 形式推导、反例、模型检查 | 在假设内的不可能性、保持性质 | 现实频率、用户价值 | | E2 | 合成机制实验 | 机制能否区分、参数敏感性 | 现实分布、社会接受 | | E3 | 参考实现与状态机验证 | 可实现性、接口一致性、已建模不变量 | 生产安全、商业价值 | | E4 | 真实仓库与历史轨迹 | 真实系统中的失败模式和修复 | 人类委托、一般化收益 | | E5 | 跨技术权威域闭环 | 多域 Effect、Adoption、revoke、recovery | 真实 Principal 认领 | | E6 | 真实模型 Agent 互动 | 模型协商行为、语言形成能力 | 主体授权与净价值 | | E7 | 真实 Principal 与生产结果 | 认领、委托、接受、长期价值 | 超出样本和场景的普遍规律 |
该阶梯不是把形式证据排在现实证据“下方”,而是防止不同证据类型互相冒领。一个严格定理可能比小样本用户实验更可靠地证明某个不可能性;但它不能回答用户是否愿意接受系统。一段真实运行轨迹可以证明某个 Effect 的确发生,却不能证明机制在所有情形下更优。
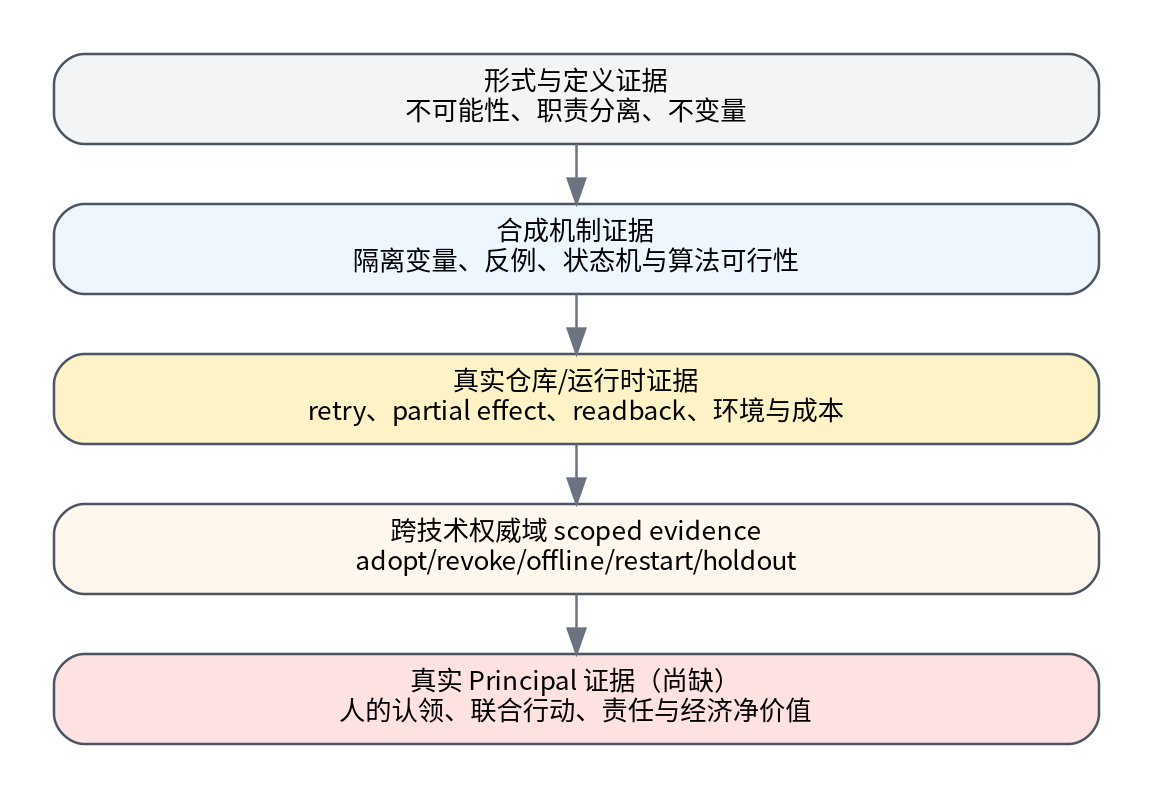 {width=82%}
本文使用六类资料:
分析单元不是“文档”,而是主张、事件、RelationVersion、Authority Locus、Effect、Acceptance 和 Design Delta。公开案例中的事实由正式来源支持,但对其进行 Relation Schema 编码仍属于本文分析,不应与原始事实混同。
每组实验按以下顺序报告:
这一模板专门防止两种常见错误:把测试通过写成理论成立;把大规模合成数据写成现实频率。
概念是否成为顶层协议对象,不取决于它是否“重要”,而取决于它是否需要独立的:
在此标准下,当前 canonical aggregate roots 维持六类:Entity、Mandate、RelationVersion、Assertion、Commitment、Operation。DataUseEvent 是事件,Derivation 是溯源边,Acceptance 是针对精确 Effect 和 RelationVersion 的 Stance,Settlement 是派生状态。只有当联合制品权利需要独立签发、修改、执行、撤销和争议时,才提升为 Commitment,而不是默认增加 JointArtifactRights 根对象。
本研究对三类缺口作显式处理:
reported synthetic evidence,不以样本量提升等级;论文随附实验账本、对象 Schema、状态机、参考实现说明、内容损失审计和文件 Manifest。正文足以独立理解主张,附件用于复现和追溯,而不是替正文承担论证。
〔公开版编者按〕 本公开版仅保留对象与参考实现的概念性摘要;可直接执行的字段级 Schema、接口签名与内部符号映射已移除,逐项位置和理由见随包
REDACTIONS.md。
经典多 Agent 研究已经讨论共同计划、意图、通信语言、组织角色和社会承诺 [2–5]。Grosz 与 Kraus 的 SharedPlans 说明复杂群体行动需要对计划结构、子行动和参与者能力进行递归表示 [2];Singh 和 Chopra 等强调 Agent Communication Language 不应只依赖心理状态,而应以可观察社会承诺组织问责 [3–4]。本文继承两点:联合行动不能被降为消息序列;承诺的意义来自参与者之间可观察、可追责的规范关系。
本文的差异在于:多数经典模型仍由建模者预先提供角色、目标、动作、协议或承诺类型。本文研究更上游的开放情形,即这些对象本身如何在多个主权世界之间被构成,以及模型生成的候选如何获得真实主体的认领、资源和目标世界 Effect。
A2A Protocol 提供 Agent Card、Message、Task、Artifact、状态更新和长任务交互 [6];MCP 提供模型到工具、资源和提示的统一连接,并在授权规范中处理客户端代表资源所有者访问服务端资源 [7]。W3C Verifiable Credentials 2.0 提供可验证声明的发行、持有与呈现模型 [8]。IETF 在 2026 年的草案中开始讨论 Agent 身份、任务绑定授权、Mandate JWT 和委托链衰减 [9–11]。
这些标准能作为本文系统的连接器和凭证层,但需要严格区分:
本文的协议内核因此位于这些标准之上:它不替代传输、工具连接和身份凭证,而是把它们装入 RelationVersion、Mandate、Commitment、Operation 和 Effect 的权威语义。
信息瓶颈研究考察在保留任务相关信息的同时压缩输入 [12];Blackwell 实验比较信息结构的决策价值 [13];交互信息复杂度研究说明多方计算中所需披露与通信的下界 [14];情境完整性强调隐私取决于主体、属性、接收者、传输原则和社会语境,而非单一“是否公开” [15]。这些工作为本文的任务相关边界提供理论背景。
本文不假设存在一个对所有未来任务都充分的最小表示。相反,边界是一个互动过程:协调器提出任务相关问题,本地主体通过 ACCEPT、SEPARATE、WITNESS、COLUMN、UNKNOWN 或 REFUSE 之类的 Oracle 响应,逐步暴露可行动边界。重点不是交换越少越好,而是以最小必要披露获得足够的决策区分力,并保留拒绝与重构能力。
Benders 分解、Dantzig–Wolfe 列生成和反例驱动归纳综合(CEGIS)提供了一个重要构造范式:中心主问题不需要复制所有本地细节,而可以通过局部子问题返回切割、可行见证或新列,逐步逼近可行解 [16–18]。本文的 Boundary Oracle、PFE 和 CRA 借用了这一结构,但不把社会主体假设成诚实的凸优化 Oracle。现实响应还可能是拒绝、语义异议、权限不足、未知或策略性隐藏。
因此,本文使用“分解式行动构成”而不是“社会问题等价于 Benders”。数学分解提供接口直觉;权威、认领和责任仍需独立建模。
Matching with Contracts 将匹配和合同条款结合,显著扩展了标准配对模型 [19–20]。Myerson–Satterthwaite 不可能性提醒我们,在私有价值、双边交易与激励约束下,不可能同时实现所有理想性质 [19]。本文据此拒绝一种幼稚假设:只要 Agent 交换足够信息,就能诚实、有效且公平地形成所有合作。
差异仍在于,合同集合、角色和选择函数往往被预先定义。本文更关注合同语言、参与者、能力组合和接受标准也可能通过探问、现实试验和反条件逐步出现的情形。机制设计的限制被转化为系统要求:证据、声誉、验证、风险共担、退出、第三方 Standing 和人工裁决必须能够进入同一协调过程。
Ostrom 的多中心治理表明,复杂公共问题不必由单一中心规则解决,不同层次的主体可以在相互嵌套的规则与权威中协调 [21];Institutional Grammar 提供规则陈述的结构化分析 [22];Boundary Object 研究说明不同社群可以围绕一个足够可塑又具有共同身份的对象协作,而不必共享全部解释 [37]。本文的 Institutional Frame、Relation Schema 和 JAA 与这些传统有明显亲缘关系。
本文不声称首次发现制度语法或共同对象。其目标是把它们与 Agent 的动态委托、工具调用、能力资格化、现实 Effect、局部编译和可验证事件账本连接起来。共同协调介质不是全局真相,也不是平台所有的数据表;它保存的是各主体愿意对外承担的版本化主张、条件和 Stance。
线性一致性、分布式快照、Saga、协调避免、CRDT 和 end-to-end arguments 研究如何在并发、故障和部分信任下维持系统语义 [23–28]。本文直接继承以下工程结论:
语义熵、风险控制预测集、自适应 conformal risk control 和 performative prediction 表明,模型置信、低熵和历史校准并不能保证在分布变化、反馈效应或系统性偏差下仍然可靠 [29–31]。本文因此把模型概率限制在认识平面:它可以排序候选、决定是否需要 probe 或人工复核,但不能自动产生授权、承诺或接受。
关于一人企业和独立劳动的研究指出,单人企业的成长受到个人能力、网络、资源和工作—生活边界的共同约束 [49–50]。Effectuation 进一步说明,创业行动并不总是在目标、资源和概率分布都已确定后进行最优化;行动者往往从当前可控制的手段出发,通过可承受损失、伙伴承诺和逐步试验构造下一步 [86]。Entrepreneurial bricolage 则显示,资源受限企业会把手边要素重新组合为新的用途;Baker 与 Nelson 的研究使用 29 家资源受限企业说明,相似客观环境并不推出相同资源构造路径 [87]。
这些传统与本文的“行动空间构成”高度相关,但仍需增加 Agent 时代的权威与现实语义:一个模型提出重新组合,不等于相关资源已经授权;一个外部伙伴被列入能力图,不等于其时间、质量、权利和退出已经承诺;一个 probe 成功,不等于目标域采用或 Principal 接受。本文的增量不是重新命名 effectuation 或 bricolage,而是把这些建设性创业过程连接到 Mandate、RelationVersion、资源预留、Effect、Acceptance、机制路由和编译复用。
平台型独立劳动还暴露另一面。OECD 基于多个欧洲国家的自由职业者、平台管理者和专家访谈,报告了平台关系中的合同透明度不足、议价能力受限和跨平台接触受限等不对称 [88]。因此,平台既可能是 OPC 的发现、支付、信誉和争议基础设施,也可能把平台目标、规则和数据边界置于参与者目标之前。本文不把平台排除在外,而把它作为机制组合中的正式组件,并要求 Router 区分平台何时足够、何时需要额外保留本地权威与退出。
从规模看,美国 Census 的 Nonemployer Statistics 将无付薪雇员企业作为独立年度统计对象;2023 年记录约 3,043 万个 nonemployer establishments、近 1.8 万亿美元 receipts [89]。这些统计不能与“Agentic OPC”直接等同,也不能证明单人组织更优;它们只说明无雇员经营主体不是边缘例外,值得被作为独立的系统设计对象。
本文在上述基础上进一步提出:Agent 使 OPC 的“组织边界”不再等于雇员人数。一个自然人可以通过多个 Agent、平台、外包和临时联盟形成高杠杆组织,但外部责任根仍可能集中在本人。这使传统公司中分散在部门、审批和岗位里的权威冲突,被压缩到一个人的多个角色和多个 Agent 之间。
综合来看,现有研究分别提供:互操作、工具连接、身份凭证、社会承诺、制度规则、优化分解、合同匹配、隐私语境、分布式状态与不确定性控制。尚缺的是一套贯通结构:
本文试图填补的正是这一系统性空缺。
定义 1(Principal)。 Principal 是一个能够在某一制度语境中产生原生认领、授权、拒绝、承诺、接受或申诉,并能够被归责的主体。Principal 可以是自然人、法人、组织、公共机构或经明确程序授权的集体;它不等于任何代表它运行的模型、软件进程或账户。
“原生”并不意味着 Principal 必须亲自点击每个按钮。它表示某个规范事实的最终来源能够追溯到相称的权威程序。例如,公司采购负责人可以通过预先批准的价格带授权 Agent 自动下单;此时单笔 Operation 由 Agent 执行,但其规范效力来自采购负责人的 Mandate。相反,模型从历史邮件推测“老板应该会同意”,并不产生授权。
Principal 具有三个不可由模型置信替代的属性:
定义 2(Agent Entity)。 一个 Agent Entity 记为
[ E = \langle E_{id}, E_{authority}, E_{execution}, E_{state} \rangle, ]
[ E_{id}=\langle id, roots\rangle, \qquad E_{authority}=\langle loci, mandates, policy\rangle, ]
[ E_{execution}=\langle executors, resources\rangle, \qquad E_{state}=\langle memory, provenance\rangle. ]
其中:
id 是外部可寻址的连续身份;roots 是身份、责任与权威的信任根集合;loci 是内部不同权威位置;mandates 是版本化委托;executors 是模型、工作流、人类和工具执行器;resources 是账户、预算、数据、工具和环境;memory 是局部历史和长期状态;policy 是本地规则与风险门;provenance 记录声明、委托和动作的来源。Agent Entity 是对外表现为一个可认证、可问责实例的边界,而不是规定其内部必须如何实现。一个 Entity 可以由单个本地模型组成,也可以是“一名创始人 + 多个模型 + 财务账户 + 外包网络 + 审批规则 + 线下判断”的复合体。
这一定义解决两个相反问题。第一,它避免把每个模型会话都当作独立社会主体;第二,它不要求把人的完整心智数字化。Entity 允许保留一个“不被模型化的 Principal 回路”:在高风险、目标变更、价值冲突或无法证明的情形中,系统返回真实主体,而不是假装所有判断都已进入机器状态。
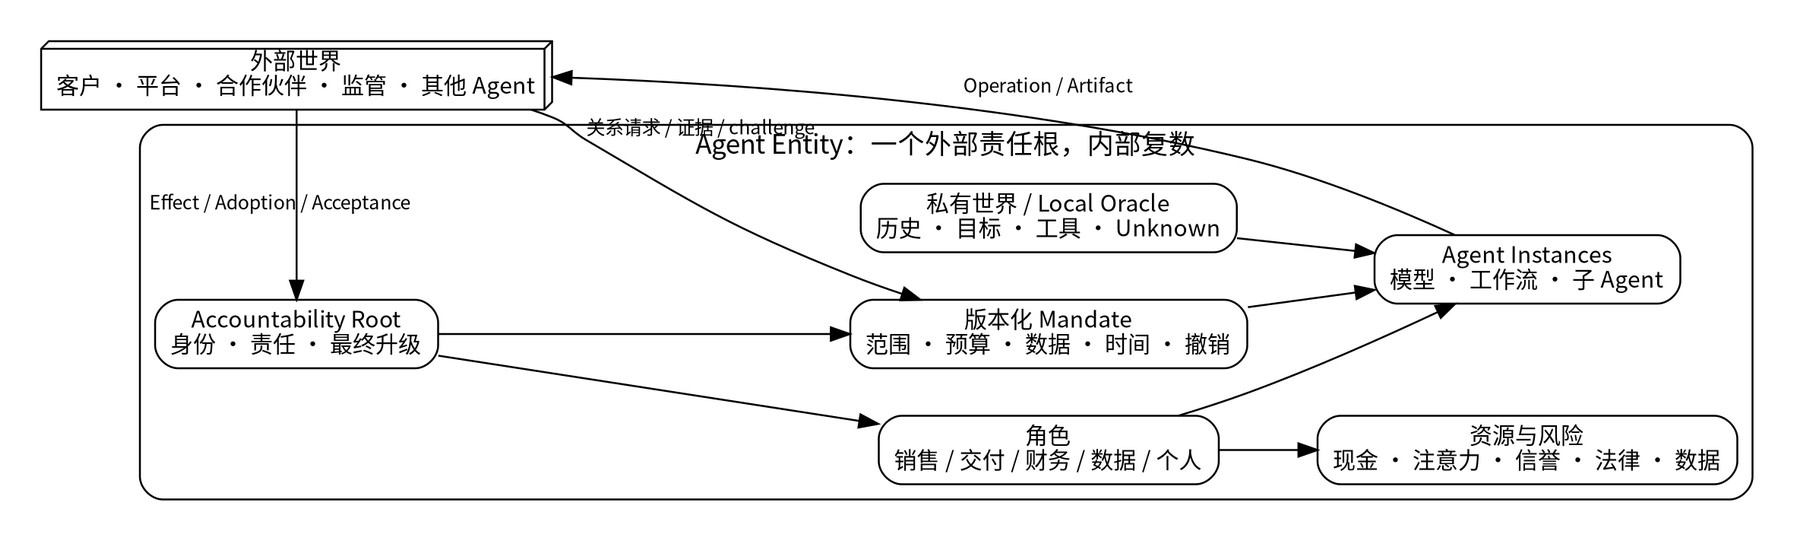 {width=94%}
定义 3(Authority Root)。 Authority Root 是身份或权威能够被外部验证的来源,例如自然人的认证身份、公司登记和章程、账户所有权、董事会决议、客户授权或特定法律程序。
定义 4(Authority Locus)。 Authority Locus 是某一 Authority Root 内部,对特定动作、对象、金额、风险、时间或结果拥有决策、签署、见证、采用、接受或申诉权限的位置。
在大型组织中,预算、法务、数据、技术和业务接受通常由不同岗位持有;在 OPC 中,它们可能集中于同一自然人,却仍然不能被语义上合并。原因在于同一个人可以在不同角色下承受不同义务:
因此,系统中“谁作数”必须由 locus + scope + version 表示,而不能仅靠登录身份。
定义 5(Mandate)。 Mandate 是 Principal 或相称 Authority Locus 对 Agent Entity 或 AgentExecution 的版本化委托:
[ M = \langle M_{core}, M_{control} \rangle, ]
[ M_{core} = \langle issuer, delegate, objective, actions, objects, bounds, data \rangle, ]
[ M_{control} = \langle evidence, expiry, escalation, revocation \rangle. ]
其中 objective 说明该代理为了谁的什么目标行动;actions 和 objects 界定动作与对象;bounds 界定金额、时间、风险和不可逆性;data 界定读取、推理、保留、训练与再披露;evidence 规定行动前后需要什么证明;escalation 规定何时必须回到 Principal;revocation 规定撤销方式及已发生 Effect 的处置。
Mandate 不是把 Principal 的人格或全部权利转给 Agent。它是一个受条件约束、可撤销、可审计的行动许可。模型能力升级、工具增加或历史成功不自动扩展 Mandate。
定义 6(AgentExecution)。 AgentExecution 是在特定 Mandate、上下文快照、执行器版本、工具集合和预算下发生的一次代理运行:
[ X = \langle entity, mandate, context_ref, executor, tools, budget, start, end, outputs \rangle. ]
AgentExecution 可以生成候选、主张、问题、Operation Specification 或证据,但不能仅因“成功运行”而产生新的 Authority Root。软件仓库、进程、Consumer、Owner interface 或模型会话在实验中可以代表不同技术状态域,却不应自动被称为真实 Principal。
定义 7(Sovereign World)。 对主体 (i) 而言,其时刻 (t) 的主权世界为
[ W_i(t)=\langle H_i, G_i, C_i, R_i, U_i, P_i, L_i, E_i \rangle, ]
其中 (H_i) 是历史上下文,(G_i) 是目标与认识,(C_i) 是能力和工具,(R_i) 是资源,(U_i) 是权威与责任,(P_i) 是政策与偏好,(L_i) 是法律/制度约束,(E_i) 是执行环境。各分量持续变化,也可能只有在具体任务、现实 probe 或反条件出现时才被主体显式认识。
Sovereign 不等于“所有数据都绝不离开本地”。它表示:
设系统中有 Principals 集合 (P)、Agent Entities 集合 (E)、Authority Loci 集合 (L)、Mandates 集合 (M)、Executions 集合 (X)。最小责任关系为:
[ issuer: M \rightarrow P \cup L, \quad delegate: M \rightarrow E \cup X, ]
[ root: L \rightarrow P, \quad authorizedBy: X \rightarrow M, \quad accountableTo: E \rightarrow P. ]
一个 Execution 的任何现实 Operation 必须存在一条可验证路径:
[ X \xrightarrow{authorizedBy} M \xrightarrow{issuer} L \xrightarrow{root} P. ]
如果该路径断裂,系统只能把输出视为候选或未授权 Attempt,不能把它写成 Principal 的承诺或接受。
主体模型导出五项不变量:
早期研究试图用多语义向量、层次坐标和 Nested Anchor Coordinates(NAC)表达主体的需求、资源、能力和关系。其重要发现是:单一 embedding 或平面标签难以同时保留主体在不同语义维度上的位置;一个可用的发现接口需要允许从不同锚点、层级和任务视角进入同一主体。这推动了四动词接口——发现、询问、验证、行动——以及后来的边界预言机。
然而,NAC 若被写成“对所有未来任务都充分的通用语义地址”,就会遇到原则性问题。主体未来可形成的能力依赖尚未出现的工具、伙伴、授权和任务重构;偏好会被候选方案和现实体验改变;某些事实只有在具体风险和对手方出现时才有意义。任何固定表示都只能是当前世界的投影,而不是未来行动空间的完备编码。
因此,本文保留 NAC 的接口价值,放弃其作为普遍本体的地位。新的问题不是“找到完美画像”,而是“针对当前任务,以什么交互获得足够决策区分力”。
令主体 (i) 的公开描述为静态投影:
[ \pi_i: W_i(t_0) \rightarrow Z_i, ]
其中 (Z_i) 是有限长度公开表示。任务族 (\mathcal{T}) 中每个任务 (T) 对世界定义一组可行动判断 (f_T(W_i))。如果未来任务、工具、伙伴和授权没有被限定,则不存在一个有限 (Z_i) 能对所有 (T \in \mathcal{T}) 保持充分。
直观反例是:两个主体在公开画像上完全相同,但其中一个在收到特定候选后愿意学习新工具、获得伙伴授权或调整时间;另一个不会。对当前已知任务,两者可以等价;对未来构成任务,其可达行动集合不同。任何不包含全部未来反事实的固定画像都无法区分。
这一结论不意味着画像无用。标准化平台任务通常只需要低维字段;在任务族、动作词汇和制度框架稳定时,静态表示可以是 CollapseSafe 的。结论只是反对把它提升为开放世界的普遍充分条件。
定义 8(任务相关边界)。 对任务族 (\mathcal{T}_0)、风险阈值 (\rho) 和时间窗 ([t_0,t_1]),边界接口 (B_i) 是一组交互式查询—响应机制,使协调器能够在不获得完整 (W_i) 的情况下,对当前所需决策达到指定错误和披露约束。
定义 9(((\epsilon,\delta))-充分)。 若对于任意 (T\in\mathcal{T}_0),使用边界响应的决策 (\hat{a}) 相对完整世界最优决策 (a^*) 的期望后悔不超过 (\epsilon),且敏感信息披露超过预算的概率不超过 (\delta),则称 (B_i) 对该任务族任务相关充分。
这一定义把“充分”从绝对语义完整改写为任务、风险和时间相关。一个边界可以对采购任务充分,却对维护任务不充分;对 7 天内的低风险试点充分,却对长期训练权不充分。
早期“体—边对偶”直觉指出:主体内部是高维私有体,协调无需传输整个体,只需通过边界响应逐步确定可行域。严格化后,本文把本地世界在某一受限任务中的可行集合写为 (K_i\subseteq \mathbb{R}^d)。在凸、闭且可由分离 Oracle 访问的条件下,协调器可以通过支持超平面逐步逼近交集:
[ K = \bigcap_{i=1}^{n} K_i. ]
本地 Oracle 对候选 (x) 返回:
[ O_i(x) \in {ACCEPT, SEPARATE(h), WITNESS(w), UNKNOWN, REFUSE}. ]
若 (x\notin K_i),SEPARATE(h) 返回一个切割 (h(x)>0) 且对所有 (y\in K_i), (h(y)\le 0)。在标准凸优化假设下,切平面方法能在给定精度内判定交集或找到近似可行点 [16]。这一形式结果支持“边界交互可以替代完整复制”的局部可能性。
但社会协调不是纯凸世界:
因此,形式定理只承担接口可行性,而不是对现实全局最优的保证。
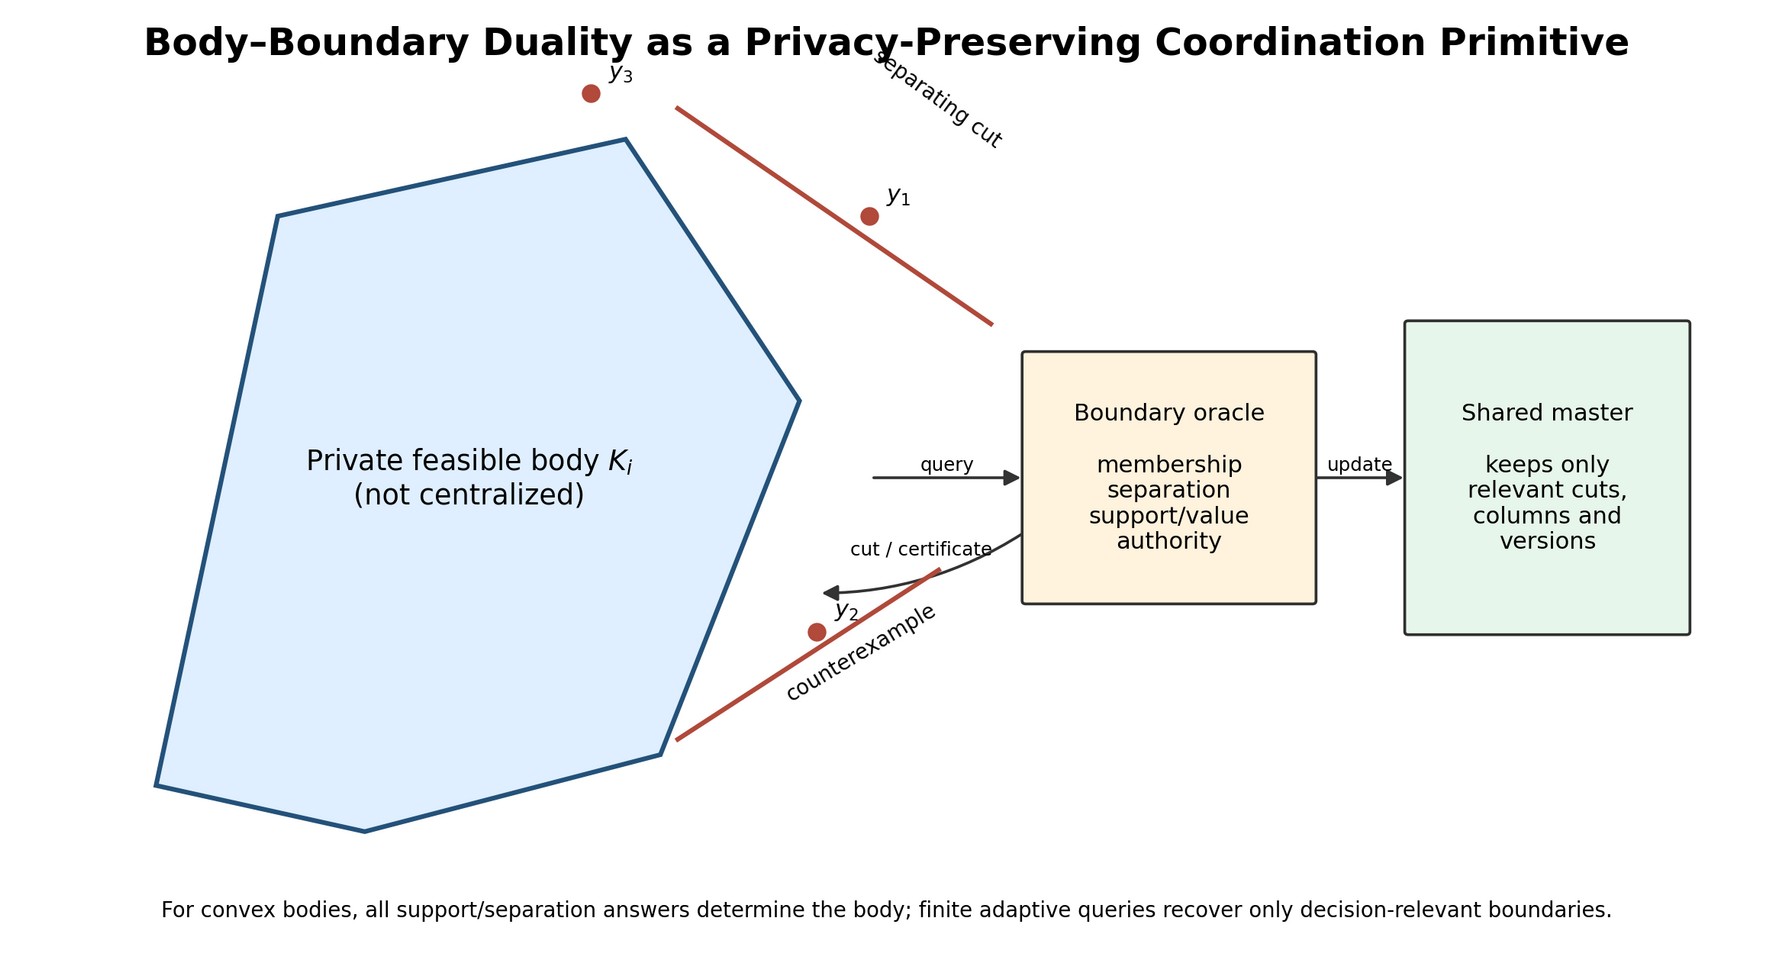 {width=92%}
边界 Oracle 的响应不应只有 yes/no。当前建议至少包括:
| 响应 | 含义 | 系统动作 |
|---|---|---|
| ACCEPT | 当前候选在给定范围内可行 | 进入资格化或规范闭合 |
| SEPARATE | 候选违反可表达边界 | 加入硬切割或条件 |
| WITNESS | 提供支持可行性的证据 | 更新 AssuranceCase |
| COLUMN | 暴露此前未知的贡献模式 | 扩大行动词汇或参与组合 |
| MODEL_OBJECTION | 模型基于推断提出异议 | 作为候选,不产生权威效力 |
| HUMAN_REFUSAL | 主体不愿披露或参与 | 保留拒绝,不强迫解释 |
| UNKNOWN | 当前无法判断 | 选择 probe、学习或延迟 |
| COUNTERCONDITION | 在新增条件下可能成立 | 生成 RelationVersion 修订 |
REFUSE 与 UNKNOWN 必须分开:前者是规范边界,后者是认识缺口。把两者合并会让系统将“现在不知道”误写成永久不可能,或把主体的拒绝误写成待优化障碍。
隐私保护常被简化为最小化披露量,但协调质量与披露存在任务相关权衡。令 (D(B)) 为边界披露成本,(R(B)) 为决策后悔,(F(B)) 为错误不可行率,则边界选择问题是:
[ \min_B ; \alpha D(B)+\beta R(B)+\gamma F(B)+\eta C_{interaction}(B), ]
而不是单独最小化 (D)。过少披露会造成错误排除、反复询问和机会损失;过多披露会增加隐私、商业秘密和重建攻击风险。边界系统必须同时记录披露预算、查询目的、派生权和累计可识别性。
 {width=74%}
即使每次查询只返回一个切割,多轮自适应询问也可能逐步重建主体内部边界。防护不能只靠“没有传原始数据”,还需要:
这使数据流动成为一个持续的权利与派生问题,而不是一次性的“是否上传”。
OPC 的十二阶段流程有操作价值,但若把它当作唯一理论结构,会制造线性错觉。现实中,执行反例会回到问题构成,认领会改变候选,能力 probe 会改变参与者,新的 Standing 会重开制度框架;不同子图还可能同时处于形成、运行和争议状态。
因此,本文恢复三维统一模型:
主体拥有不可被中心无损复制的历史、目标、工具、资源、政策、权威和环境。L0 不要求完全私密,而要求任何外部投影都不能被误认为完整主体。
系统通过公开描述、NAC 式入口、本地 Oracle、凭证、证明和最小询问发现相关性。此层目标不是生成合作方案,而是识别哪些主体、资源、边界和未知值得进一步进入。
参与者、角色、行动词汇、状态转移、权威、证据、数据权利和结果语义被写入版本化 Coordination Schema,并在 JAA/RelationVersion 中共同编辑。L2 回答“我们到底在讨论什么、谁有资格改变什么”。
系统使用候选生成、反例、countercondition、工具、伙伴、训练、任务拆分和现实 probe 扩大或重构行动空间。PFE 位于此层。
候选路径被转化为带前置条件、执行器、资源、证据、恢复和时间范围的能力合同;通过 CRA、AssuranceCase 和 Defeater 进行反驳。
相关 Authority Locus 对精确版本作出 Recognition、Reject、Conditional、Delegation 和 Commitment;资源被预留,退出和争议路径被明确。
AgentExecution 发起 Operation,目标世界产生或拒绝 Effect;随后分别处理 Adoption、Verification、Acceptance 和 Settlement。
稳定子图被编译为最小权限、可重复、可观察的运行机制;事件、Defeater 和环境漂移触发局部重开。Compiled World 是运行投影,而非第二个权威事实源。
每个层级都同时存在五种语义:
例如,一个新的合作条件在认识上可能只是模型假说,在生成上扩大了候选空间,在规范上尚未被任何主体认领,在操作上尚无执行接口,在经济上可能成本过高。只说“系统发现了条件”无法判断它处于什么状态。
 {width=92%}
对任一主张、能力或关系版本,本文使用如下成熟度偏序:
[ Unknown \rightarrow Hypothesis \rightarrow Candidate \rightarrow Counterfactual \rightarrow Sandboxed, ]
[ Sandboxed \rightarrow Witnessed \rightarrow Qualified \rightarrow Recognized \rightarrow Delegated, ]
[ Delegated \rightarrow Committed \rightarrow Performed \rightarrow Verified \rightarrow Adopted, ]
[ Adopted \rightarrow Accepted \rightarrow Settled. ]
这不是一条所有对象都必须线性经过的工作流。某些节点可并行、回退或被跳过;不同权威域的同一对象可以处于不同状态。例如服务方已经 Performed,买方目标域尚未 Adopted,最终业务负责人也尚未 Accepted。
禁止捷径:
三维模型决定系统不应只维护一张全局状态表。最低要求是:
它还解释了为何 v0.7 的单线流程不够:流程适合操作手册,三维模型才适合理论、协议和审计。
一个标准搜索或匹配问题通常预设:
开放主体协调会同时破坏这些假设。某个 OPC 可能只知道“我想扩大交付能力,但不愿雇全职员工”,并不知道需要的是联合投标、可撤销数据合作、临时项目团队还是标准 SaaS;潜在伙伴也可能没有公开对应能力,因为该能力只有在特定预算、工具、时间和授权组合下才会出现。
因此,搜索不是无用,而是构成完成后的子程序。系统必须先形成“什么值得搜索”和“什么结果可以进入现实”的语法。
成对匹配无法完整表达三方及以上互补。例如:
任意两方单独都不可行,三方组合才产生联合能力。若平台只对 pairwise score 排序,所有边权都可能为零,从而永远发现不了三元超边。这个反例表明,开放协调需要允许 COLUMN 响应和临时联盟构成,而不能只用静态主体配对。
定义 10(Coordination Schema)。 对某一关系族,协调模式写为:
[ \Gamma = \langle R,V,T,A,E,D,O \rangle, ]
其中:
价格、日期、数量等具体值属于 Relation 实例 (x),不必每次都改变 (\Gamma)。但若价格跨过董事会审批阈值,导致新增必要 Authority Locus,则该变化从参数变化转为 material schema change。
复杂社会行动通常不从零开始。法律、行业、平台和组织已提供部分规则。本文区分:
[ \Gamma^I \quad \text{Institutional Frame}, ]
[ \Gamma^R_v \quad \text{relation-specific version } v. ]
二者使用同一七维结构,RelationVersion 通过 inherits_from 和 overrides 继承或覆盖制度框架。成熟并购可在既有公司法、合同和监管程序内处理大量复杂参数;此时问题复杂,却未必需要开放构成。相反,一个看似简单的数据合作若其数据位置、训练权、派生权和业务接受尚未定义,就可能需要打开 (\Gamma^R) 甚至修订 (\Gamma^I)。
定义 11(物质性变化)。 对当前任务状态 (s) 和 Relation Schema (\Gamma),变化 (\Delta\Gamma) 若改变以下任一项,则为 material:
形式地,若
[ Reach(s,\Gamma) \neq Reach(s,\Gamma+\Delta\Gamma) ]
或存在主体 (i) 使其规范义务集合
[ Obl_i(s,\Gamma) \neq Obl_i(s,\Gamma+\Delta\Gamma), ]
则变化为 material。显示名称、不可达归档动作或不影响当前任务的扩展可以是 non-material。
SJAC 不是新的协议 root,而是对 L2–L5 过程的理论名称。它回答:多个主体如何在不交出完整世界的情况下,共同形成一个可被各自本地 Oracle 解释和约束的联合行动结构。
SJAC 至少包含:
它不是“所有人达成同一世界观”,而是形成一个最小的、可执行的跨世界接口。
定义 12(JAA)。 Joint Action Artifact 是一个版本化、可引用、可局部认领的共同协调介质,包含当前 RelationVersion、未决项、候选、证据、Stance、依赖和历史,但自身不成为所有事实的权威来源。
JAA 的关键性质:
JAA 因而更像可编译的共同工作对象,而非中心数据库里的“真相记录”。
联合行动构成不是一次协商,而是三个耦合循环:
形成问题、角色、动作词汇、条件和结果语义。输出是新的或修订的 (\Gamma^R)。
通过本地 Oracle、probe、切割、见证和新列,发现当前候选在哪些条件下可行。输出是合格候选、Defeater 或新形成动作。
相关 Authority Locus 对精确版本作出 Recognition、Delegation、Commitment、Reject 或 Conditional;资源被预留,退出和接受被明确。
三个循环相互回馈:规范拒绝可暴露语义缺口;可行域反例可要求新角色;语义修订会使已有承诺失效。
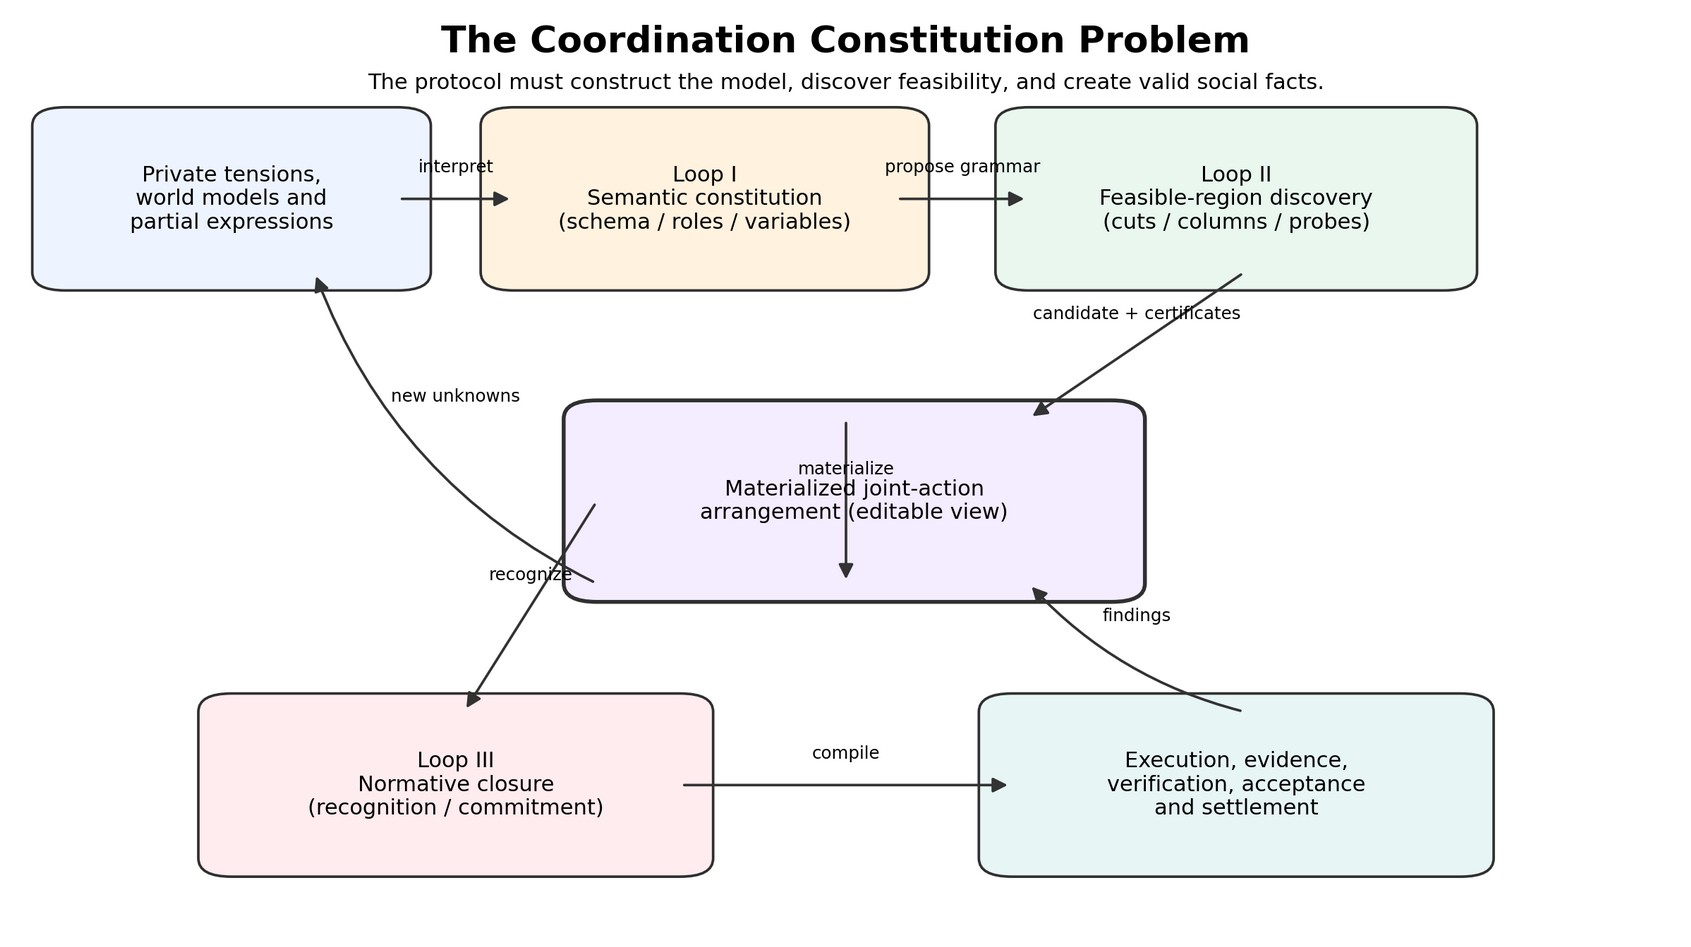 {width=88%}
开放世界无法保证枚举所有潜在主体和行动。本文因此不追求“检索完备”,而追求过程完备性:对于当前任务中出现的每个重要 Unknown,系统至少能够把它分类为可询问、可验证、可试验、可授权、可重构、可拒绝或不可判断,并保存其来源与后续路径。
过程完备性不保证找到全局最优合作,但能防止系统把未探索的可能性误写成不存在,把主体拒绝误写成技术失败,或把模型猜想误写成共同事实。
设时刻 (t) 的候选联合行动集合为 (A_t)。本文不把所有语言上可描述的动作都视为可行动,而定义合格联合行动空间:
[ Qual^0_t(a) = Exec(a)\land Auth(a)\land Evid(a)\land Rights(a), ]
[ Qual_t(a) = Qual^0_t(a)\land Reserve(a)\land Witness(a)\land Standing(a), ]
[ Q_t = {a\in A_t \mid Qual_t(a)}. ]
其中:
生成式协调的目标不是盲目扩大 (|Q_t|)。某些候选应被更快排除,某些权限应被收窄。更准确的目标是:以可接受的披露、认知和验证成本,使 (Q_t) 更真实——既能纳入新形成的可行路径,也能删除伪路径。
“未知”必须成为一等对象,而不是空字段。本文区分:
不同 Unknown 需要不同动作。对能力未知增加更多对话,往往不如运行 sandbox probe;对 Authority Unknown 询问普通 Agent 没有意义,必须定位相称 Locus;对 Preference Unknown 直接要求填表可能过早,需要提供可比较候选或体验;对 Strategic Unknown 则需机制约束、证据、抵押或第三方验证。
定义 13(Formation Operator)。 形成算子 (\phi) 是一种能够改变候选空间、可行条件、参与结构、能力、权威或证据状态的受控操作:
[ \phi: \langle \Gamma_v,Q_t,U_t \rangle \rightarrow \langle \Gamma_{v'},Q_{t+1},U_{t+1},Evid_{t+1}\rangle. ]
典型算子包括:
ASK_BOUNDARY:提出最小任务相关问题;REQUEST_WITNESS:要求证据或目标域 readback;RUN_PROBE:执行低风险现实或 sandbox 试验;ADD_TOOL:接入新工具或环境;ADD_PARTNER:引入新主体或贡献模式;TRAIN_OR_LEARN:形成新的局部能力;REFRAME_TASK:改变任务分解和目标表达;SPLIT_IRREVERSIBLE:把不可逆动作拆成可撤回前置步骤;REQUEST_MANDATE:申请范围化授权;OFFER_GUARANTEE:增加担保、保险、补偿或风险共担;REDUCE_DISCLOSURE:改变执行位置、数据接口或证明形式;GENERATE_COUNTERCONDITION:把拒绝转化为可检验的新条件;EXIT:有证据地终止当前路径。形成算子可能扩大、收缩或重写 (Q_t)。“不成交”也可能是高质量结果:若系统更快揭示不可兼容条件并避免错误承诺,其价值并不低于勉强促成交易。
PFE(Possibility Formation Engine)不是一个全知规划器,而是对“下一步做什么才能让问题更可判断或更可行动”的策略层。它维护:
一种参考评分为:
[ Score(\phi)= \mathbb{E}[\Delta V_Q \mid \phi] -\lambda_1 C_{attention} -\lambda_2 C_{disclosure} -\lambda_3 C_{probe} -\lambda_4 Risk_{effect} -\lambda_5 C_{delay}, ]
其中 (\Delta V_Q) 不只是候选数量变化,而是合格行动空间的预期净价值变化。若形成动作只产生更多文本而不改变可达路径、判断能力或错误概率,其信息增量应接近零。
传统 value of information 假设行动集合固定。开放协调中,信息本身可能创造新动作、权限或伙伴。本文使用 ECVI(Expected Coordination Value of Intervention)表示形成动作的净值:
[ ECVI(\phi)= \mathbb{E}\left[ \max_{a\in Q_{t+1}} U(a)-\max_{a\in Q_t} U(a) \right]-C(\phi)-R(\phi). ]
若 (Q_t=\varnothing),一个有效 probe 可能使 (Q_{t+1}\neq\varnothing);若 probe 暴露关键不兼容,ECVI 也可能为正,因为它减少错误成交和后续损失。ECVI 是设计目标,不是目前已经得到现实校准的预测器。
参考算法:
input: relation version Γv, unknowns U, mandates M, risk budget B
repeat:
    generate candidate actions or schema revisions
    query local boundary / authority / evidence oracles
    if candidate is qualified and normatively closed:
        emit commit-ready relation version
    else:
        collect counterexamples, refusals, unknowns, missing columns
        rank formation operators by ECVI and risk
        execute the least-cost discriminating operator
        update Γ, Q, U and evidence
until commit, reject, defer, withdraw, dispute, or budget exhaustion
该循环的建设性在于:反例不是“失败日志”,而是下一版 RelationVersion 的输入。若数据权威拒绝原始数据外传,系统可以产生本地执行、只读接口、禁止训练和买方 readback 的新路径;若资源不足,可以引入临时伙伴或缩小承诺;若目标不可验证,可以先设计 Effect witness。
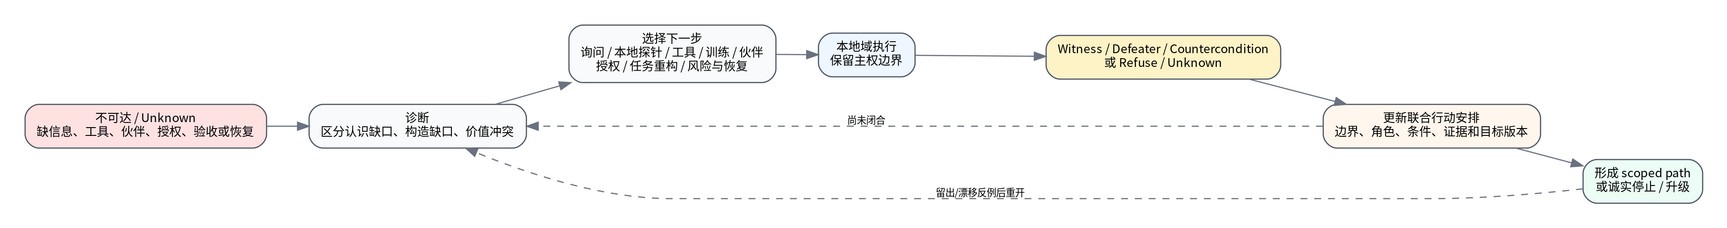 {width=90%}
主体偏好并不总是预先存在。方案、解释、原型和现实体验会使主体形成新认识。系统因此不能把“用户没有填写”简单当作缺字段,也不能把模型推断的偏好直接写回 Principal。
需要区分:
对于 material preference change,系统应保存差异摘要、来源、冷静期、explain-back 和撤回窗口。模型可以提出选项,但不能把“更高预测效用”当成主体已经认领。
形成过程不能无限延长。停止条件包括:
“停止”可以输出 REJECT、DEFER_UNKNOWN、WITHDRAWN 或 REFER_TO_HUMAN,而不必伪装成失败。
定义 14(Capability Claim)。 能力主张不是“主体会做 X”的标签,而是:在给定执行器、环境、权限、资源、输入分布、时间和恢复条件下,能够以某一保证水平产生指定 Effect。
形式表示:
[ Cap = \langle Cap_{exec}, Cap_{assure} \rangle, ]
[ Cap_{exec} = \langle action, executor, env, mandate, resources, input_scope \rangle, ]
[ Cap_{assure} = \langle quality, latency, reliability, recovery, validity, evidence \rangle. ]
同一 Agent Entity 在本地 sandbox、客户生产环境和无网络环境中可能具有不同能力;模型升级、工具版本和资源占用都会改变能力。能力因此是版本化、任务相关和可反驳的。
本文区分:
一次 sandbox 成功只提供 Witness,不自动建立稳定能力。能力合同必须说明失败时如何重试、降级、补偿和恢复;否则系统会把演示能力误写成生产承诺。
CRA(Capability Realization and Assurance)负责把候选路径转化为可承诺能力。其循环包括:
PFE 与 CRA 不是完全独立的流水线。CRA 的反例可能要求新增工具、伙伴或任务重构;PFE 的新候选又需要 CRA 资格化。它们构成生成—反驳循环。
定义 15(AssuranceCase)。 AssuranceCase 是围绕某一 Capability Claim 或 Effect Claim 的结构化论证:
[ AC = \langle AC_{claim}, AC_{challenge} \rangle, ]
[ AC_{claim} = \langle claim, context, assumptions, evidence, argument \rangle, ]
[ AC_{challenge} = \langle defeaters, residual\ risk, authority \rangle. ]
它不是证据文件列表。证据必须与主张相关:单元测试可以支持代码分支行为,却不能证明目标组织会采用;模型自报可以说明其内部判断,却不能证明现实 Effect;checksum 证明字节未变,不证明业务语义正确。
模型输出概率 (p(y\mid x)) 属于认识语义。系统可以用它进行候选排序、选择是否自动执行或请求人工复核,但必须满足:
选择性执行策略可写为:
[ execute(x)=\mathbb{1}[\hat{r}(x)\le \tau \land mandate(x) \land witnessable(x)]. ]
即使 (\hat{r}(x)) 很低,没有 Mandate 或无法观察 Effect 仍然不能执行。
 {width=76%}
对于稳定、低风险、标准化任务,完整 CRA 的治理成本可能高于收益。系统应允许把已反复验证的局部能力编译为轻量 Capability Envelope,并通过版本、健康检查和 Defeater 维护。只有当环境、执行器、权限、输入分布或损失结构变化时,才重开资格化。
这避免两种极端:把所有任务都当作重型安全审计;把历史成功永久写成“会做”。
历史实验中,一套六轴能力资格化只通过 4/6,低于预注册的 80% 门槛。该结果不应被修饰为“基本成功”。它说明当时的能力合同尚不足以覆盖恢复和环境迁移,也促使系统把 Capability 从主体静态属性改为条件性合约。科学价值来自门槛真的可以阻止过早承诺。
模型对某候选的高置信、低风险预测或多轮一致意见,不产生 Principal 的权威。反之,Principal 有权授权某行动,也不证明行动技术上可行或有益。
因此系统必须维护两个正交平面:
把二者混合会产生两类错误:技术模型冒领决定权;权威主体在没有能力证据时作出不可兑现承诺。
定义 16(Recognition)。 Recognition 是相称 Authority Locus 对某个精确 RelationVersion、Claim 或 Effect 的理解并认领,至少包括:
一个“同意”按钮若没有显示 material difference、权利后果和退出条件,不能被默认视为 informed recognition。对于高风险变化,应提供逐项认领、差异摘要、冷静期和可撤回窗口。
Stance 是主体对对象的版本化立场事件,可取:
RECOGNIZE / REJECT / CONDITIONAL / DEFER_UNKNOWN /
WITHDRAW / DISPUTE / ACCEPT / NOT_ACCEPT
Commitment 则是产生未来义务和可问责关系的独立对象:
[ C = \langle C_{relation}, C_{duty}, C_{remedy} \rangle, ]
[ C_{relation} = \langle debtor, creditor, antecedent, consequent, scope \rangle, ]
[ C_{duty} = \langle resources, deadline, evidence \rangle, ]
[ C_{remedy} = \langle remedy, exit, version \rangle. ]
Recognition 说明“我理解并认领这一版本”;Commitment 说明“在条件成立时,我承担什么义务”。二者不能合并。主体可以认领一个事实但不承诺行动,也可以在法律或组织程序下承诺一个它并不价值认同的动作。
拒绝不是异常状态。高质量协调必须允许主体:
Countercondition 不应被系统当作等待说服的障碍,而是一个可能改变 Relation Schema 的权威输入。只有 issuer 明确授权 Agent 自动协商的维度,Agent 才能在范围内修改条件。
定义 17(Standing)。 Standing 是主体就某项关系提出挑战、要求解释、参与审查或获得救济的资格。它与最终签署权不同。
系统至少区分:
公共咨询、员工、数据主体或受影响社区可能没有最终签字权,却能提出足以改变合法 RelationVersion 的 material challenge。反过来,签字人也不能代表所有未被授权的受影响者。
当多个 Agent 同时形成承诺时,检查后写入(check-then-write)会导致预算、库存、时间或人力被重复承诺。设资源余额为 (B),并发请求为 (r_1,\ldots,r_n)。若各请求先独立检查 (r_i\le B) 再写入,可能出现:
[ \sum_i r_i > B ]
却每个局部检查都通过。
因此,Commitment 前必须存在 ResourceReservation 或等价原子机制。其线性化点应位于承诺产生之前,撤销、过期和补偿也必须可观察。草稿候选可以并发合并;会产生外部义务的资源承诺不能依赖最终一致。
数据使用不只发生“读取”。Agent 可能产生分类、评分、记忆、联合计划、模型更新和新的关系边界。本文将其统一为:
DataUseEvent:实际发生的使用;LearningUpdate:若产生跨任务持久状态,则作为 Effect 记录。只有当某项权利需要独立签发、撤销、跨关系引用和争议时,才提升为独立 Commitment。这样既不丢失治理语义,也不让本体无限增生。
 {width=94%}
规范生命周期至少包含:
DRAFT
→ PROPOSED
→ EXPLAINED
→ RECOGNIZED / REJECTED / CONDITIONAL
→ DELEGATED
→ RESERVED
→ COMMITTED
→ ACTIVE
→ FULFILLED / BREACHED / WITHDRAWN / DISPUTED
→ SETTLED / REOPENED
任何 material change 都使受影响的 Recognition、Mandate 或 Commitment 进入待复核,而不是静默继承。
自动化系统常把以下信号写成“完成”:模型说已经做了、工具调用没有抛异常、子进程退出码为 0、队列消息已发送、调用方数据库更新,或接收方返回 2xx。这些最多证明 Attempt 或中间步骤。现实 Effect 必须由目标世界中相称的权威状态证明。例如支付的 Effect 由支付系统记账状态、对方入账或可验证回执证明;代码部署的 Effect 由目标环境版本和健康检查证明;会议预约由双方日历或确认状态证明;“客户已经采用”则需要目标域 adoption 事件,而非发送方日志。
定义 18(Operation Specification)。 Operation 是一个可执行、版本化、受 Mandate 约束的动作规范:
[ Op = \langle Op_{act}, Op_{guard}, Op_{recovery} \rangle, ]
[ Op_{act} = \langle action, target, inputs, mandate, idempotency \rangle, ]
[ Op_{guard} = \langle preconditions, witness, timeout \rangle, ]
[ Op_{recovery} = \langle retry, compensation, expected\ effect \rangle. ]
定义 19(ActionAttempt)。 每次运行产生唯一 AttemptID,并记录执行器、开始/结束时间、输入引用、工具结果和错误。多个 Attempt 可以对应同一逻辑 Operation;幂等键防止重试重复产生 Effect。
Operation 必须指向精确 RelationVersion 和 Mandate。若关系版本发生 material change,旧 Operation Specification 不能自动继承。对于不可逆动作,还应有 pre-effect validation:在真正改变目标世界之前再次检查授权、资源、目标地址和 witness 可用性。
定义 20(Effect)。 Effect 是目标世界中可由相称 witness 观察到的状态变化:
[ Eff = \langle Eff_{state}, Eff_{trace} \rangle, ]
[ Eff_{state} = \langle target_domain, state_before, state_after \rangle, ]
[ Eff_{trace} = \langle witness, causal_operation, time, reversibility \rangle. ]
Effect 可能与预期不同,可能部分发生,也可能发生后被撤销。系统必须允许:
NO_EFFECT;PARTIAL_EFFECT;UNEXPECTED_EFFECT;EFFECT_CONFIRMED;EFFECT_REVOKED;EFFECT_UNKNOWN。Effect 的权威来源通常位于目标域。调用方可以提交 Attempt 和预期,但不能单方面宣布目标域状态。
Verification 判断某 Claim 是否得到证据支持;它可以由技术、审计或第三方完成。
Adoption 表示目标域把结果纳入自己的真实运行状态,例如代码合并到生产分支、采购结果进入库存系统、方案写入真实 backlog。
Acceptance 是有权主体对 Effect 和交付义务的最终认领,可以是完全、条件、部分或拒绝。Acceptance 可能晚于 Adoption,也可能因组织惯性出现“已采用但未接受”的争议状态。
因此:
[ ActionAttempt \neq Effect \neq Adoption \neq Acceptance. ]
这四者必须由不同事件和 Authority 维护。任何统一成 status=done 的实现都会丢失争议、补救和责任边界。
定义 21(Evidence Closure)。 一个 Effect/Acceptance 主张只有在以下条件满足时闭合:
哈希、签名和 checksum 证明字节来源与完整性,却不能单独证明业务语义;模型解释证明其推理文本存在,却不能单独证明事实;第三方审计可以增强 Assurance,但不能替不相称的 Principal 接受。
不同主张需要不同见证:
| Claim | 不充分证据 | 相称 witness 示例 | |---|---|---| | “文件已发送” | 发送端日志 | 接收端可读取回执 | | “代码已部署” | CI 成功 | 目标环境版本 + 健康检查 | | “付款已完成” | API 2xx | 账本入账/对方确认 | | “能力可用” | 一次 demo | 条件范围内重复测试 + 恢复证据 | | “客户已采用” | 服务方声明 | 客户目标系统或有权角色的 adoption | | “主体已接受” | 沉默或自动勾选 | 精确版本的有权 Acceptance |
WitnessPolicy 应作为 Operation 或 Claim 的字段/策略,而不是再增加一类顶层对象。
Settlement 不是“系统结束”,而是当前争议和义务在某一制度下达到可接受的处置状态:履行、退款、补偿、仲裁决定、撤销或双方和解。Settlement 可以被新的证据、欺诈或外部裁决重开。
争议发生时,系统应:
SPECIFIED
→ AUTHORIZED
→ ATTEMPTED
→ EFFECT_UNKNOWN / NO_EFFECT / EFFECT_CONFIRMED
→ ADOPTED / NOT_ADOPTED
→ VERIFIED / CONTESTED
→ ACCEPTED / CONDITIONAL / REJECTED
→ SETTLED / REOPENED
该状态机允许出现“Effect confirmed but rejected”“adopted but disputed”“performed but no effect”等现实状态,而不是强迫所有结果进入单一 success=true。
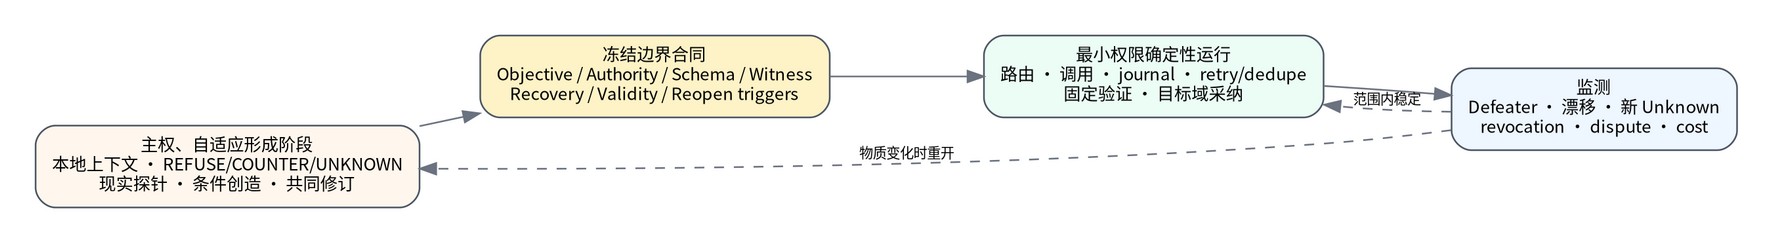
开放形成需要适应性推理、边界询问、反条件、现实 probe 和主体回路;稳定运行则应尽量使用最小权限、确定性、可测试的机制。若所有日常动作都继续由高能力 Agent 自由协商,系统成本、漂移和越权面会持续扩大;若过早冻结,则无法吸收新证据和环境变化。
本文采用两种局部控制制度:
 {width=92%}
单一 stable=true 会掩盖关键差异。本文定义:
[ S = \langle s_{tech},s_{auth},s_{ep},s_{norm},s_{econ}\rangle, ]
分别表示:
某个 API 可以技术稳定,却没有稳定治理;某项合作可以双方签字,却缺目标 Effect witness;某项机制可以合法但经济成本不可持续。关键维度失败不能被其他维度平均抵消。
子图 (G') 只有在以下 Gate 满足时可编译:
Compile readiness 是针对任务族、风险等级、时间窗和当前状态的局部判断,而不是永久认证。
Compiled World 是联邦式权威—行动图的运行投影,包含:
它不成为第二事实源。若本地 Authority、目标世界或外部制度发生变化,Compiled World 必须通过事件更新或失效,而不能继续声称旧状态有效。
至少六类 Defeater 会触发重开:
EVIDENCE_DEFEATER:证据被推翻或过期;CAPABILITY_DEFEATER:执行器、环境、资源或恢复能力变化;AUTHORITY_DEFEATER:Mandate 撤销、角色变更或权限失效;EFFECT_DEFEATER:目标世界状态被撤销、回滚或无法读取;NORMATIVE_DEFEATER:新的受影响主体、法律或合法性挑战出现;ECONOMIC_DEFEATER:成本、容量或价值变化使机制不再可持续。设关系图 (G=(N,E)),节点为 Claim、Mandate、Commitment、Operation、Effect、Acceptance 等,边表示依赖。Defeater 作用于节点 (n) 时,重开集合为:
[ Reopen(n)={m\in N \mid n\leadsto m \land dependency(n,m)\ is\ material}. ]
只重开依赖闭包,而非整条关系。若一个支付方式失效,不必重谈全部交付范围;若数据训练权变化,只重开依赖该权利的派生和长期学习,不影响已完成且独立的只读分析。
现实系统可以同时存在:
因此“形成—运行”不是全系统二阶段瀑布,而是图上的局部状态。高能力 Agent 应集中在未稳定边界和异常处,而不是持续接管所有确定性工作。
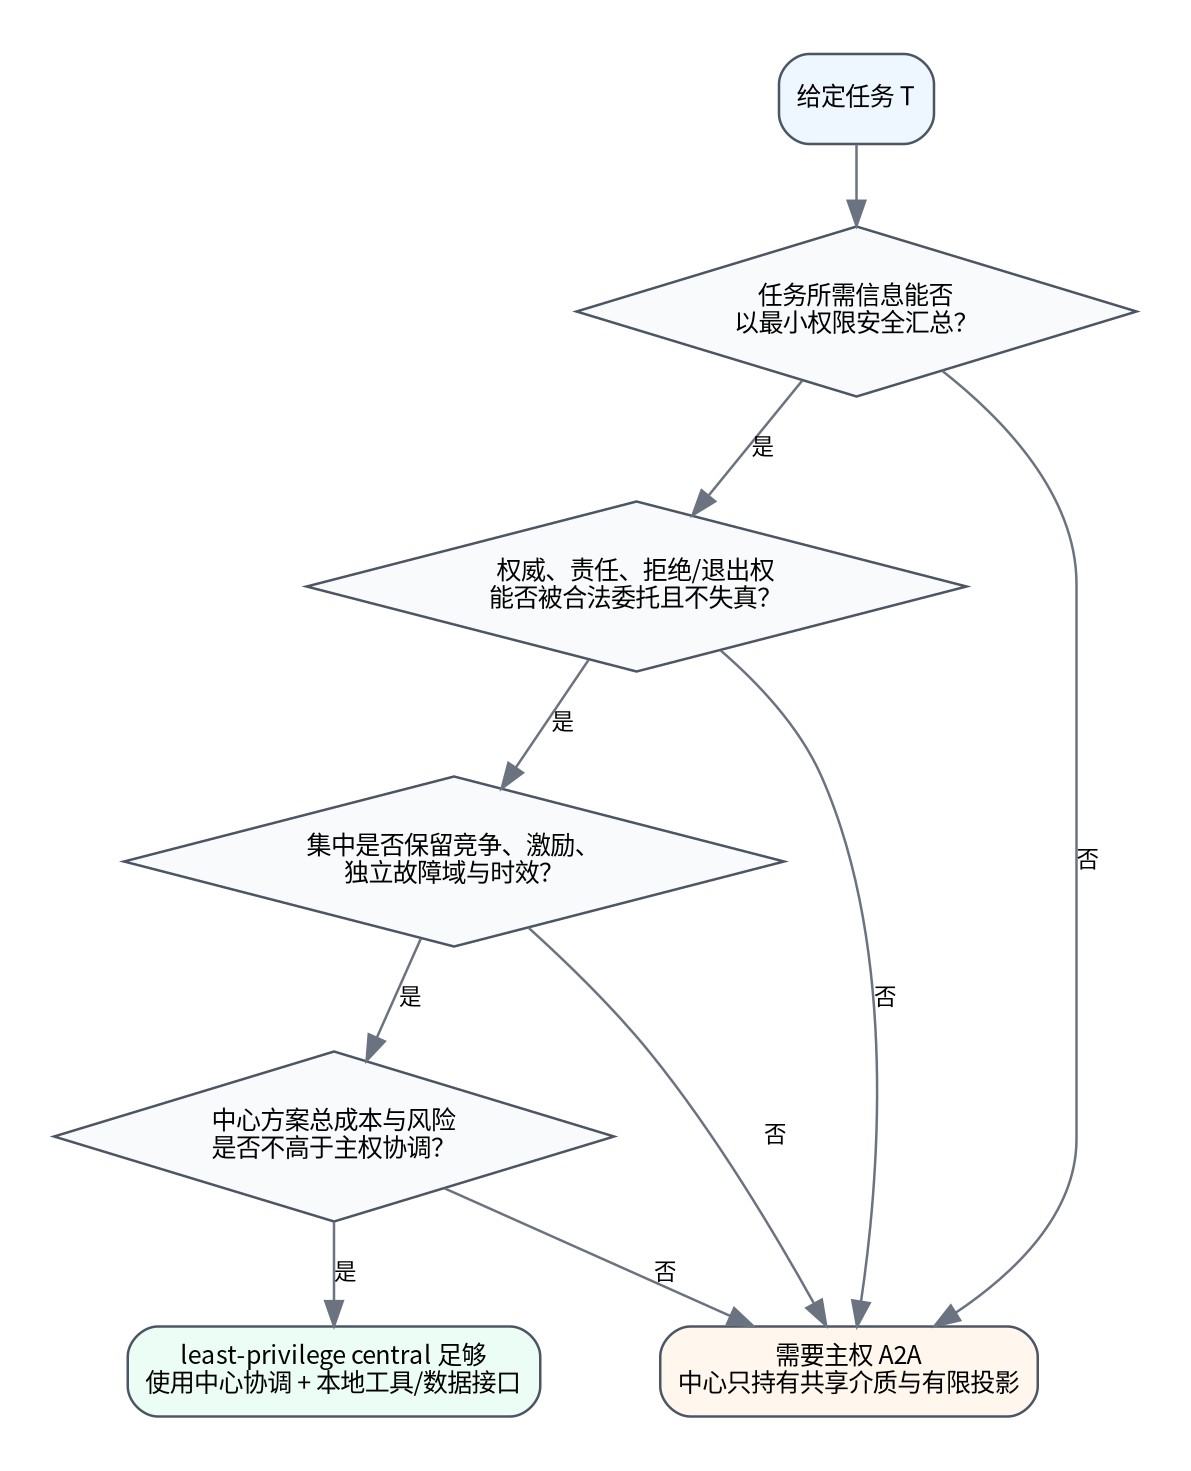
中心化可以提供高效索引、公共计算、市场流动性、标准执行和争议规则;其问题不在“中心”本身,而在于中心是否错误地声称能够无损代表所有主体的私有世界、权威和价值。相反,部署上分布式的多个进程若都由同一主体、同一目标和同一权限控制,结构上仍可被一个中心无损模拟。
本文因此以权威拓扑而非网络拓扑决定机制。
| 机制 | 适用条件 | 主要风险 | |---|---|---| | SELF_EXECUTION | 同一责任根、低外部性、Mandate 清晰 | 内部角色冲突、越权 | | DETERMINISTIC_SERVICE | 规则、输入和 Effect 稳定 | 漂移、错误继承 | | PLATFORM_MARKET | 商品标准化、字段成熟、平台保障充分 | 平台目标优先、数据锁定 | | CENTRAL_OPTIMIZER | 可集中计算,权威可保持 | 目标函数替代主体目标 | | HUMAN_BROKER | 高语境、身份、关系与隐性判断重要 | 不可扩展、信息不透明 | | BILATERAL_FORMATION | 两个不可替代主体需共同形成条件 | 协调成本、策略行为 | | TEMPORARY_COALITION | 多方互补、单体能力不足 | 高阶依赖、责任分散 | | HUMAN_ADJUDICATION | 争议、救济、价值冲突或高不可逆性 | 延迟、偏见、成本 |
机制不是互斥分类,而是可组合序列。
定义 22(CollapseSafe)。 对任务 (T),若存在中心机制 (C) 能在不改变以下要素的情况下实现与联邦机制等价的可达行动和结果,则任务可安全折叠:
[ CollapseSafe(T):=I_S(T)\land O_S(T)\land(Cost_C\le Cost_F). ]
其中,(I_S(T)) 当且仅当制度框架充分、权威保持且 Standing 保持;(O_S(T)) 当且仅当必要信息可在授权范围内集中、结果语义不被压平且漂移可被现有复核能力管理。
其中:
CollapseSafe 是充分性候选,不是自动分类真值。系统应输出理由和缺口,而不是一个不可解释布尔值。
 {width=78%}
Router 的输入至少包括:
institutional_sufficiency
relation_schema_openness
authority_topology
information_locality
privacy_and_rights
externality_and_standing
irreversibility
uncertainty_and_drift
resource_coupling
standardization
need_for_high_context_judgment
dispute_state
coordination_cost_budget
输出不是单一机制标签,而是一个有前后置条件的机制图:
[ Plan = \langle nodes, transitions, authority\ gates, effect\ gates, fallback \rangle. ]
一个 OPC 定制 AI 服务可能采用:
平台/中心索引发现候选
→ 人类经纪解释高语境需求
→ 双边形成数据与交付条件
→ 本地 Boundary Oracle 验证权限
→ 中心优化器安排时间和资源
→ 原子资源预留
→ 确定性服务执行付款和凭证
→ Agent 在受限环境执行 Operation
→ 买方目标域确认 Effect 与 Adoption
→ 有权主体完成 Acceptance
→ 稳定部分编译为重复服务
这里没有“全程 A2A”或“全程中心化”。不同机制在同一关系的不同子问题上承担最合适的工作。
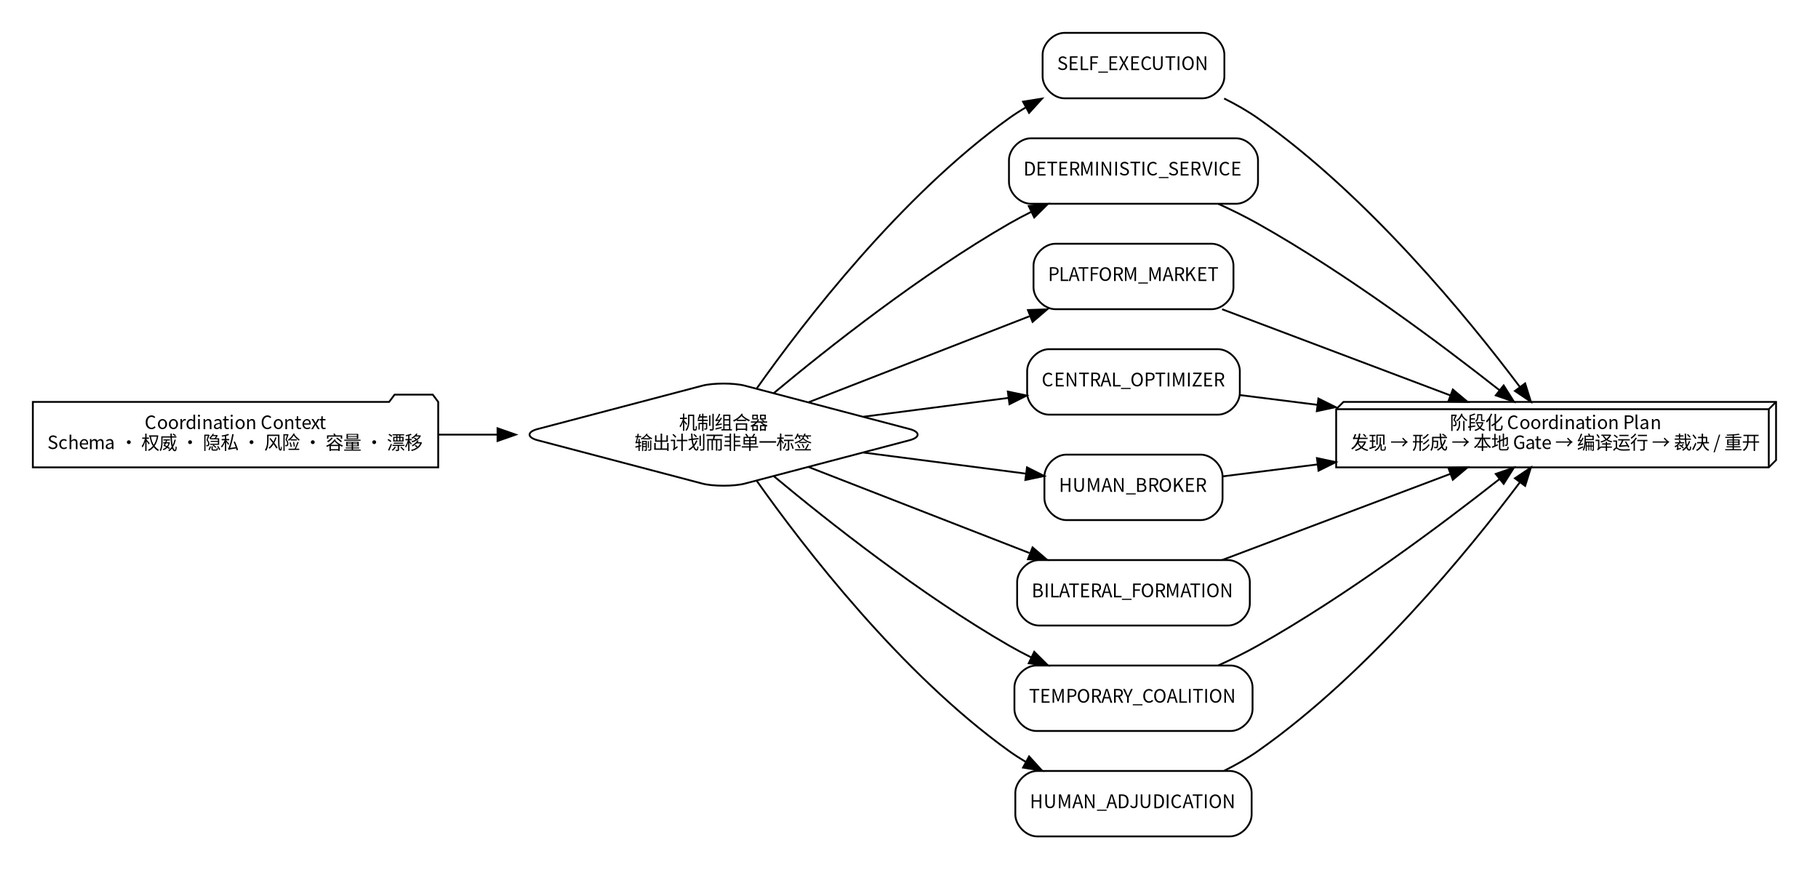 {width=94%}
机制组合可以由 Agent 根据上下文自动生成,但不能不可解释地扩大权力。每次 material route change 必须说明:
“涌现”指从任务和权威拓扑中动态构造机制,而不是允许模型自定治理。
机制组合器不以成交率最大化为唯一目标。系统输出至少包括:
COMMIT
REJECT
CONDITIONAL
DEFER_UNKNOWN
WITHDRAWN
DISPUTED
REOPEN
定义真实处置时间 (T_{truth}) 为:从事项进入系统,到它首次达到一个与当前证据、权威和 Effect 相符且可解释、可重开的稳定状态所需时间。一个快速、证据充分的 Reject 可能优于高成交率但后续反悔的机制。
可比较目标为:
[ C_{process}=C_{attention}+C_{disclosure}+C_{coordination}+C_{verification}, ]
[ L_{error}=L_{false\ commit}+L_{false\ reject}, ]
[ J=V_{realized}-C_{process}-L_{error}-R_{externality}. ]
未来真实实验应比较平台、强中心 Agent、优秀人类经纪和组合 Router 在该目标上的表现,而不是只比较最终是否成交。
将 OPC 理解为“员工数为一的公司”会低估其结构。大型企业通过岗位、部门、预算、法务、审计和信息系统把不同权威分开;OPC 往往由同一人承载,却通过多个 Agent、平台、账户、外包方和临时伙伴扩展执行能力。这种结构具有四个特点:
因此,OPC 的 Agent 系统不能只追求“自动化更多”,而应优化:哪些判断值得保留给人,哪些关系可以编译,哪些能力可以临时形成,哪些承诺必须被资源和证据约束。
OPC Operating Envelope 是一个派生视图,而非新的事实 root。它汇总:
[ OE_t = \langle OE_{norm}, OE_{capacity}, OE_{run} \rangle, ]
[ OE_{norm} = \langle objectives, roles, mandates, commitments \rangle, ]
[ OE_{capacity} = \langle resources, capacity, risk, attention \rangle, ]
[ OE_{run} = \langle relationships, compiled\ routines \rangle. ]
该视图回答:当前 OPC 在什么边界内能够安全行动,哪些资源已被承诺,哪些 Agent 有何权限,哪些关系处于形成或运行,哪些异常需要本人处理。
它不等于一个固定“用户画像”。其数据来自权威对象和事件图,并随着 Mandate、Commitment、Effect 和 Defeater 更新。
三维统一模型是理论坐标;OPC 十二阶段是面向运行的操作视图:
确认自然人/法人身份、账户所有权、代表关系、签署和接受权。输出不是“已登录”,而是可追溯 Authority Root。
把“帮我处理业务”转化为版本化目标、动作、金额、数据、风险、升级、撤销和过期规则。高风险动作需要更窄 Mandate。
从邮件、文档、项目、日历、财务、工具和人的判断中生成任务相关投影;保留来源和不可数字化 Gate,不构造伪完整人格模型。
发现潜在客户、伙伴、资源或组合机会,并判断当前问题是否已经有稳定制度和字段,还是需要构成新的 Relation Schema。
Router 选择平台、中心优化、人类经纪、双边形成、临时联盟、确定性服务或人工裁决的组合。
通过边界问题、countercondition、sandbox 和可逆现实动作形成条件,而不是只交换长文本。
引入模型、工具、伙伴、预算和执行环境;CRA 资格化可交付范围和恢复能力。
相关角色对精确 RelationVersion 作出 Stance,必要资源原子预留,明确退出、违约和数据权利。
编译最小权限 Operation,执行并由目标域 witness 观察真实变化。
分别处理目标域采用、主体接受、付款、争议和补救,不用“完成”覆盖全部状态。
记录实际数据使用、派生、长期记忆和训练更新;根据 Mandate 决定保留、删除或再利用。
能力、权威、环境、价值或外部性变化只重开依赖闭包;稳定部分继续运行。
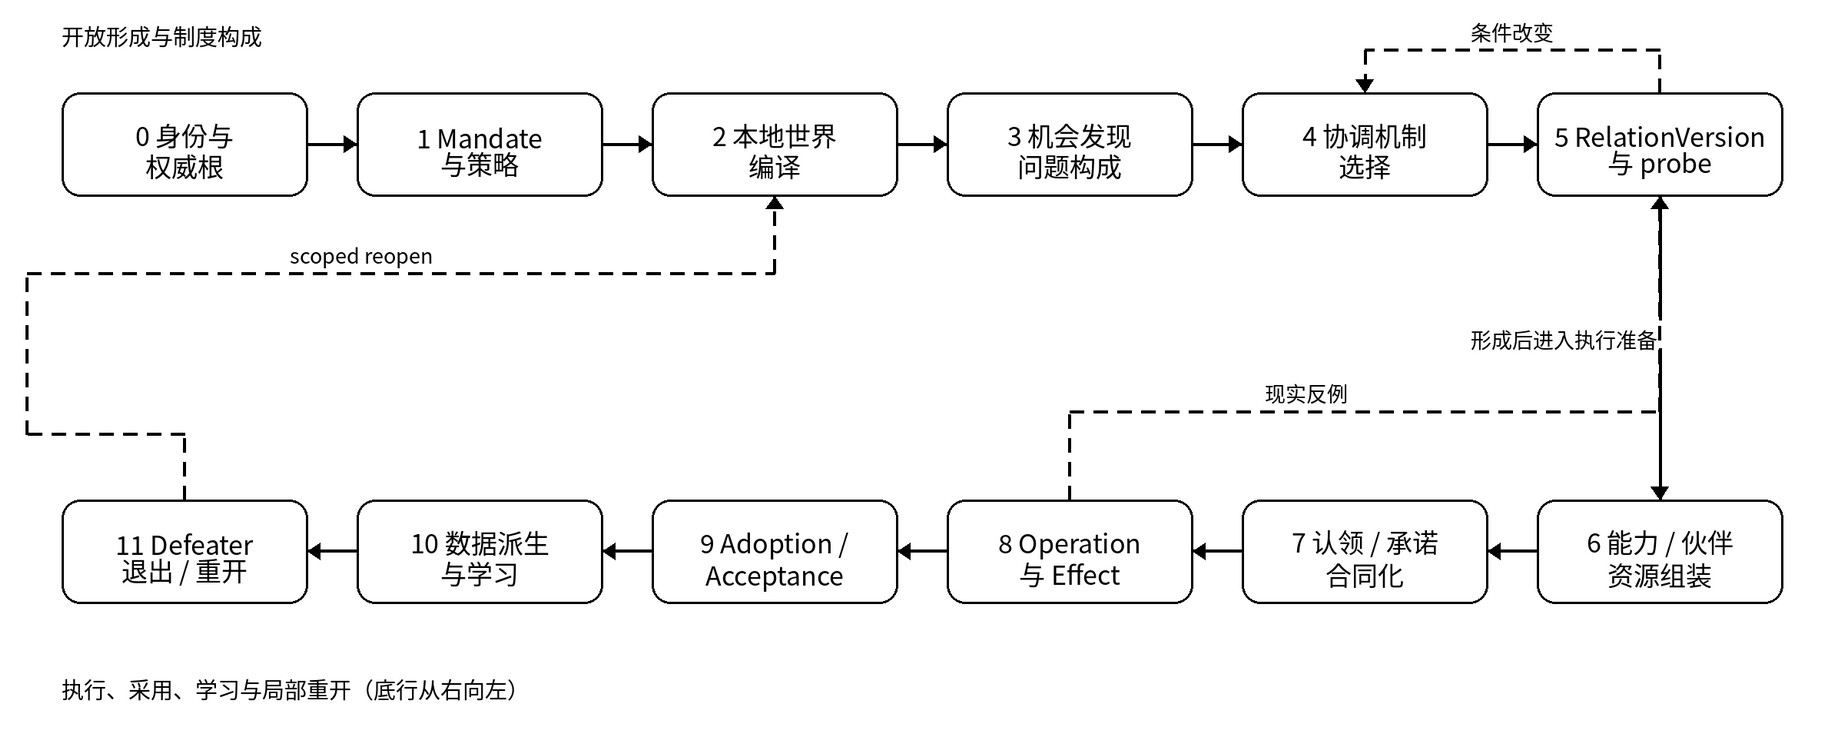 {width=96%}
一个信任根内部可能存在多个主体性来源。例如创始人本人既有商业目标,也有个人边界;品牌合作 Agent 追求曝光,财务 Agent 追求现金流,交付 Agent 追求技术质量。它们并不是独立法律主体,却可能代表不同局部目标和权限。
系统不能简单以“最终都是同一个人”消除冲突。需要:
例如订阅、支付、报税和固定模板交付。若制度充分、数据可授权集中、Effect 可观察,应优先平台或确定性服务。
需求、数据、交付、知识产权和接受标准未完全定义,需要双边形成与现实 probe;稳定后可以编译为重复模板。
多个超级个体联合投标、共同交付或资源互换。关键是高阶互补、资源预留、对外责任和客户 Acceptance。
商业、品牌、内容、时间和声誉角色同时存在。模型可以生成报价与创意,但本人对调性和长期关系的认领不可被自动化吞并。
训练、派生、保留和再披露权往往比“是否上传原始数据”更关键。最小可行路径可能是代码进入数据域,而非数据离开主体。
交付已发生但对方拒绝接受,或 Agent 越权承诺。系统必须保留旧版本、Effect 证据、Mandate、补救和人工裁决。
面向 OPC,系统价值不应只用成交率衡量。本文提出六项可测量假说:
这些假说需要真实 OPC 前瞻性实验,当前尚未建立 E7 证据。
系统架构分为四个逻辑平面:
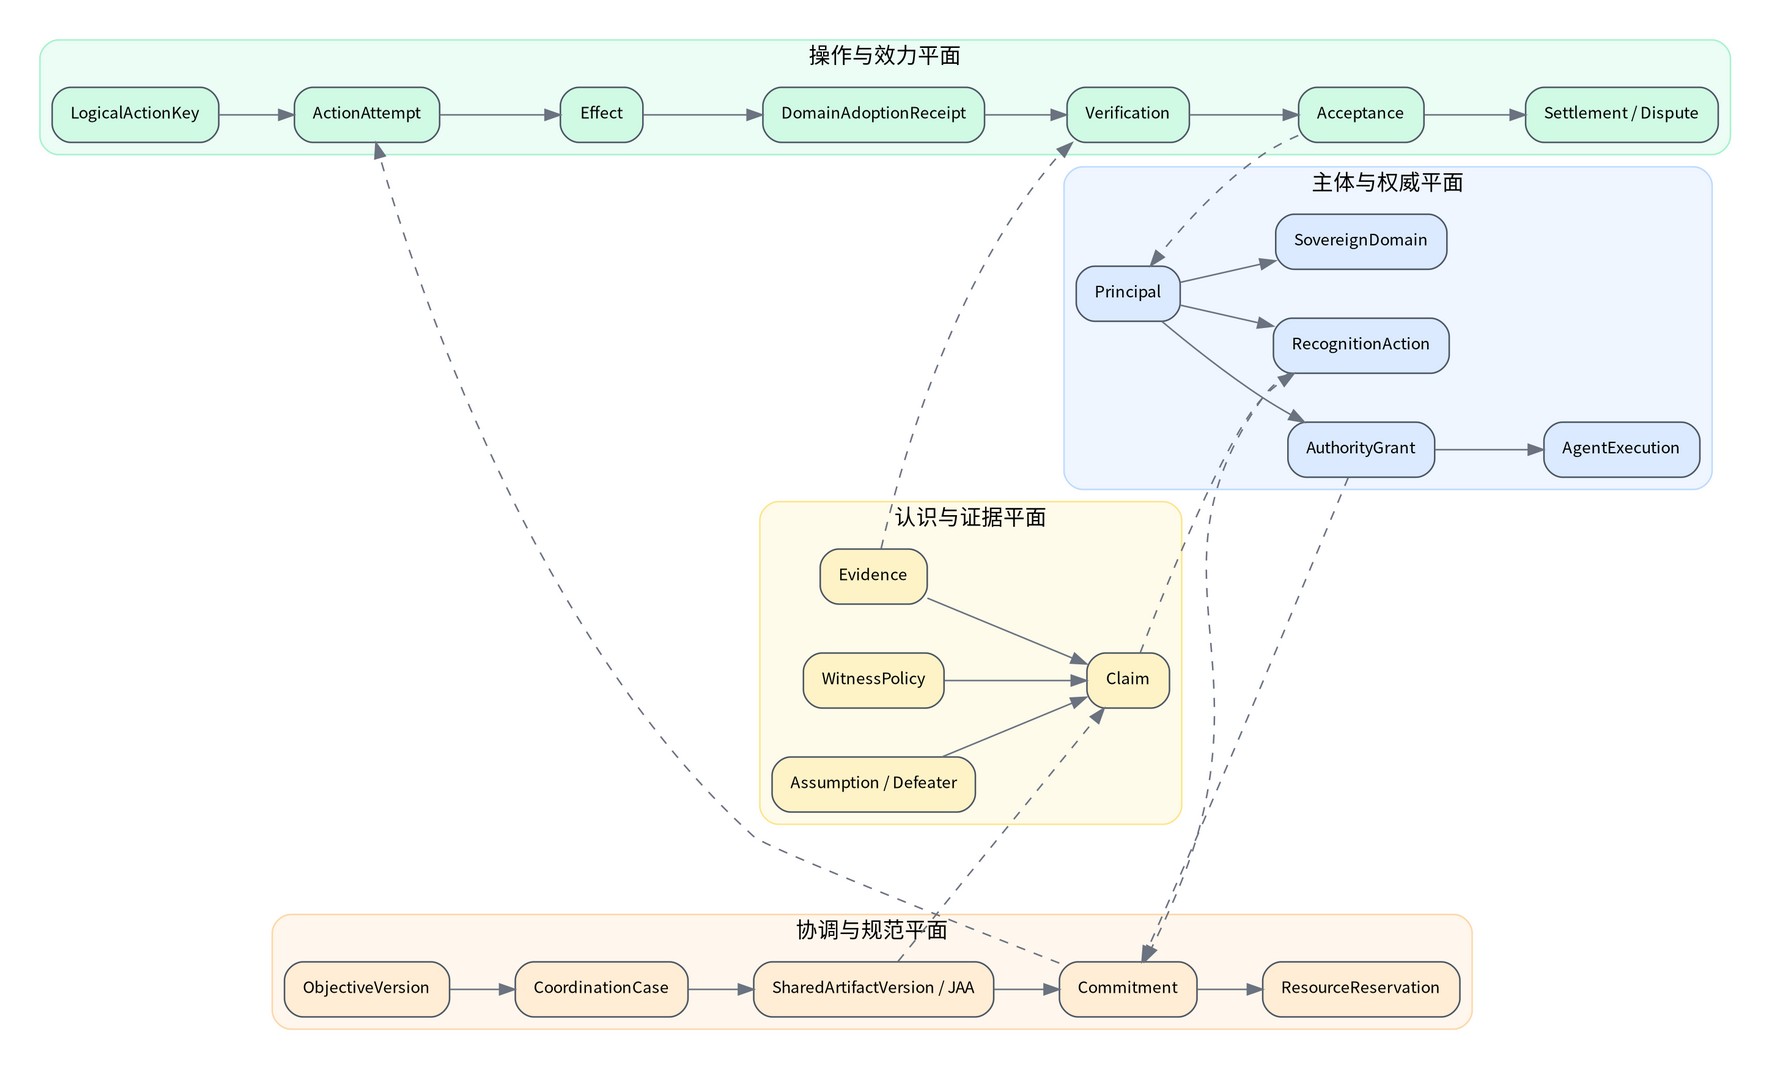
四平面通过联邦事件图连接。每个主权域维护自己的权威事实,跨域系统保存可验证引用、版本和事件,不要求一个全局数据库成为所有事实的最终来源。
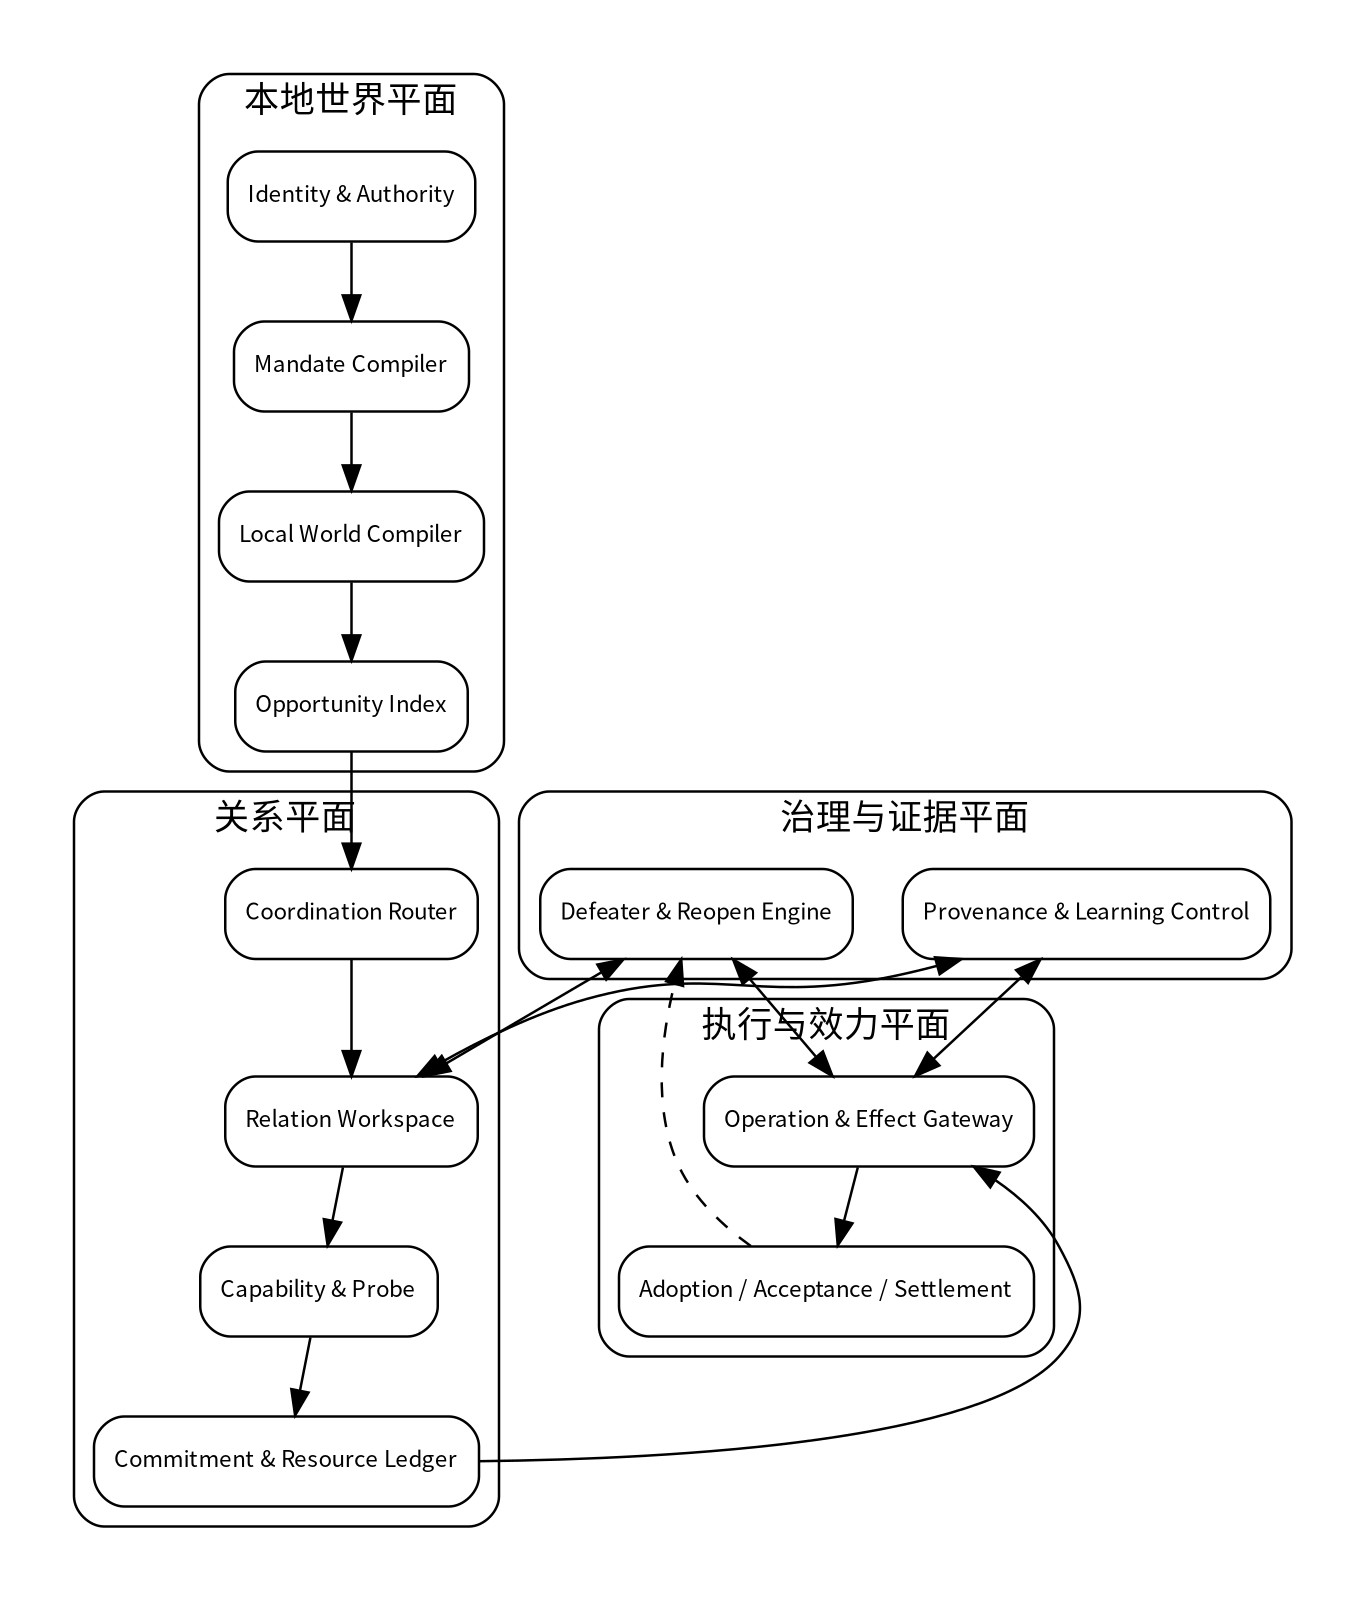 {width=96%}
当前最小权威对象保持六类:
外部身份、信任根和责任关系。
范围化、版本化、可撤销委托。
具体共同关系的版本化 Schema、参数、参与者、条件和依赖。
带来源、置信、证据、有效期和可反驳性的主张。
产生未来义务、资源和补救的规范对象。
可执行、幂等、可观察 Effect 的动作规范。
其他结构应优先表示为事件、属性、溯源边、策略或派生视图。只有出现独立权威和生命周期需求时才提升为 root。
事件最小包络用于绑定事件类型、主体、相称权威、精确关系版本、证据、时间与前序事件,使跨域状态变化能够被引用和审计。
〔公开版删改 · R-12〕 本处原文给出字段级事件包络 JSON,属于可直接实现的协议规格。公开版移除具体字段与示例值,保留其概念职责。位置与理由见包内
REDACTIONS.md。
包络保证来源、顺序和引用,但事件语义由具体类型和相称 Authority 决定。哈希链有助于审计,不等于去中心化账本,也不替代真实身份和目标域 witness。
事件至少覆盖:
ASSERTION_CREATED / CHALLENGED / SUPERSEDED;BOUNDARY_ASSESSMENT;SCHEMA_REVISION_PROPOSED / MATERIALIZED;STANCE_RECOGNIZED / REJECTED / CONDITIONAL / WITHDRAWN;MANDATE_ISSUED / NARROWED / REVOKED / EXPIRED;RESOURCE_RESERVED / RELEASED / CONSUMED;COMMITMENT_CREATED / ACTIVATED / FULFILLED / BREACHED;OPERATION_SPECIFIED / ATTEMPTED;EFFECT_CONFIRMED / PARTIAL / UNKNOWN / REVOKED;ADOPTION_RECORDED;ACCEPTANCE_RECORDED / CONTESTED;SETTLEMENT_RECORDED;DEFEATER_RAISED / SCOPE_REOPENED;DATA_USED / DERIVED / RETAINED / DELETED / LEARNING_UPDATED。Boundary Oracle 接收任务、关系版本、候选、所请求主张、披露预算与授权范围,在保持本地权威的前提下返回可行性、证据、反条件、未知或拒绝等受控判断。
〔公开版删改 · R-13〕 本处原文给出接口签名、入参与返回字段,属于可直接实现的协议规格。公开版移除具体签名与字段列表,保留接口的概念职责。位置与理由见包内
REDACTIONS.md。
confidence 和 authority 必须分别记录。模型高置信异议不能被编码成有权拒绝;真实主体拒绝可以没有模型解释。
Context Compiler 将主体本地世界编译为任务相关上下文包,而不是上传全部历史。其职责包括:
Context Compiler 是 Harness 的核心组件,因为 Agent 的行动质量取决于可用上下文和权限,而不是模型参数 alone。
Coordination Runtime 维护 RelationVersion、JAA、候选、Stance、Commitment 和机制图。它不拥有各主体的全部本地世界,也不自行产生最终权威。其功能包括:
Effect Gateway 把 Operation 连接到目标世界。它负责:
Effect Gateway 可以由支付、代码托管、日历、ERP、CRM、文件系统、区块链、法律签署或人工回执实现。
Event Ledger 保存不可覆盖的因果和权威历史;Compiled World 提供当前可运行视图。二者关系类似:
[ CompiledWorld_t = Fold(EventLedger_{\le t}, valid\ policies, local\ facts). ]
若事件被撤销或新 Defeater 出现,视图重算或局部失效。Compiled World 不能绕过原始 Authority 直接修正事实。
用于 Agent 发现、Task、Message、Artifact 和长任务状态。A2A Task 可以承载 Operation 或形成任务,但其 completed 状态不能自动映射为业务 Acceptance。
用于工具、资源和本地服务访问。MCP authorization scope 映射到 Mandate 的资源动作子集;RelationVersion 仍提供目标、数据派生、Effect 和接受语义。
OAuth 和新型 Agent Mandate 草案可绑定令牌、任务和委托链;VC 可承载身份、资格和授权声明。适配器必须保留发行者、持有者、受众、有效期和撤销,并避免把可验证声明误写成真实世界充分证据。
WoWok 一类可编程信任对象可以承担托管、权限、服务、Treasury、仲裁和 Repository 等 Effect 基础设施。本文把它视为可替换 TrustAdapter,而非理论前提或唯一实现。
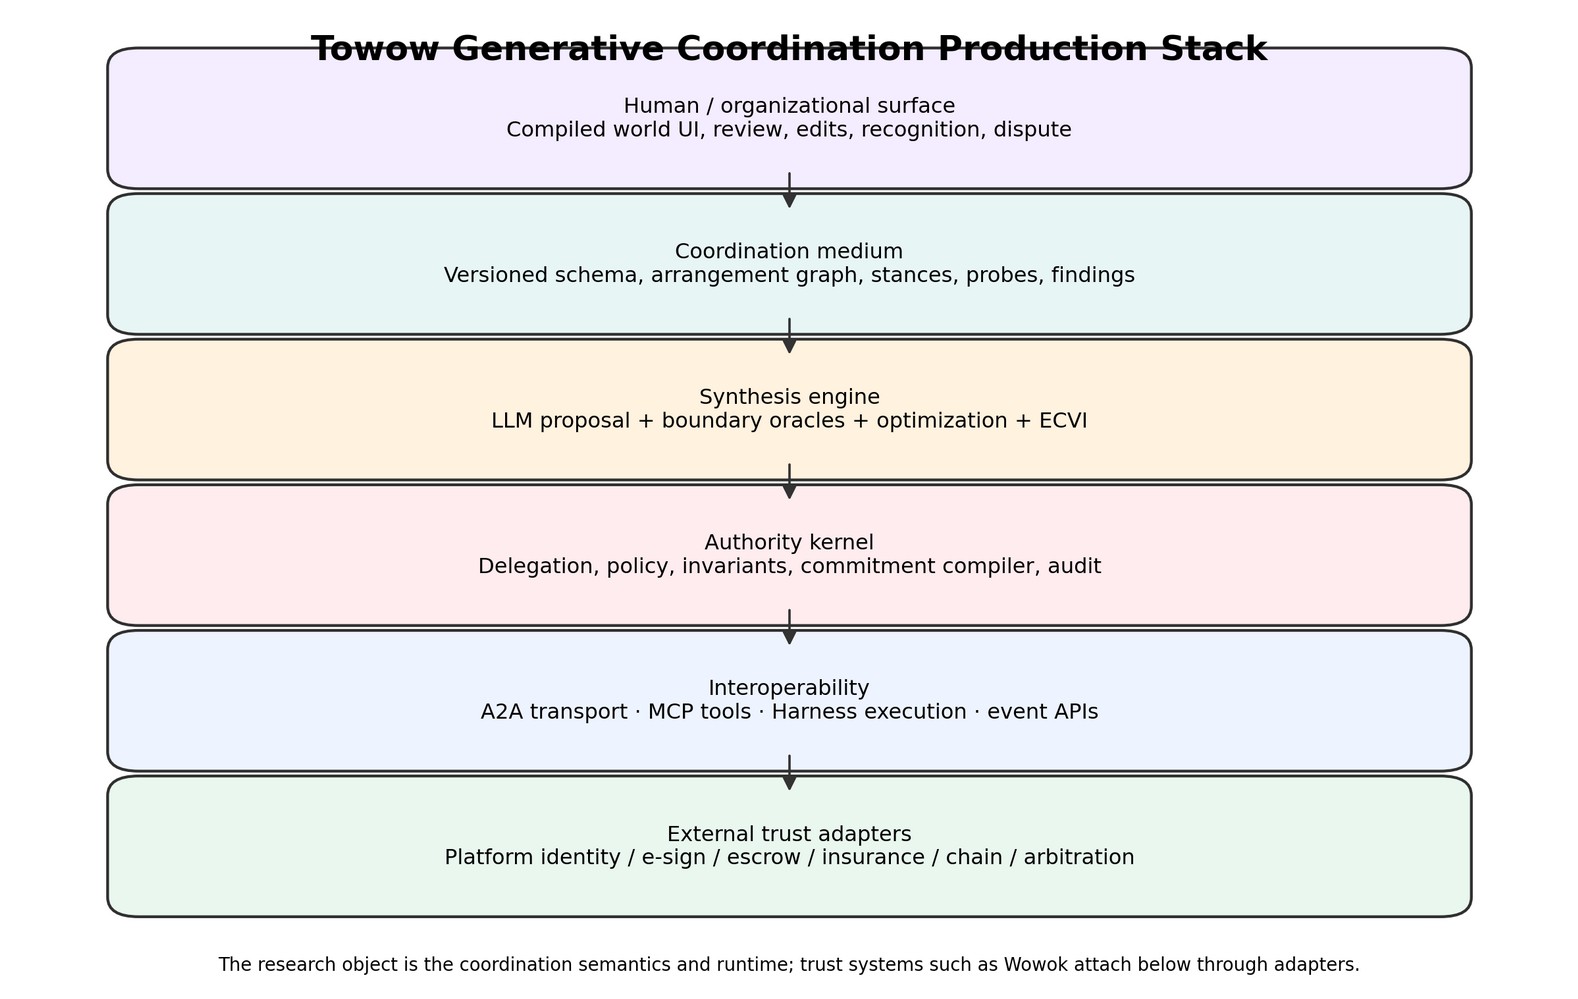 {width=82%}
建议的生产栈包括:
正式系统不应从“搭一个通用 Agent 市场”开始。最小纵向闭环为:
只有该闭环真实运行后,横向扩展发现市场和开放协议才不会失去现实语义。
Fieldkit 当前仅验证研究对象与状态机;生产系统至少还需要:
本节给出一组足以约束系统设计、但不冒充现实普遍定理的形式结论。所有命题的假设均明确列出;当假设不满足时,本文给出反例或将结论降级为设计原则。
设有主体集合 (I={1,\ldots,n})。主体 (i) 在时刻 (t) 的主权世界为 (W_i(t)),本地可执行动作集合为 (A_i(W_i,t)),本地 Authority 集合为 (U_i(t))。一个联合动作是超边:
[ a = \langle I_a, {a_i}_{i\in I_a}, \Gamma, pre, eff, acc \rangle, ]
其中 (I_a\subseteq I) 是参与主体,(a_i) 是本地贡献,(\Gamma) 是关系模式,pre 是前置条件,eff 是目标 Effect 语义,acc 是接受与结清条件。
主体对外暴露的静态投影为:
[ \pi_i: W_i \rightarrow Z_i. ]
协调过程 (\mathcal{P}) 可以自适应向本地 Oracle 发送查询 (q_k),接收响应 (r_k),生成 RelationVersion、候选、证据和 Stance。过程历史为:
[ h_k = (q_1,r_1,\ldots,q_k,r_k). ]
最终输出处置:
[ \Omega_1={COMMIT, REJECT, CONDITIONAL}, ]
[ \Omega_2={DEFER, WITHDRAW, DISPUTE}, \qquad y\in\Omega_1\cup\Omega_2. ]
命题 1(静态投影非普遍充分)。 设主体世界集合 (\mathcal{W}) 允许任务后能力形成、授权变化或伙伴引入;任务族 (\mathcal{T}) 对这些变化敏感。对任意有限静态投影 (\pi: \mathcal{W}\rightarrow Z),存在 (W,W'\in\mathcal{W}) 与任务 (T\in\mathcal{T}),使得:
[ \pi(W)=\pi(W'), \quad f_T(W)\neq f_T(W'). ]
因而 (\pi) 不是 (\mathcal{T}) 上的充分统计量。
证明草图。 因 (Z) 有限或固定容量,而 (\mathcal{W}) 包含投影后才发生的形成行为,取两个在 (t_0) 所有公开字段相同的世界。令 (W) 中主体在候选出现后能够通过工具 (g)、伙伴 (j) 或新增 Mandate 形成动作 (a),而 (W') 中不能。构造任务 (T) 的成功条件为动作 (a) 可达。则静态投影相同而任务判断不同。矛盾。□
适用边界。 若任务族、动作集合、制度框架和形成算子均有限且已被编码,有限投影可以充分。命题反对的是开放任务族上的普遍充分性,不反对标准平台字段。
设计后果。 公共 profile 只能作为发现入口;系统必须允许任务相关 Oracle、现实 probe 和版本化更新。
假设 A。 对固定任务 (T),每个主体的本地可行集合 (K_i\subseteq\mathbb{R}^d) 非空、闭、有界且凸;存在多项式时间分离 Oracle;共同目标函数 (c^Tx) 已被相称主体认领;权威、资源和 Effect 语义已固定。
命题 2(交互边界充分性)。 在假设 A 下,无需复制完整 (K_i),协调器仅通过分离 Oracle 即可在给定精度 (\epsilon) 内判定 (\bigcap_iK_i) 是否为空,或找到 (\epsilon)-近似可行解,并优化 (c^Tx) 到相应精度。
证明草图。 由分离—优化等价和椭球/切平面方法,分离 Oracle 足以对凸可行域进行可行性判定和线性优化。协调器维护外近似,Oracle 对不可行候选返回支持超平面,迭代收缩直至找到近似可行点或证实交集为空。局部集合内部表示无需暴露。□
限制。 该命题不覆盖:离散组合、非凸能力、语义歧义、策略性 Oracle、变化偏好、未知权威和第三方外部性。现实系统因此扩展响应为 COLUMN、UNKNOWN、HUMAN_REFUSAL 和 COUNTERCONDITION,并把数学可行性与规范闭合分开。
设计后果。 “体—边对偶”作为隐私保护接口有严格局部基础,但不能被写成通用社会定理。
命题 3(超边反例)。 对任意 (k\ge3),存在 (k) 个主体和一个联合行动,使得任意大小小于 (k) 的子集均不可行,而全集可行。任何仅依据成对边权并要求至少一条正权边才能扩展候选的匹配机制,都无法发现该联合行动。
构造。 令主体 (i) 提供必要资源 (r_i),联合行动要求 ({r_1,\ldots,r_k}) 全部存在。任意真子集缺至少一个必要资源,效用或可行性为零;全集效用为正。所有成对边权为零,成对机制不会生成全集候选。□
设计后果。 发现层需要开放贡献模式、列生成或临时联盟构成;主体 profile 不能只描述“我能独立做什么”,还应允许“在条件 X 下我可贡献什么”。
设执行器能力参数 (\kappa) 单调提高某类动作的成功概率 (p_{succ}(a;\kappa))。有效 Mandate 覆盖动作集合 (A_M),但执行器候选集合为 (A_C\supset A_M)。若控制机制允许未经授权候选进入执行,则未经授权 Effect 的期望数为:
[ \mathbb{E}[U(\kappa)] = \sum_{a\in A_C\setminus A_M} P(select(a;\kappa)),p_{succ}(a;\kappa),P(effect\mid success). ]
命题 4。 若存在一个未经授权动作 (a) 使选择概率不随 (\kappa) 下降到零,且 (p_{succ}(a;\kappa)) 随能力严格上升,则能力提高可以严格增加未经授权 Effect;即使未经授权动作占全部 Attempt 的比例下降,该绝对风险仍可上升。
证明。 对该动作的乘积项严格上升,其他项非负,故期望不减并可严格增加。比例指标以总 Attempt 为分母,可因授权动作增长更快而下降,不改变绝对 Effect 数。□
反例意义。 “更聪明的模型会更懂用户、所以更安全”不是一般结论。安全来自精确 Mandate、pre-effect Gate、witness 与撤销,而非模型暂时做不到。
定义 23(Reachability)。 若存在某执行序列从状态 (s) 到目标状态 (s'),则 (s') 对系统可达。
命题 5。 Reachability 既不推出 Effect reliability,也不推出 Adoption 或 Acceptance。
证明(反例)。 构造一个脚本能够在理想网络条件下偶尔写入目标系统,因此目标状态可达;但网络故障时无恢复,可靠性低。再令目标系统自动写入但业务负责人拒绝采用,则 Effect 存在而 Adoption 不存在;或目标域已临时采用但合同验收失败,则 Adoption 存在而 Acceptance 不存在。□
设计后果。 CapabilityEnvelope 必须包含条件和恢复;Effect、Adoption 和 Acceptance 必须独立事件化。
设审计查询集合 (Q_{audit}) 包括:
比较两种表示:
命题 6。 若 (S_t) 不保存等价的历史、来源和依赖信息,则存在 (q\in Q_{audit}) 无法仅由 (S_t) 唯一回答;而包含完整编码的 (G_t) 可以回答。
证明。 取两个不同历史 (h,h') 最终产生相同当前字段,但一个由有权 Locus 认领,另一个由无权模型写入。覆盖式 (S_t) 相同,查询“谁认领”答案不同,故无法唯一回答。事件图保留不同来源与版本,可区分。□
限制。 若单一状态额外保存所有历史与依赖,它事实上已经实现了等价事件图。命题说明的是信息保存下界,而非某种数据库品牌天然优越。
设共享资源容量 (B),每个承诺请求 (r_j>0)。系统使用线性化的 reserve(r_j):仅当当前已预留总量 (R+r_j\le B) 时原子成功,并立即更新 (R)。
命题 7。 在所有并发历史中,成功预留集合满足:
[ \sum_{j\in Success} r_j \le B. ]
证明。 按线性化顺序归纳。初始 (R_0=0\le B)。每次成功操作仅在 (R_k+r_j\le B) 时将 (R_{k+1}=R_k+r_j),失败操作不改变 (R)。故不变量始终成立。□
反例。 check-then-write 将检查与更新分开,两个请求可同时读取同一余额并均通过,破坏不变量。
设计后果。 Commitment 激活前必须先预留关键资源;eventual consistency 适合草稿,不适合同一稀缺资源的最终承诺。
设关系图 (G) 无环或其强连通分量已压缩,节点 (n) 的语义由直接前驱的版本决定。变化 (\Delta n) 若不改变任何下游节点的可达动作、义务、witness、数据权利或接受条件,则为 non-material。
命题 8。 在依赖声明完备且语义函数纯粹的假设下,对 non-material (\Delta n) 不重开下游节点,不改变任何已编译 Operation 的合法性;对 material (\Delta n),重开其 material dependency closure 足以阻止受影响旧 Operation 被继续视为有效。
证明草图。 non-material 定义直接保证下游相关语义不变。对于 material 变化,所有受影响节点均位于依赖闭包;将它们降级为待复核使任何依赖旧版本的 Operation 失去 compile-ready 条件。闭包之外节点无依赖路径,语义不受影响。□
限制。 现实依赖可能未被建模、语义函数可能有隐式副作用,故需要运行时监测和人工 Defeater。实验中的零错误只对生成器定义的语义成立。
设同一 OPC 具有至少两个角色 (l_1,l_2),其允许动作集合分别为 (A_1,A_2),且存在动作 (a\in A_1\setminus A_2) 或 (a) 在两角色下具有不同目标/风险。笼统 Mandate (M_g) 不记录 Authority Locus,仅授权“代表我处理业务”。
命题 9。 任何仅依据 (M_g) 的执行策略,无法在所有情形中同时实现:对 (l_1) 允许的动作不误拒绝,以及对 (l_2) 禁止的动作不误执行。
证明。 执行器面对同一动作描述 (a) 无法从 (M_g) 区分当前角色。若执行,则在 (l_2) 情形越权;若拒绝,则在 (l_1) 情形损失授权能力。除非增加角色、目标或上下文信息。□
设计后果。 OPC 即使只有一个自然人,也需要版本化、角色化 Mandate;“用户本人已经登录”不是充分授权。
设联邦机制 (F) 与中心机制 (C) 的结果等价关系不仅比较最终数值,还比较:可达行动、信息披露、本地拒绝/退出、责任归属、Standing、Effect/Acceptance 语义和故障独立性。
命题 10。 若中心机制无法保留上述任一维度,则不存在保持该等价关系的无损折叠。
证明。 直接由等价关系定义。若某维度在 (C) 中缺失,例如中心可替主体接受而主体无退出权,则至少存在一个历史在 (F) 中输出 Reject/Withdraw,在 (C) 中不能产生等价结果,故非等价。□
意义。 该命题并不说明联邦机制更有价值,只说明何时“中心 Agent 看起来也能完成”不足以证明结构可折叠。若所有维度都可保持且成本更低,应优先中心机制。
设开放形成机制每期成本为 (C_f),确定性运行成本为 (C_c<C_f),环境漂移率为 (d),编译后每次失效的预期损失为 (L(d)),重开成本为 (C_r)。持续编译策略的单位期预期成本:
[ C_{compiled}=C_c + p_{defeat}(d)(L(d)+C_r). ]
命题 11。 当
[ C_c+p_{defeat}(d)(L(d)+C_r)<C_f ]
时,局部编译在期望成本上优于持续形成;反之,持续适应或更频繁复核可能更优。
意义。 形成期—运行期不是价值偏好,而是取决于漂移和失败损失的经济选择。合成实验观察到零漂移时编译优,中等漂移时局部重开优,高漂移时持续适应优,正与该结构一致;但现实参数尚需校准。
上述命题不能推出:
这些必须由激励机制、真实参与者、长期运行和外部性研究补充。
本文用既有实验回答六类问题:
这些问题不等同于“通爻是否成功”。它们分别检验必要部件。最终的真实价值主张仍需 RQ7:真实 OPC 在强基线比较中是否获得更高净价值和长期接受。
| 实验族 | 数据类型 | Principal 真实性 | 最高证据等级 | 主要用途 | |---|---|---:|---:|---| | 协议 v1.5 | 设计、规格、部分合成 | 无 | E0–E2 | 问题和接口谱系 | | R2 Boundary/Team/Prob/Concurrency | 合成生成器 | 无 | E2–E3 | 机制判别 | | R5 本地现实 | 真实 macOS/Git/Docker/文件系统 | 单一人类 owner,技术角色合成 | E4 | Effect、能力与边界工程 | | R5.2 | 真实 Harness 事件与仓库 | 技术域 | E4 | 现实重建和能力 holdout | | R5.4 | 真实模型、多轮协商、合成权威 | 合成 Principal | E6 limited | 语言形成负对照 | | R5C | 两个真实技术权威域 | 非社会 Principal | E5 | 技术域形成闭环 | | v0.4 | 本体/Schema 生成器、Fieldkit | 无 | E2–E3 | 概念收敛和操作化 | | v0.5–v0.6 | 正式公开制度档案 | 真实组织,回溯编码 | E4-H | 现实过程校准 | | QDR | 52 份去标识化访谈、3 份工作簿 | 真实地方机构,非 OPC | H | 机制配置与访谈校准 | | 盲化 checkpoint | 时间截断公共事件 | 真实历史、离线诊断 | H/E2 bridge | 风险扫描器验证 | | 三机制 Replay | 已编码事件 | 表示实验 | E2–E3 | 表示保真 | | OPC fixtures | 24 个构造场景 | 无 | E2–E3 | Router 压力测试 | | Fieldkit v0.7 | 研究仪器、31 测试 | 无 | E3 | 可记录性与状态机 |
R2 使用四个独立生成器:
主要指标为可行率、披露量、成本比、覆盖率、错误率和超卖率。所有结果仅对生成器成立。
R5 在真实本地环境中构造:
R5.2 从真实 Harness 的事件、carrier、sentinel、索引和 fresh readback 重建 17 个场景。基线使用 naive terminal interpretation;显式方法分别重建 Attempt、Effect、Adoption 和 Acceptance。能力 holdout 预先定义六轴合同和 80% 门槛,以真实执行判断预测。
R5.4 使用两个带不同合成权威上下文的真实模型 Agent,围绕真实源码身份与协作问题进行多轮协商。比较:
记录条件数量、拒绝、披露、争议、reopen、签署、补丁、目标域 adoption、AcceptedOriginalValue 和成本。中心综合因 transport failure 未形成公平完整基线,因此任何“A2A 优于中心”结论均被禁止。
R5C 连接 Allbuddy source authority 与 Agent World target authority。实验要求:
结果以本地服务、journal、readback、replay 和 portable verifier 复核。
生成 50,000 个场景,每个场景评估五类数据治理查询,共 250,000 次判断。比较:
指标为查询可区分错误和何时联合制品权利需要独立 ratification。
生成 30,000 个参数、non-material schema 和 material schema 变化。比较:never reopen、always reopen、any schema diff 与 typed materiality checker。ground truth 由生成器的可达轨迹、角色、Authority、Effect、Data 与 Outcome 语义定义。
v0.5–v0.6 选择并购、监管、公共基础设施、开放银行、城市治理和地下水治理等理论样本。选择原则不是代表性抽样,而是最大差异与负控制:既包含关系被扩大/转化,也包含保护性收缩、失败、预留 contingency 和中心制度足够的案例。
七案扩展数据集含 58 个时间事件。每个事件编码:
压缩公告消融只向编码器提供最终公告或摘要,用于比较过程信息损失。
QDR 数据包含 52 份去标识化访谈和 3 份工作簿,原研究关注加州 Sustainable Groundwater Management Act 下地方机构的协调。本文使用它校准“类似顾虑是否决定唯一机制”“Authority、自治、资源和制度框架能否在访谈中被区分”,而不把大型公共治理频率外推到 OPC。
处理流程:
受数据协议限制,逐字文本和行级派生不进入可分享包。
对 Sidewalk、Crossrail、Amazon–iRobot、NASA HLS 等案例构造 11 个时间截点。诊断器只获得截点之前的信息,预测下一真实事件将影响哪些 Relation Schema 维度。比较:
指标为多标签 precision、recall、F1 和完整维度集合 exact match。该实验检验诊断和 probe 排序,不检验商业决策。
将同一 58 事件流分别编码为:
查询 Authority、版本、Standing、Effect 和 Reopen 关系,计算结构召回。版本图与人工 Schema 同构,因此其上限结果是表示保真测试,不能解释为自动抽取或现实价值。
24 个场景覆盖标准支付、报税、品牌合作、定制服务、数据合作、广告预算、资源互换、联合投标、长期联名、争议和内部自执行。比较:
结构有效性要求:必要 Authority 不被合并、不可逆动作有 Gate、资源有预留、Effect 与 Acceptance 分离、争议有冻结与补救、关系变化可版本化。该测试是理论一致性和红队,不是现实成功率。
所有实验存在至少一种威胁:
因此结果章节只报告它们真正区分的机制,不使用“证明整个系统有效”的措辞。
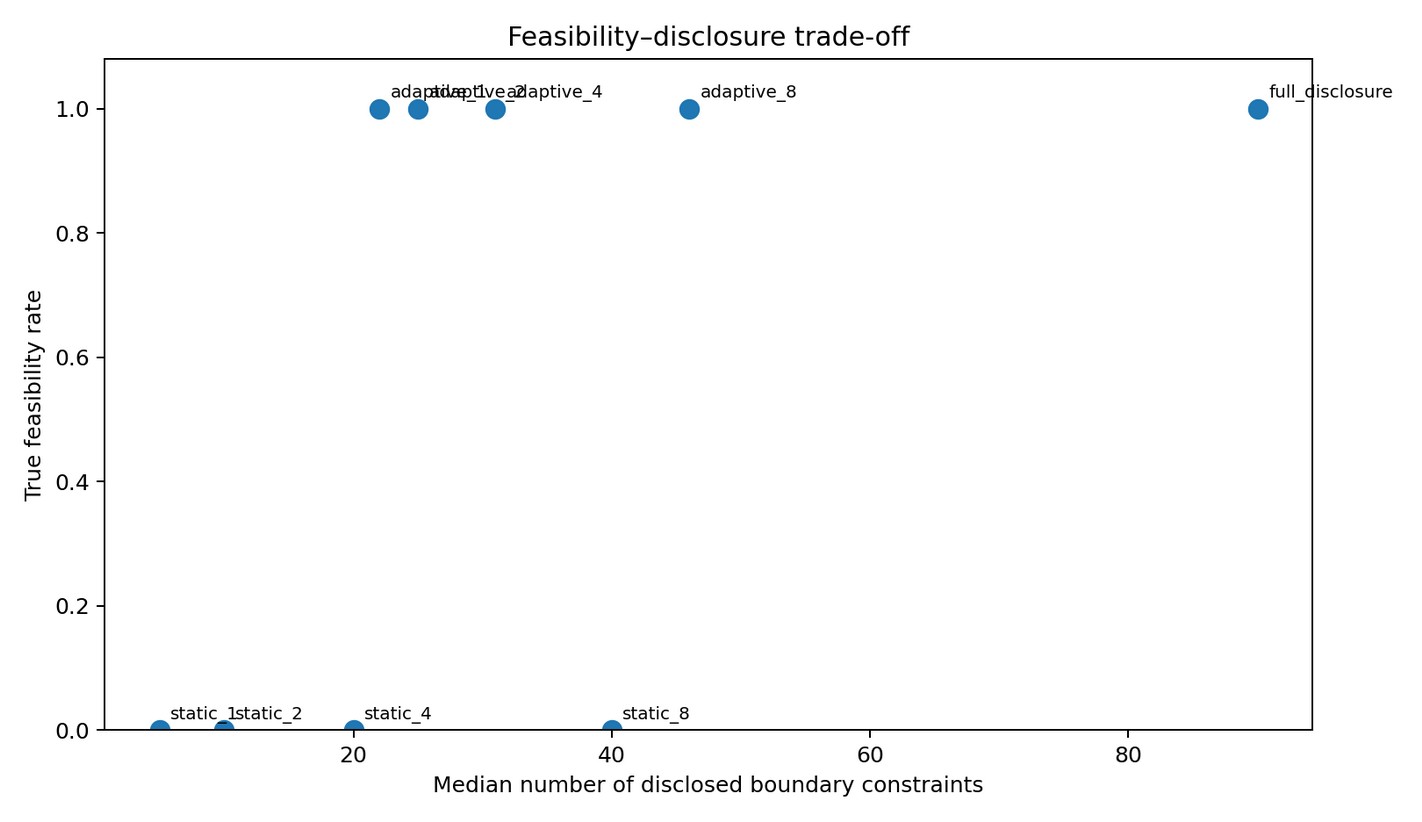
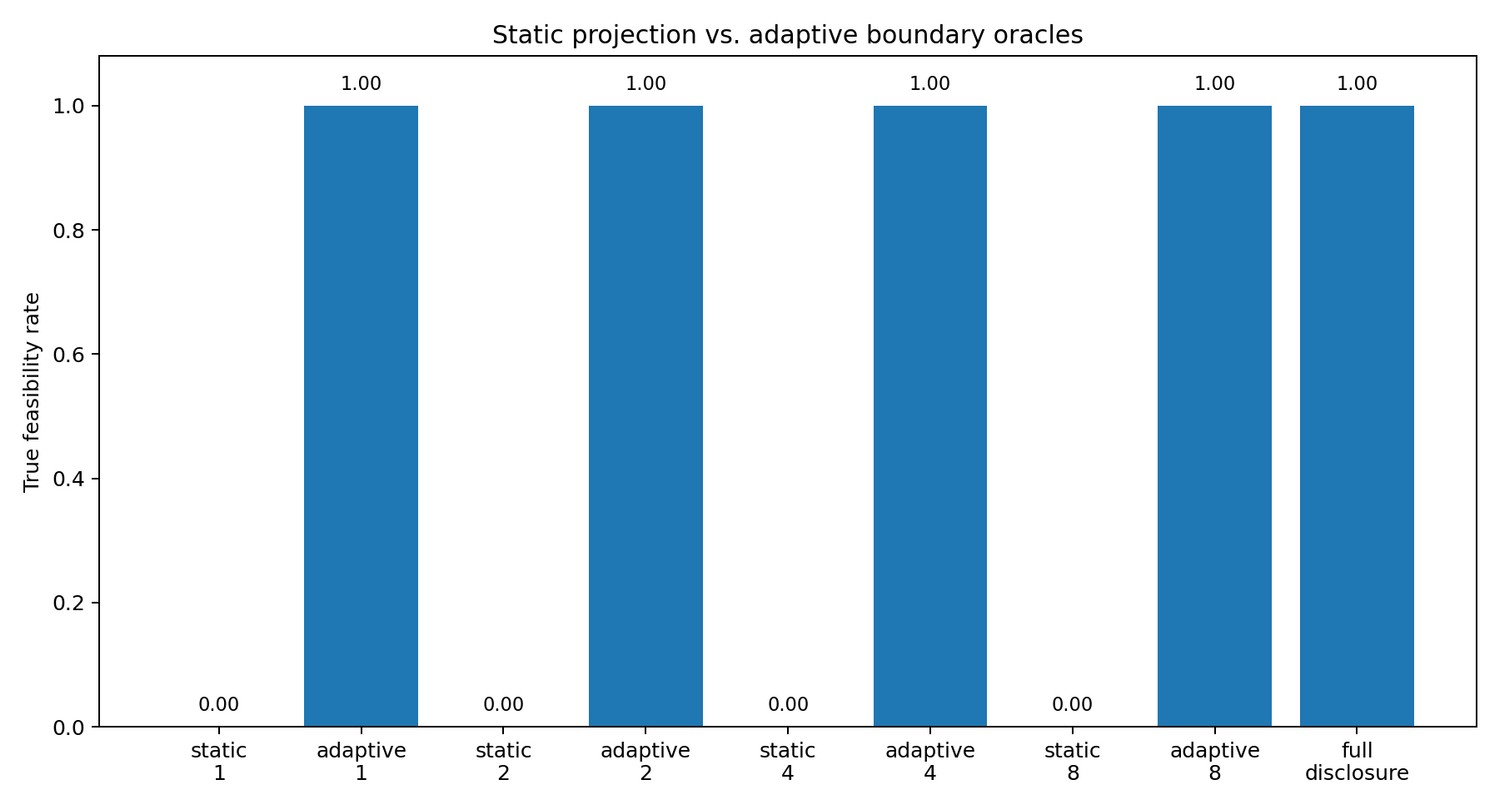
在私有线性约束生成器中,adaptive_1/2/4/8 四种边界轮数的可行率均为 1.0,中位披露量分别为 22、25、31 和 46;完整披露的中位量为 90。静态投影在四种设置中的可行率均为 0。
 {width=78%}
该结果支持一个限域结论:当本地约束能够以任务相关切割表达时,自适应边界可以显著减少披露并保持生成器内的可行性。它不证明现实主体愿意回答,也不证明当前策略在非凸、语言和策略行为中最优。
Design Delta:
在团队构成生成器中:
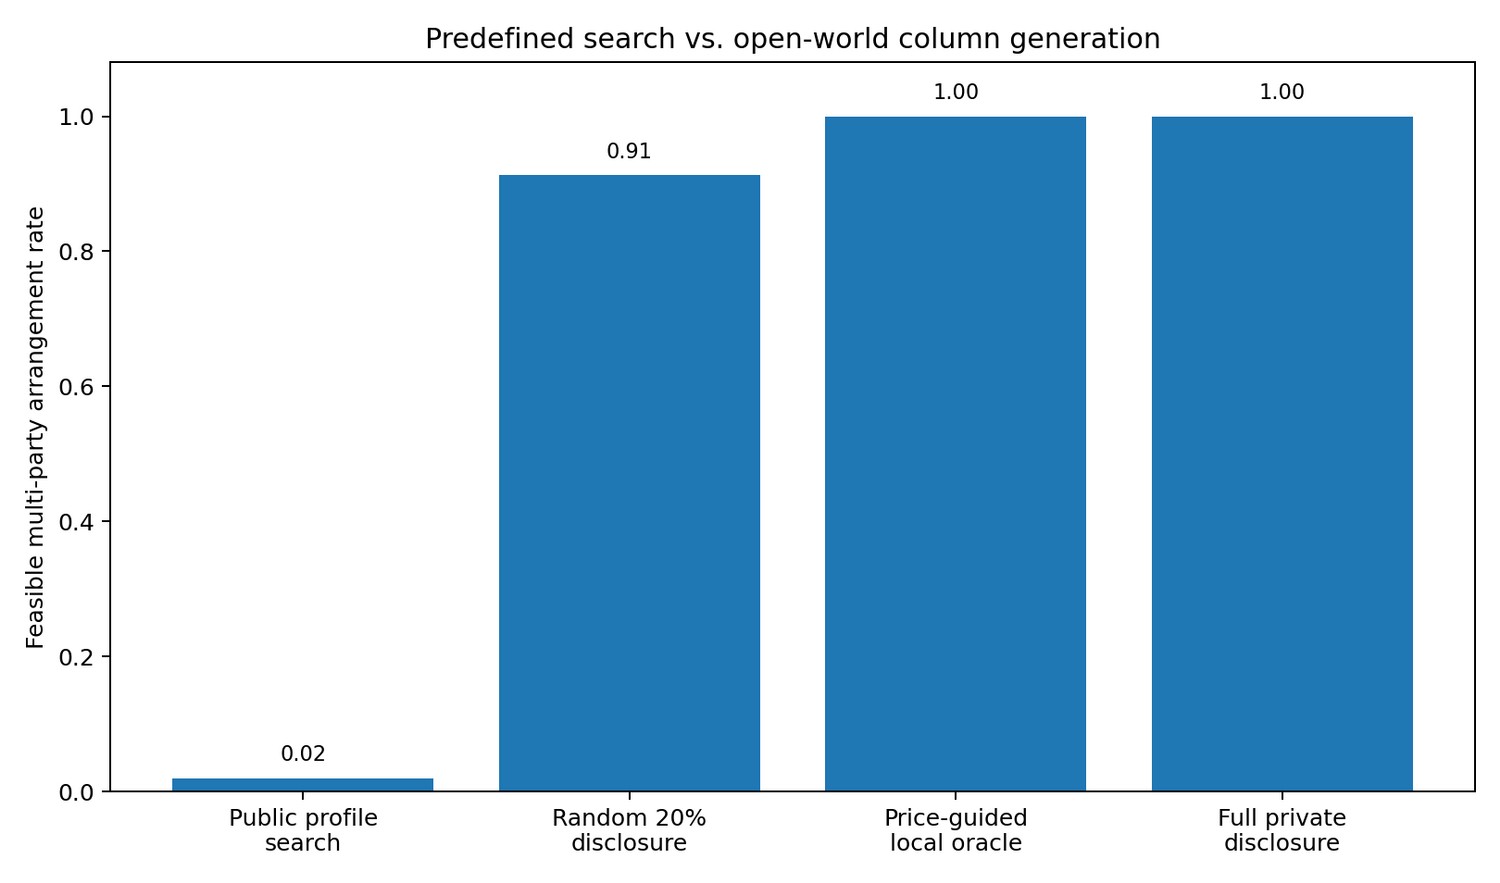 {width=78%}
该结果说明“主体能够公开独立完成什么”与“在当前组合和价格条件下愿意贡献什么”不同。随机探索可以找到部分组合,却以更高成本和披露为代价;本地价格引导列能逼近完整信息基线。
Design Delta:
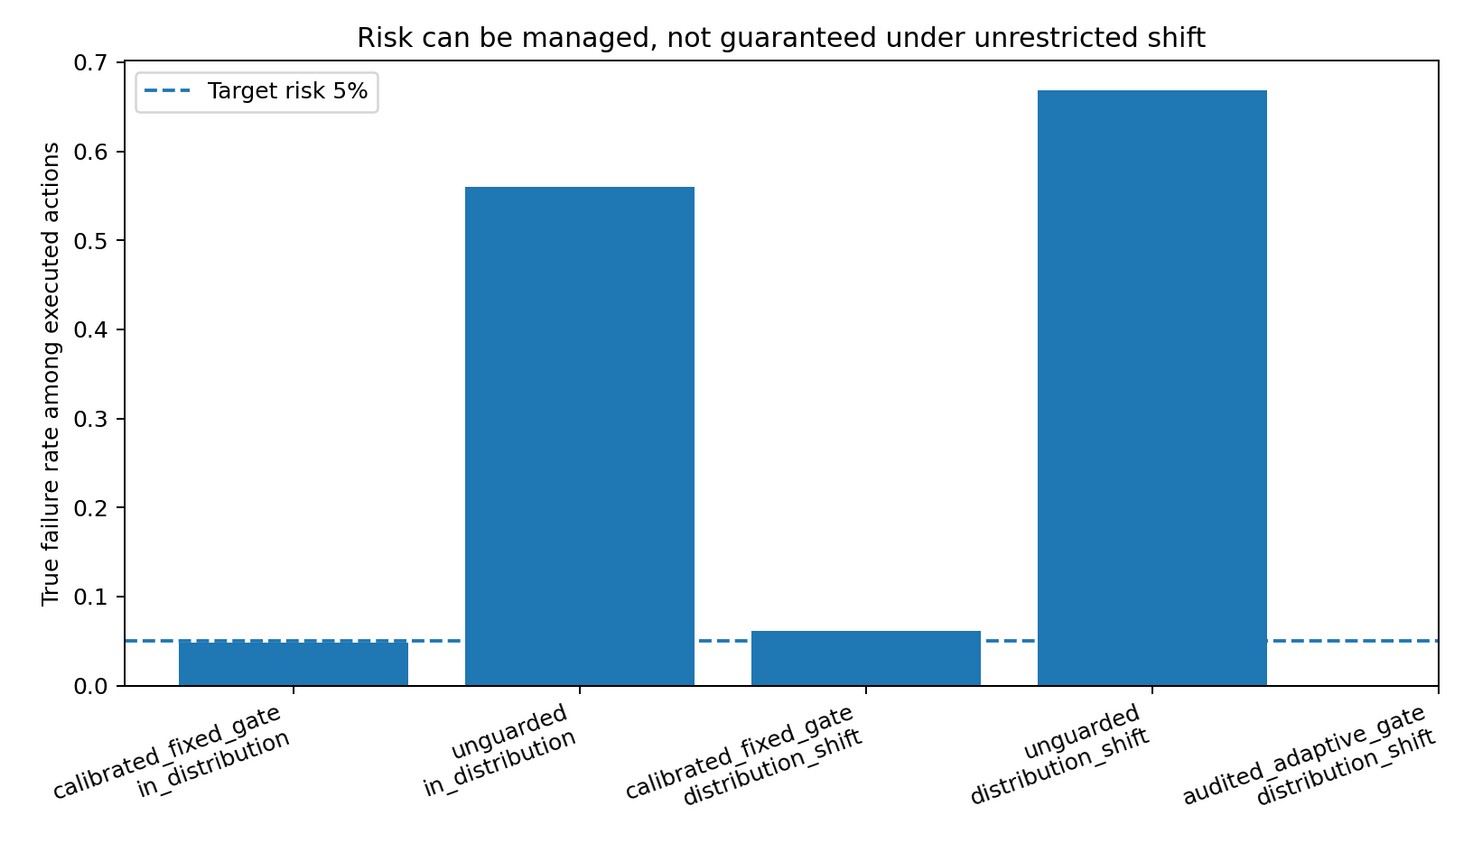
COLUMN,允许主体暴露条件性贡献;在分布漂移设置中,unguarded 策略的错误率为 0.5603 和 0.6683。校准风险门将错误率降低到 0.0479 和 0.0612,但覆盖率仅为 0.0300 和 0.0235;审计自适应策略在严重漂移下选择零覆盖。
该结果有两个相反含义。第一,概率门能够显著减少被建模错误;第二,代价可能是系统几乎不自动执行。只报告低错误率而不报告覆盖率会误导。零覆盖也不等于系统失败:在高风险漂移下,正确行为可能是返回 Unknown 或请求现实证据。
Design Delta:
共享预算实验中,eventual check-then-write 的 overspend 率为 0.60461,而 serializable reservation 为 0。结果不是一般分布式性能结论,而是直接验证命题 7 在生成器内的必要性。
Design Delta:
R5 在真实 macOS、Git、Docker、sandbox 和文件系统中得到四类结果。
第一,基线列出 18 条证据,但只有 2 条可由当前执行环境访问。证据“存在于某处”不等于当前 RelationVersion 可以合法、稳定地使用。
第二,在 9 个动作中,stdout 和外层退出码各只能正确指示 4/9 的现实状态;使用最小 Effect contract 和目标 readback 后达到 9/9。该结果直接促成 Effect Gateway 和 claim-specific witness。
第三,静态工具 profile 对 3 个 holdout 动作的可达性预测为 0/3;在 owner approval 和环境/权限索引加入后,3/3 变为可达。能力不是“安装了工具”,而是工具、环境、路径、权限和授权的组合。
第四,部分主权运行的时间开销约为中心路径的 4.54 倍。该负成本证据促使系统把普通本地审计默认路由到中心/确定性机制,而不是把主权隔离作为所有任务的默认。
Design Delta:
R5.2 对 17 个真实 Harness 场景进行重建。naive terminal baseline 将 carrier、sentinel、index 或最终日志直接解释为完成,在 17 个场景中错 10 次。显式四阶段重建——Attempt、Effect、Adoption、Acceptance——在 17/17 场景中与现有权威源一致。
该结果不支持维护四套完全独立的平行数据库。相反,它支持在同一事件系统中保存四种不可混淆的语义,并复用现有 readback。实验还暴露了事件措辞问题:“parked for redispatch” 与 “consumed” 若使用相同终态标签,会导致恢复逻辑错误。
Design Delta:
六轴能力合同在 6 个真实可执行案例上预测正确 4/6,低于预注册的 80% 门槛;静态 installed 基线为 3/6。主要遗漏是具体文件系统形成条件和恢复环境。
这是一项重要负结果。若只与弱基线比较,可以写成“比静态 profile 好”;但相对预先门槛,它没有通过。该失败促使能力合同加入:
当前仍无证据证明 CRA 能在广泛任务上优于优秀人类判断。
R5.4 的两个模型 Agent 形成了安全权利、披露、severability、争议、reopen 等更丰富条件。该结果说明模型能在给定角色上下文中进行规范语言构造。但实验没有产生:
所有 AcceptedOriginalValue 为 0;在验证前,A2A 成本约为静态 builder 的 2.49 倍。中心综合路径还因 transport failure 未形成公平强基线,故不能得出 A2A 优于或劣于中心 Agent 的一般结论。
R5.4 的科学价值在于否定了“更多协商文本 = PFE = 新能力”的错误链条。规范条件增加可能只是更完整地表达已存在冲突。只有当交互改变合格行动空间或必要运行条件,才构成形成证据。
Design Delta:
COUNTER/UNKNOWN/REFUSE,但要求 probe 或 Effect 证明;R5C 形成了 adopted → revoked → offline/unknown → adopted 的完整技术路径。关键结构包括:
producer-only 与 wrong-authority 条件不能产生目标投影,说明目标域 Authority 和 readback 是必要条件。该实验比 R5.4 更强,因为交互确实改变了可达运行路径,而不只是文本。
但 R5C 仍是两个技术权威域,不是两个真实社会 Principal。它没有证明:人理解并认领了版本;系统优于同权限中心;商业净值为正。
Design Delta:
R2–R5C 的联合结论不是“A2A 有效”,而是以下结构:
这些结果共同支持一套形成—资格化—认领—效力—编译结构,而不是支持“所有 Agent 应持续自由协商”。
在 50,000 个生成场景、250,000 次查询中,使用 Mandate + typed Event + provenance edge + conditional Commitment 的收敛表示在生成器查询集上错误为 0;naive flatten 产生 48,926 次错误,错误率 19.5704%。24.624% 的场景中,联合制品权利因为需要独立认领、修改或执行,必须提升为独立 Commitment。
该实验区分三种常见误区:
实验没有证明六 root 是唯一最优本体,也没有证明现实法律制度一定接受这种映射。
Design Delta:
| 历史概念 | 默认表示 | 升级条件 | |---|---|---| | UsageGrant | Mandate 的用途/数据 scope | 独立签发、跨关系引用、撤销 | | DataUseEvent | typed Event | 通常不升级 | | DerivationRecord | provenance edge | 谱系本身需独立治理/争议 | | JointArtifactRights | policy/conditional Commitment | 多方独立认领、修改、执行、救济 | | LearningUpdate | Effect event | 跨任务持久状态、监管、撤销义务 |
30,000 个有界变化的结果:
该结果支持用可达轨迹、角色、Authority、Effect、Data 和 Outcome 语义判断 materiality,而不是根据“文档是否改变”。但零错误只是因为 ground truth 与 checker 共享形式定义,不证明现实规范争议可以被算法自动解决。
Design Delta:
MATERIAL / NON_MATERIAL / AMBIGUOUS;AMBIGUOUS 升级到相称 Authority,而非模型自决;v0.4 Fieldkit 通过 11 项测试,虚构样例产生 21 个哈希链事件和 2 个 RelationVersion;v0.5 加入 Standing、jurisdiction、challenge 和 scoped Settlement 后通过 15 项测试;v0.7 扩展至 31 项测试,增加 OPC Operating Envelope、Coordination Context、八机制 Router、五维 Stability、Mandate 撤销、精确 Stance、附件证据和依赖闭包 reopen。
Fieldkit 的证据含义是:真实实验所需的前态、Mandate、RelationVersion、Effect、Acceptance 和 follow-up 可以被结构化记录和独立重算。它不证明用户愿意使用,也不具备生产加密、身份、密钥托管、支付或法律签署。
Design Delta:
private/ 与可共享导出;PEA-10 选择 10 个公开正式过程案例。主要编码为:1 个 Expansion、3 个 Transformation、5 个 Protective Contraction、1 个 Clarification。外部 Authority 改变路径 7/10,challenge/reopen 出现 6/10。
这说明“形成”不等于扩大交易。真实制度过程常通过附加限制、终止、分拆、监督和救济使关系变得更真实。一个系统若只把新机会和成交视为价值,会错过保护性收缩和快速不成交。
但这些是有意选择的理论样本,不能报告为总体频率;它们也没有 Agent treatment,不能证明通爻造成了任何结果。
Microsoft–LinkedIn、Amazon–iRobot 与 NASA HLS 三案共编码 33 个事件,其中 28/33 达到操作完整。只使用压缩公告时:
最终公告能够说明交易完成、终止或项目继续,却大量丢失候选、拒绝、外部权威、证据纳入、版本变化和 contingency。NASA HLS 提供了重要负控制:重大事件发生并不必然要求重构 Schema,若 contingency 已被制度框架预留,变化可以在原机制内吸收。
Design Delta:
frame_scope / inherits_from / overrides;扩展数据集包括 Microsoft–LinkedIn、Amazon–iRobot、NASA HLS、Sidewalk Toronto、UK Open Banking、Crossrail 和 California SGMA,共 58 个事件:
“58/58 可映射”不证明七维完备,只说明在当前编码分辨率下没有结构残差;单编码者也可能把无法表达的内容强行解释进既有类别。
公开咨询中的公众没有最终合同签字权,但其关于公共控制、数据治理、范围和退出的挑战改变了合法 RelationVersion。系统因此必须允许 affected-party standing,而不能把所有参与者伪装成共同决策人,也不能只记录最后签字者。
正式命令、技术标准和实施实体已经存在,技术交付与采用可以推进;但后续复盘指出决策、资金与治理权限并未由技术实施组充分承载,缺少阶段性治理复核。由此导出:
[ RuleDeclared \neq RuleEnacted. ]
一条规则的存在还需要观察、信息到达、干预权、资源和制裁/升级路径,才能成为运行中的制度。
大量合同和局部工程结果并不自动构成可运营铁路。接口、依赖和整体时序未被统一观察时,局部 Effect 无法推出端到端 Effect。这一案例强化了目标世界 witness 与跨组件依赖图。
州级法律要求地方机构协调,但允许多种组织形式。不同流域采用 MOU、联合机构、共享数据、中心协调和本地自治的不同组合。不可折叠权威不推出统一去中心化结构。
Design Delta:
QDR 数据处理结果:
18 个流域出现 15 种协调配置。按最相近协调顾虑寻找 nearest neighbor,仅 1/18 复现相同配置。该结果反驳简单规则:“面对相似问题,应选择同一种协调机制”。机制选择依赖权威拓扑、自治、资源、制度历史、目标结果与可执行结构的组合。
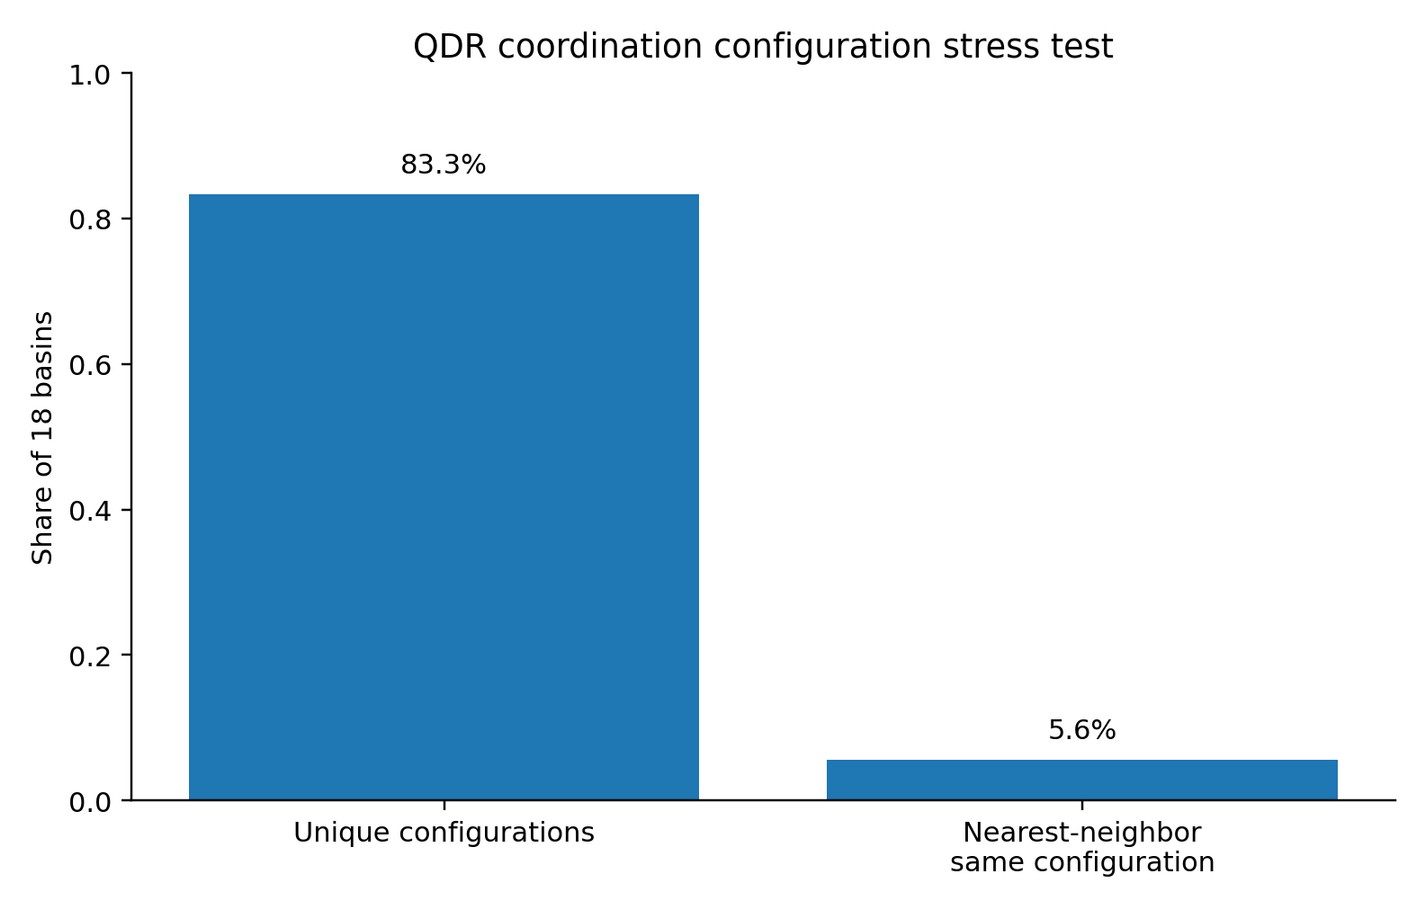 {width=74%}
自动检索的 54 项单分析者审计中:
这说明自动检索适合作为候选生成器,不适合直接报告主题 prevalence。QDR 不是 OPC 数据,其正确用途是机制与本体校准:真实访谈中确实能观察到自治、权威、代表、资源和机制选择,但不能用其频率预测超级个体。
11 个时间截点的平均 F1:
| 方法 | F1 | |---|---:| | No change | 0.000 | | Prior mode | 0.516 | | Last event | 0.677 | | Authority-aware | 0.756 |
Authority-aware 召回达到 0.891,但完整维度集合 exact match 为 0/11。
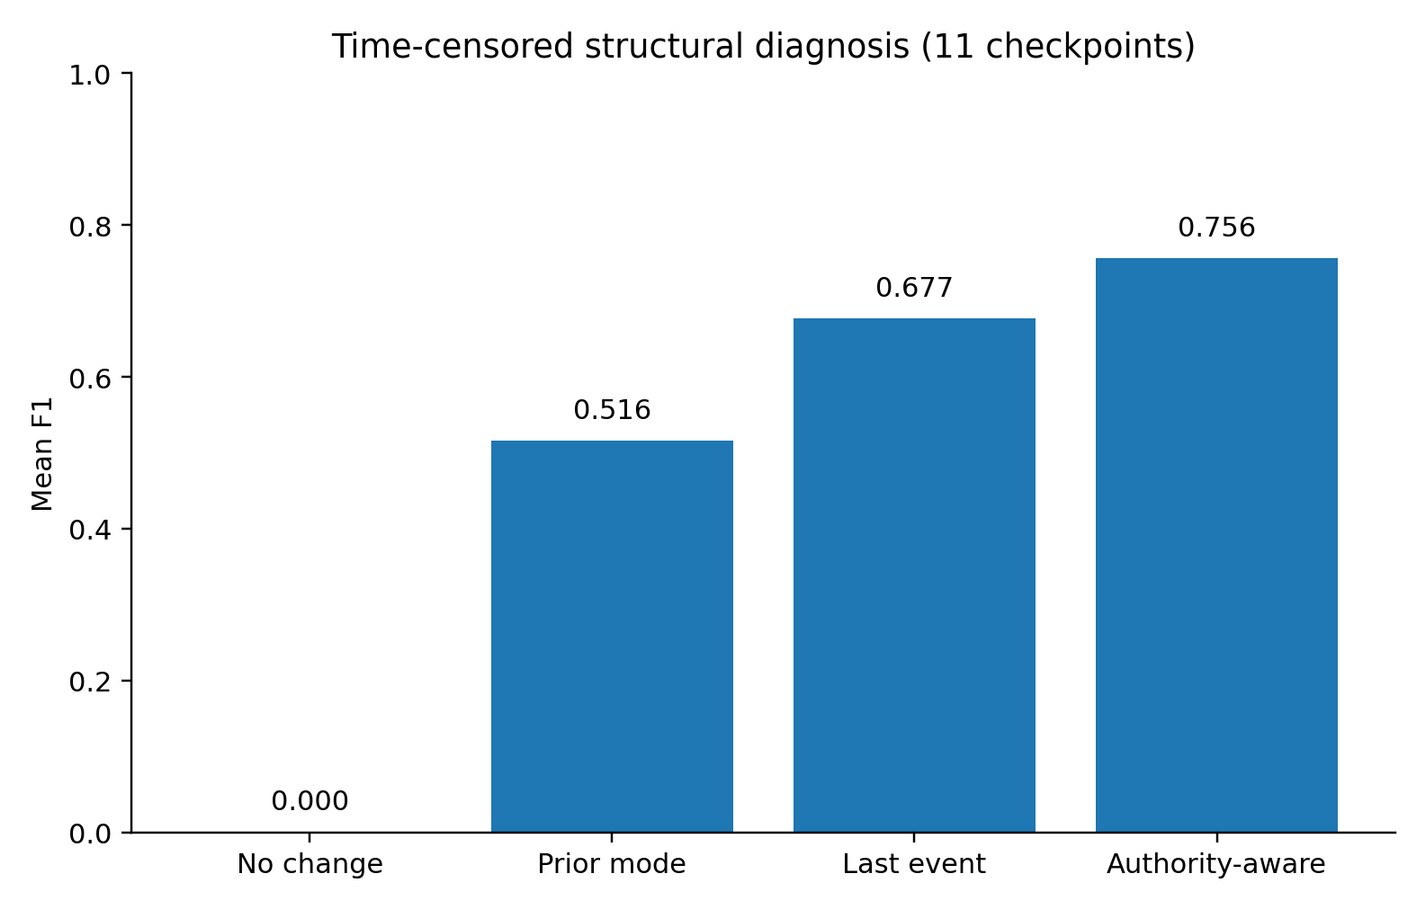 {width=74%}
结果支持把结构诊断器用于高召回风险扫描和 probe 排序,不支持让它自动预测、拒绝或重开。零 exact match 表明真实变化通常同时包含未被当前摘要充分捕捉的维度。
Design Delta:
结构诊断
→ 候选缺口排序
→ probe 成本与风险估计
→ 选择最小可判别问题
→ 返回相称 Authority Locus
而不是“模型预测将变化,所以自动修改关系”。
对 58 事件的结构查询召回:
版本图使用与人工事件相同的 Authority、版本和依赖 Schema,因此 100% 证明已编码信息能够被无损保存。它不证明自然语言自动抽取准确,也不证明用户体验、商业结果或决策质量。
该实验仍有建设性价值:它确认压缩公告和覆盖式单状态不适合作为审计事实内核。若单状态加入全部历史、来源和依赖,它实际上会演化为等价版本图。
构造场景结果:
| 机制 | 结构有效案例 | |---|---:| | 固定平台 | 6/24 | | 单一全局 Agent | 0/24 | | 修复后组合 Router | 24/24 |
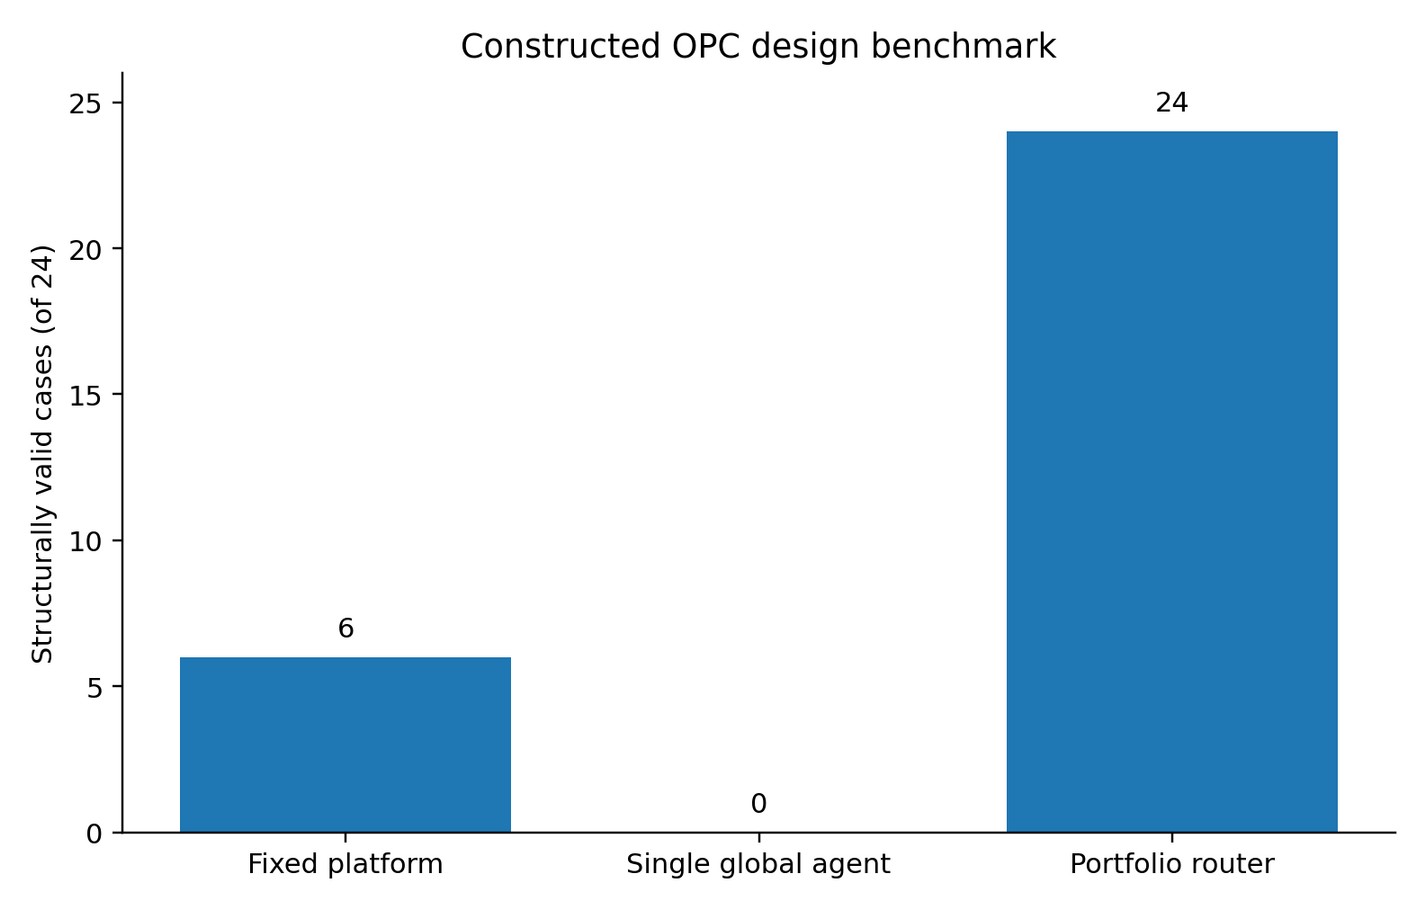 {width=74%}
24/24 不能写成“通爻完胜”,因为场景和 Router 来自同一理论。真正信息增量来自初始 Router 的五类失败:
修复这些失败后,Router 才在构造定义下通过。
Design Delta:
v0.4–v0.7 的证据使理论更可操作,也暴露了其容易自证的风险。生成器、Schema 和 Router 均由研究者构造;公开过程由既有理论编码;QDR 不是 OPC;版本图使用同构查询。因此,这些结果最适合支持:
它们不能替代:真实委托、解释理解、相对强基线、长期使用和净价值。
OPC 研究容易落入两个相反的简化。一种把 solo founder 理解为“一个人完成所有工作”,由此低估平台、受众、开源社区、工具、承包商和产品化服务构成的执行身体;另一种只统计“公司有几个创始人”,却不区分谁最终决定目标、承担风险、授权行动和接受结果。公开创业数据表明,单独创立的美国新公司比例近年上升,但获得定价股权融资的比例仍显著较低;这说明 solo 形态正在增加,却不能据此推断其普遍优势或资源充分性 [63]。关于 solo 与 cofounding 的组织研究也表明,solo founder 并非没有共同创造者,而可能通过员工、联盟、资助者和其他关系取得资源 [64]。
本文因此不以“solo 是否成功”为分析单位,而以责任根—能力图—事项过程为单位。语料的任务是回答:一个紧凑责任根如何选择任务、形成能力、组合机制、把协调编译成可复用资产,以及在什么条件下因支持负担、平台依赖、模糊承诺或角色冲突而重开。Effectuation 与 bricolage 已经为“从现有手段出发、通过承诺和重组创造可行动路径”提供了成熟解释 [86–87];本语料进一步编码这些动作何时获得可追溯的权威、资源、Effect 和 Acceptance。它不用于估计 OPC 总体频率,也不把公开收入当作当前财务事实。
当前语料包含 20 个案例和 59 个按时间排序的过程事件。其中 18 个来自公开的一手访谈转录,2 个 2026 年 AI-native 第一人称自报被单独标记为 frontier_low_assurance,不进入核心归纳 [66–83]。核心材料覆盖自助 SaaS、开源、教育内容、开发工具、个人金融、产品化服务、人类经纪、临时联盟、生态系统与组织收缩。
纳入标准为:来源中能够识别责任根;至少包含两个过程事件;能够观察形成动作、机制选择、编译资产或失败/重开;来源为直接访谈、第一人称复盘或相称过程材料;研究者能够明确限制。榜单、二手成功故事、当前估值和只有结果数字的材料不进入核心过程语料。
每个案例编码:
[ O_i = \langle R_i, G_i^C, M_i, F_i, K_i, B_i, D_i, E_i \rangle, ]
其中 (R_i) 是责任根,(G_i^C) 是能力图,(M_i) 是机制组合,(F_i) 是形成动作,(K_i) 是编译资产,(B_i) 是 Principal 边界,(D_i) 是 Defeater/风险,(E_i) 是时序事件。全部案例通过 JSON Schema 校验;当前仍为单编码者理论构造,尚未完成互编码一致性。
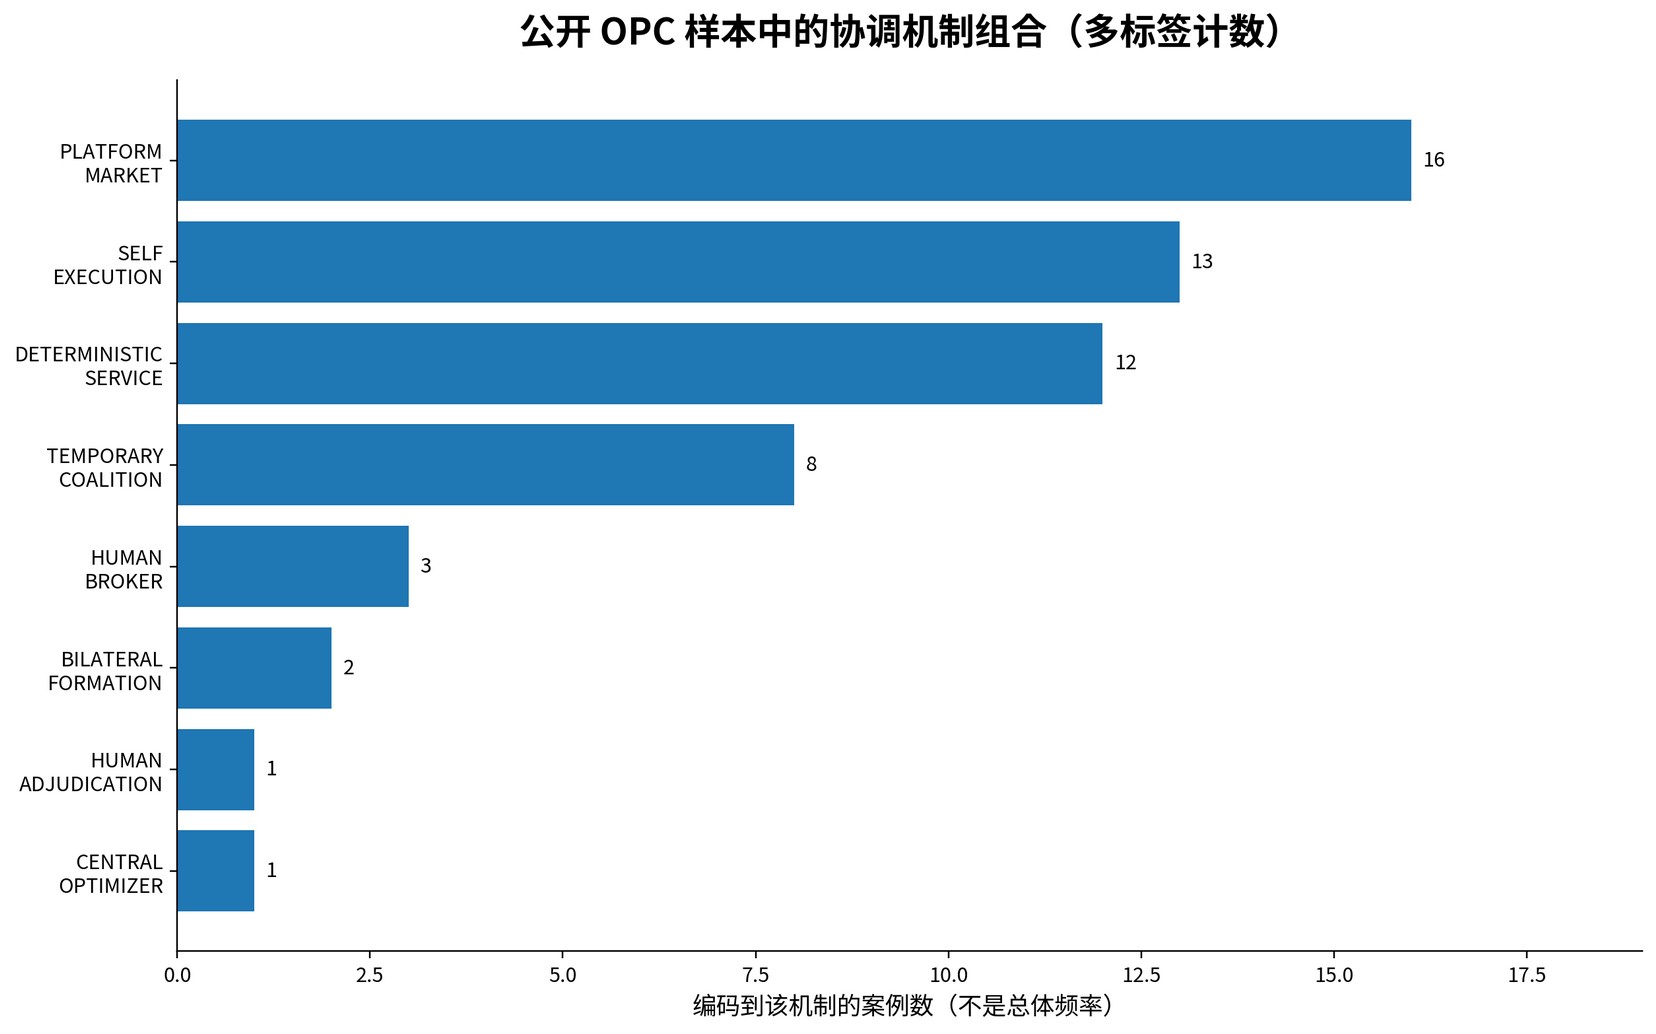 {width=86%}
语料中严格 solo 或 solo-origin 的责任根共有 14 个,但几乎所有案例都依赖外部能力节点。Nomad List 的数据与注意力来自在线社区;Sidekiq 将开源用户与企业客户作为反馈和商业边界;Makerpad 把 no-code 平台当作模块化能力;Refactoring UI 由互补创作者组成临时联盟;WP Buffs 把产品化服务作为小型主体可复用的外部身体;Credo 把人类声誉与经纪判断转化为发现和保证机制。
因此,本文将 OPC 的运行视图写成:
[ \mathrm{OPCView}_t = \langle R^*, A_t, G_t^C, \Gamma_t, L_t \rangle, ]
其中 (R^*) 是紧凑外部责任根,(A_t) 是内部 Authority Loci,(G_t^C) 是可替换能力图,(\Gamma_t) 是当前关系版本集合,(L_t) 是对外义务。ResponsibilityRootView 与 CapabilityGraph 都是派生视图,不升级为新的 canonical root。
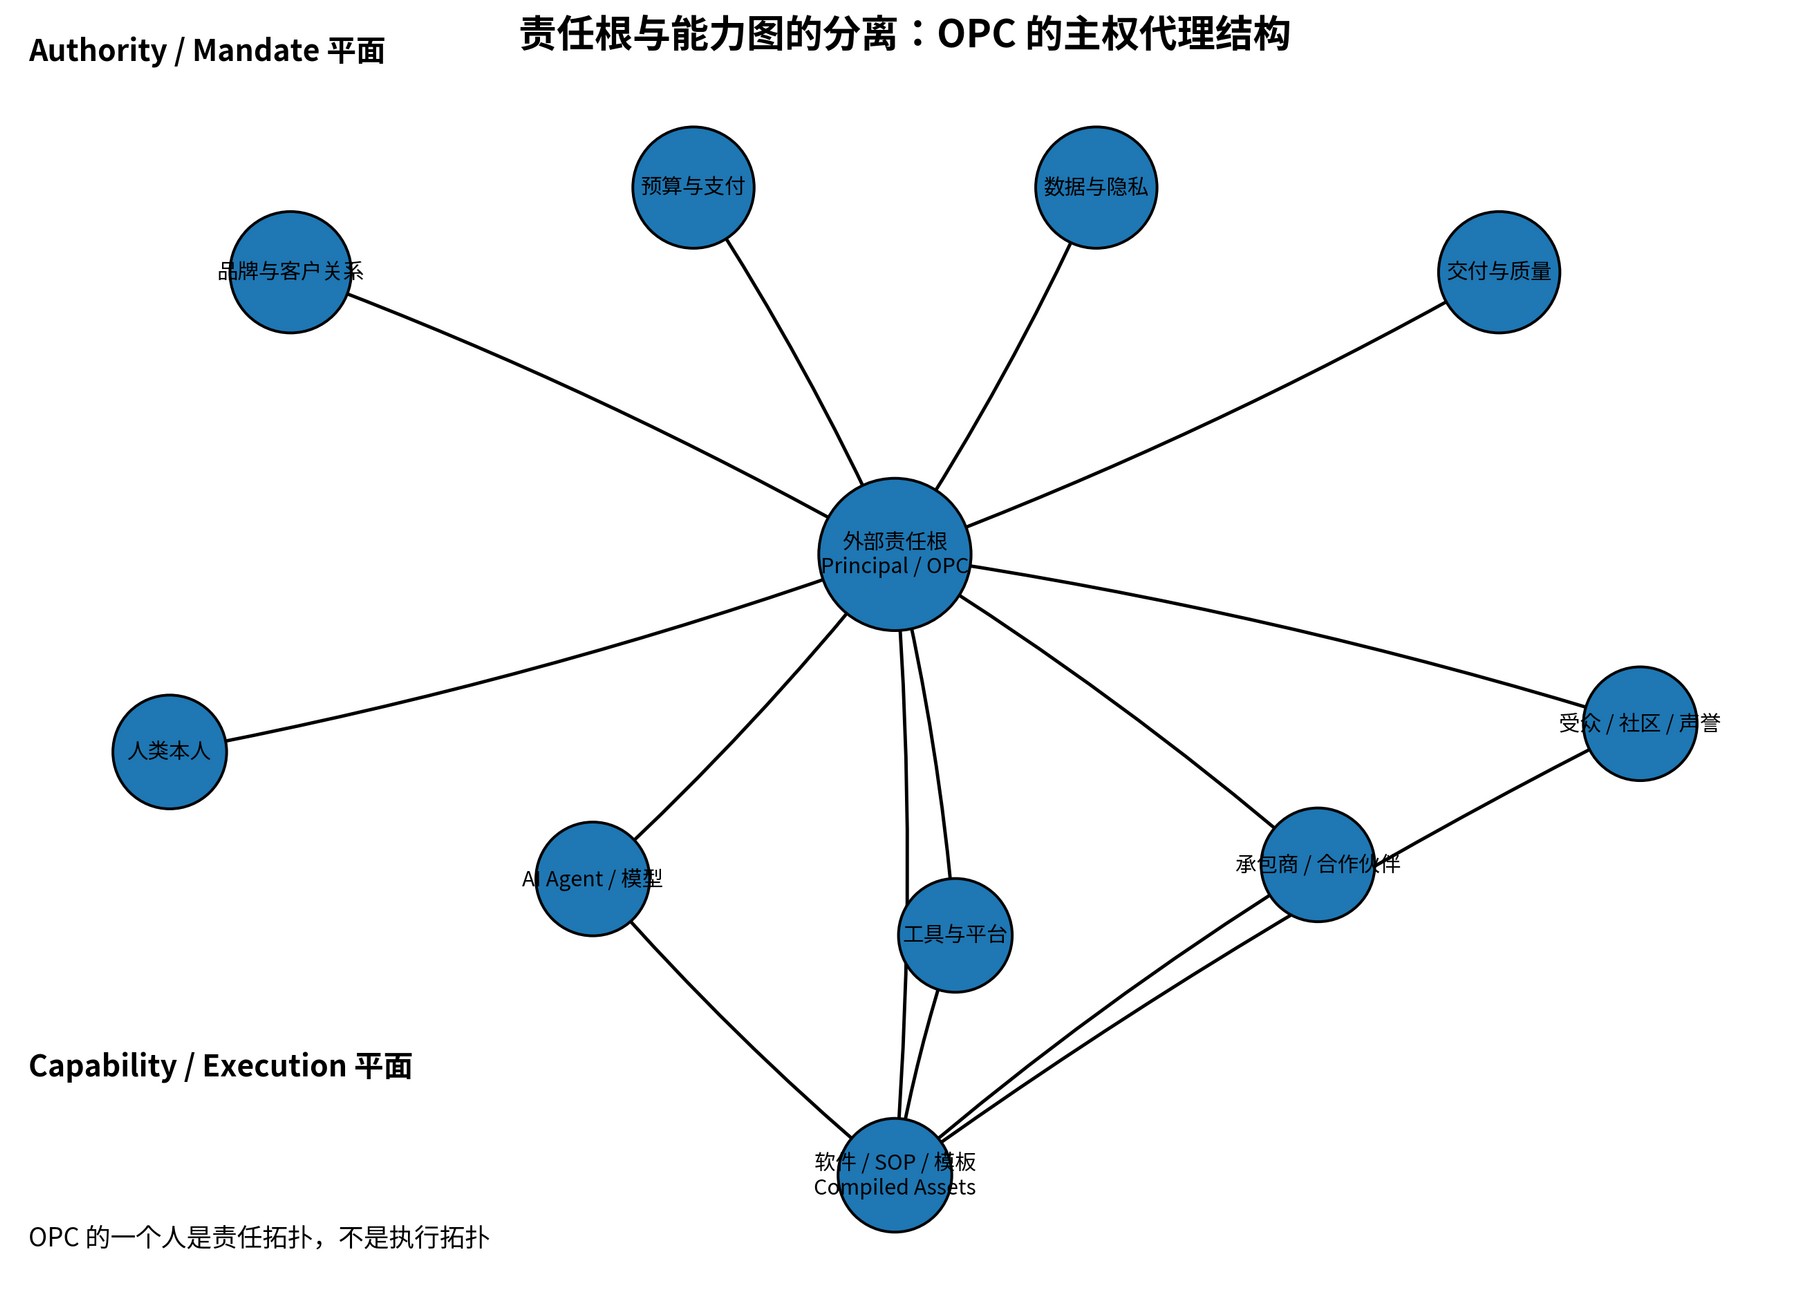 {width=94%}
这个区分直接修正了“一个人 = 一个 Principal = 一个 Agent = 一套权限”的假设。执行图可以扩张、替换或外包,责任根不应因此静默转移;反过来,一个外部供应商被接入能力图,也不等于它获得品牌、数据或最终接受权。
语料中的编译资产不限于代码。它们包括软件、模板、教程、SOP、定价、标准服务边界、市场规则、文档、白标服务、受众和声誉路由。Carrd 通过低摩擦产品与免费层减少重复获客协调;Closet Tools 在创始人暂停开发期间仍由软件和短时支持维持运行;GoRails 把重复开发决策压成模板与服务;Park.io 把时间敏感的市场动作编码为脚本与拍卖;WP Buffs 把 24/7 支持编译为可由其他小主体调用的白标能力。
由此,Compiled World 的候选定义扩展为:
任何把高频、已稳定的判断、权利、动作、质量门和效力读回压成可重复运行机制的制品。
它可以是代码,也可以是合同、定价、SOP、内容、声誉路径或产品化服务。关键不在载体,而在是否减少后续开放判断,同时保留版本、退出、Effect 与 reopen。
OPC 不只是通过学习和工具扩大能力,也通过选择适合自身责任根的事项保护主权。Nomad List 的多项目实验和放弃、SavvyCal 对任务关键性与购买权的重新筛选、Lunch Money 的健康与节奏边界、WP Buffs 通过价格和客户筛选降低支持负担,都说明“拒绝”“延后”“小规模 probe 后放弃”可能是正价值。
本文因此增加 Task Sovereignty Check,但不增加顶层对象。对候选事项 (q),检查:
[ TSC(q)=\langle TSC_{decision}, TSC_{burden}, TSC_{reuse}\rangle, ]
[ TSC_{decision}=\langle criticality, loci, irreversibility\rangle, ]
[ TSC_{burden}=\langle support, dependency\rangle, \qquad TSC_{reuse}=\langle compilability\rangle. ]
若任务关键性、决策人数量、不可逆性、长期支持负担或平台依赖超出责任根,而又缺乏可编译结构,Router 应优先建议任务重构、伙伴引入、范围收缩或拒绝,而不是假设“更强 Agent”能够无代价吸收一切复杂性。
Plann 是语料中的关键负案例:非技术创始人通过交换营销劳动获得开发能力,路径在资源层面被创造,但贡献范围、时间、质量 witness 和补救权不足,导致长期漂移和重建。(注:该定性为本文基于公开访谈的研究性解读,非当事人自述;其作用是形成可检验的协调解释,不构成对当事人动机或责任的事实裁定。) 与 Refactoring UI、FeedbackPanda 和 WP Buffs 的对照表明,临时联盟不是天然危险,也不是天然成功;它需要把互补能力转化为版本化的贡献、资源、权利、质量与退出结构。
一个联盟从 Candidate 进入 Commitment 至少需要:
[ CoalitionReady = Scope \land Reservation \land Rights \land Witness \land Exit. ]
这五项不是新的 roots,而分别落在 RelationVersion、Mandate、Commitment、Operation/Effect 和 reopen 语义中。
Credo、Carrd、Refactoring UI 和 Nomad List 显示,受众和声誉可以同时承担 discovery、assurance、distribution 与 local feedback。它们不是一个通用信誉分,也不应被 Agent 自动据为权威。声誉信号必须带有来源、任务相关性、时间与反例;人类经纪作为 Router 的正式机制,仍然适合高语境、身份判断、注意力压缩和难以形式化的关系。
因此,系统不把“引入 Agent”理解为消灭经纪,而是把经纪判断放入可追溯的机制组合:何时由人提出候选,何时由本地 Oracle验证边界,何时由确定性组件执行,何时由 Principal 最终接受。
本轮公开 OPC 语料产生七项直接变化:
CapabilityGraph 纳入 Agent、工具、平台、社区、承包商、内容和产品化服务;Task Sovereignty Check;PROTECTIVE_CONTRACTION 与 PORTFOLIO_PROBE;公开访谈存在成功者、存活者、回忆和品牌叙事偏差;失败过程常被压缩,财务数字未独立审计,历史 solo 状态不代表当前组织形态。案例集中于数字产品、开源、内容和服务,不能外推至实体制造和高监管行业。当前编码尚无第二编码者。因此,本节提供 H 级历史过程校准和情景生成,不提供人群频率、因果效应或 Agent 产品价值结论。
在前几轮研究中,Principal、Mandate、RelationVersion、Commitment、Operation、Effect 和 Acceptance 已经被区分,但如果论文、Schema、Fieldkit 和实验各自实现不同语义,系统仍会在边界处重新折叠。v1.1 因此将六个 canonical roots 与必要派生对象压进一个无依赖参考内核,并要求所有关键状态迁移由同一 gate 执行。
参考内核不是生产身份、支付、法律签署、密码学或隔离边界。它的研究任务是:让理论中的“不应当发生”变成可以被程序拒绝、可以被 mutation suite 反驳的状态转换条件。
抽象模型把主体与权威、委托、关系版本、主张与立场、资源与预留、承诺、动作、现实效力、接受以及事件历史放在同一生命周期中。它覆盖注册、委托、认领、预留、承诺、执行、目标域见证、接受、物质变化、范围化重开与局部编译。
〔公开版删改 · R-14〕 本处原文给出参考内核的精确状态元组。公开版将其压缩为概念性状态摘要,避免公开可直接映射实现的结构,同时保留研究问题与形式结果的可理解性。
参考内核以可执行拒绝条件保护五类边界:动作必须位于当前有效授权内;认领、预留、承诺与执行必须绑定精确版本;承诺不能超卖资源;现实效力与接受不能由上游日志替代;撤销、物质变化与证据反例必须使受影响的派生状态失效并只重开必要依赖范围。
〔公开版删改 · R-15〕 本处原文逐项列出 12 条精确安全不变量。公开版保留不变量覆盖的风险类别和实验结论,移除可直接复刻参考内核拒绝逻辑的逐条措辞。
v1.1 内核实现 Entity continuity、Authority Locus powers、Mandate、RelationVersion、ResourceCapacity、Reservation、Commitment、Operation、FileSandbox Effect adapter、Acceptance、material change、reopen、compile、event chain 与派生 snapshot。17 项单元测试覆盖:完整闭环、撤销、数据权、Acceptance 权威、material invalidation、编译阻断、依赖闭包、idempotency、资源超卖、释放预留、actor mismatch、累计限额、陈旧 hash、事件篡改、路径逃逸和派生视图。
全部测试通过只表明实现满足当前测试,不等于不变量已经在所有并发、分区和攻击下成立。为避免“测试写成什么,系统就证明什么”的自洽,本文增加独立抽象状态探索与 mutation suite。
TowowCore.tla 给出 Mandate、Recognition、Reservation、Commitment、Operation、Attempt、Effect、Acceptance、Compile 和 MaterialChange 的有限状态规格 [65]。当前运行时无法取得官方 TLC JAR,因此本文不声称已执行 TLC;TLA+ 文件作为独立复核制品发布。
同一生命周期被另行编码为无依赖 Python 有界探索器。正确模型在深度 12 内探索 374 个唯一状态和 1,084 个转移,在所列不变量中未发现反例。九类注入错误均被同一探索器区分并产生反例;聚合结果公开,逐项 mutation 的状态、转移和反例明细不在公开版披露。
〔公开版删改 · R-16〕 本处原文列出九类 mutation 的逐项状态空间与反例明细。公开版保留 374 个状态、1,084 个转移、17 项单元测试和九类错误均可检出的聚合结论,移除明细表。
结果的价值不在“零违规”本身,而在于 mutation 能被同一探索器稳定区分,说明不变量具有非平凡的错误检测能力。
第一,Authority 与数据权必须在 Operation 准备和执行时再次验证,而不能只在 Agent 获得凭证时检查。第二,资源容量属于承诺语义;若只在业务层事后统计,系统仍可产生多个逐项合法、合计超限的承诺。第三,Acceptance 必须有独立 power 和目标 Effect 引用。第四,material change 必须使旧 Stance、Commitment 和 compiled version 显式失效。第五,事件链和派生 snapshot 使审计可行,但不能替代生产签名、可信时间和安全存储。
当前模型尚未覆盖拜占庭主体、密钥盗用、网络分区、乱序和重复消息、跨法域效力、复杂多资源死锁、战略性 Oracle、选择性披露攻击和长期学习状态。Progress properties 也只获得设计约束,尚未证明所有 Unknown 最终进入 probe/defer/reject。下一版形式研究应把多主体并发、两阶段/补偿式 Commitment、撤销传播和 scoped reopen 的最小性纳入 TLC 或同等级工具。
若完整通爻系统只与一个固定表单比较,任何优势都可能来自模型、工具、提问次数或更丰富的上下文,而非主权语义。OPCBench 因此把比较拆成四层:固定平台、扁平强中心 Agent、Authority-aware Hub 和联邦 Relation 系统;组合 Router 再根据制度充分性、可集中性和权威拓扑选择机制。这样可以分别识别语义价值、拓扑价值、形成价值和编译价值。
基准包含 24 个理论构造案例:8 个 CollapseSafe 标准事项、8 个非标准双边事项、4 个临时联盟、4 个争议/reopen 事项。每例显式声明 required conditions、公开/私有 material conditions、制度是否充分、是否可在授权内集中、是否需要本地 Oracle、exact version、probe、formation operator、Effect witness、Acceptance、漂移和 trusted hub。
所有机制使用同一输入和评分函数。该设计不比较语言模型推理质量,而比较当相同事实被放入不同状态结构时会产生的可执行后果。结果属于理论构造机制实验;任何 1.000 准确率都只表示与构造真值一致。
| 机制 | 处置准确率 | Material recall | 错误 Authority | 未授权 Effect | 平均协调成本 | 平均净值指标 | |---|---:|---:|---:|---:|---:|---:| | 固定平台 | 0.333 | 0.673 | 0.500 | 0.500 | 1.000 | -24.887 | | 扁平中心 Agent | 0.375 | 0.806 | 0.667 | 0.125 | 2.494 | -16.080 | | Authority-aware Hub | 0.625 | 1.000 | 0 | 0 | 3.954 | -2.816 | | 联邦 Relation | 1.000 | 1.000 | 0 | 0 | 5.440 | 10.318 | | 组合 Router | 1.000 | 1.000 | 0 | 0 | 4.150 | 11.896 |
Authority-aware Hub 已经消除了构造案例中的未授权 Effect,并找到 15 条形成路径,说明大量价值来自语义结构而不是分布式部署。联邦 Relation 在不可集中和无可信 Hub 的案例中恢复处置。组合 Router 略高于强制联邦,因为标准任务被路由至更便宜的固定机制。
每个基础案例加入 20 次共享扰动:额外隐藏条件、Effect witness 失败、Mandate 撤销和局部漂移,共产生 2,400 次机制评估。组合 Router 与联邦 Relation 的处置准确率均为 0.869,Authority-aware Hub 为 0.560,扁平中心 Agent 为 0.375,固定平台为 0.329;组合 Router 通过在 136 个扰动标准事项中选择固定平台、164 个事项中选择权威感知 Hub、180 个事项中选择联邦 Relation,把平均净值指标提高到 6.504,而强制联邦为 5.114。Router 与联邦机制仍会因撤销或漂移检测不完整产生错误;保留权威对象不等于能够无误观察现实权威。
完整 Router 被分别替换或移除关键能力:
| 条件 | 处置准确率 | Effect verification | Formation path | 平均净值指标 | |---|---:|---:|---:|---:| | 完整 Router | 1.000 | 0.750 | 15 | 11.896 | | 强制固定平台 | 0.333 | 0.250 | 0 | -24.887 | | 全部强制联邦 | 1.000 | 0.750 | 15 | 10.318 | | 移除 formation operator | 0.583 | 0.333 | 0 | -9.764 | | 移除 local Oracle | 0.708 | 0.458 | 15 | -1.985 | | Effect witness 不可用 | 1.000 | 0 | 15 | 10.599 |
Effect witness 消融最能说明文本处置与现实闭合的差异:系统仍可生成正确的理论处置,却无法证明现实 Effect 与 Acceptance。formation operator 消融使需要 probe、任务重构或伙伴引入的事项退化为 Unknown;local Oracle 消融主要伤害不可集中、无可信 Hub 的事项。
另一个机制实验生成 2,000 个十次重复运行序列,比较持续形成、冻结编译、漂移时全量重开和 scoped reopen。成本、漂移和损失函数均为理论设定。
在零漂移时,持续形成的平均总成本为 60.0,三种编译策略均为 16.8。漂移率 0.20 时,冻结编译产生平均 1.797 次陈旧错误;全量重开成本为 25.450;scoped reopen 成本为 19.296,二者均无被建模错误。漂移率 0.50 时,冻结编译价值指标转为负,scoped reopen 仍低于全量重开。
这不证明 scoped reopen 在现实中总是最优,只证明:编译价值依赖稳定范围;永不重开会把效率变成陈旧风险;任何变化全量重开又会损失复用价值。依赖图和 Defeater 不是附加治理,而是 Compiled World 能够长期运行的必要条件。
案例、真值与效用函数均由理论作者构造,且未使用真实模型、人类时间、平台或经纪成本,故不能代表产品成功率。它只用于隔离权威语义、本地拓扑、formation operator 与重复运行的结构作用。真人实验将沿同一强基线采集真实成本与 Effect。
公开材料已经说明真实 OPC 会组合平台、软件、社区、承包商、伙伴与人类经纪;形式模型已经说明某些错误可由 Mandate、版本、资源与 Effect Gate 阻断;OPCBench 已经把语义价值、拓扑价值、形成价值和编译价值拆开。然而,这些证据都不能回答四个只能由真实责任主体承担的问题:Principal 是否真正理解并愿意委托;某条新路径是否由形成动作因果地产生;Operation 是否改变了目标世界并被相称主体接受;系统相对平台、强中心 Agent 和优秀人类经纪是否有正净值。
因此,真人实验不重新证明静态画像不完备、Attempt 不等于 Effect 或版本图能保存历史。它只承担公开档案、代码和 sandbox 无法替代的主张。完整执行方案、表单和 Schema 随论文作为独立现场包发布;本节给出足以审查研究完整性的正式协议。
| 阶段 | 样本与事项 | 现实权限 | 主要问题 | 进入下一阶段的 Gate | |---|---|---|---|---| | H0 历史校准 | 12–20 个公开或授权 OPC 事项 | 无新增 Effect | 数据能否恢复 Authority、版本、关键转折与真实结果 | 核心事件可定位,编码缺失不系统偏向某一机制 | | H1 前瞻性 shadow | 6–8 个 OPC、每个 3–5 个真实事项 | 只观察和建议 | Mandate、角色冲突、Router 与注意力成本是否可测 | 事件链完整率、explain-back 与零外发 Gate | | H2 低风险可逆 Effect | 8–12 个事项 | 人工批准、金额/范围封顶 | Operation、目标域 Effect、Adoption 与 Acceptance 能否闭合 | 零未经授权 Effect;全部 Effect 可 readback 与撤销/补救 | | H3 跨责任根形成 | 4–8 个双边或临时联盟 | 各方独立 Mandate 与拒绝 | 本地权威、countercondition 和能力组装是否产生新路径 | 至少一条可消融形成路径;拒绝、权利、质量与退出可追溯 | | H4 重复、编译与漂移 | 至少 6 条完成关系 | 稳定局部可确定性运行 | 第二/三次运行是否降本;Defeater 是否只局部重开 | 复用价值为正且错误不增;under/over-reopen 可审计 |
H0 已由本轮 20 案例、59 过程事件的公开语料启动,但单编码者公开档案不能代替 H1–H4。各阶段均允许返回设计:失败必须转化为 Schema、Router、界面、安全机制或适用域的 Design Delta,而不是被归咎于“用户不会用”。
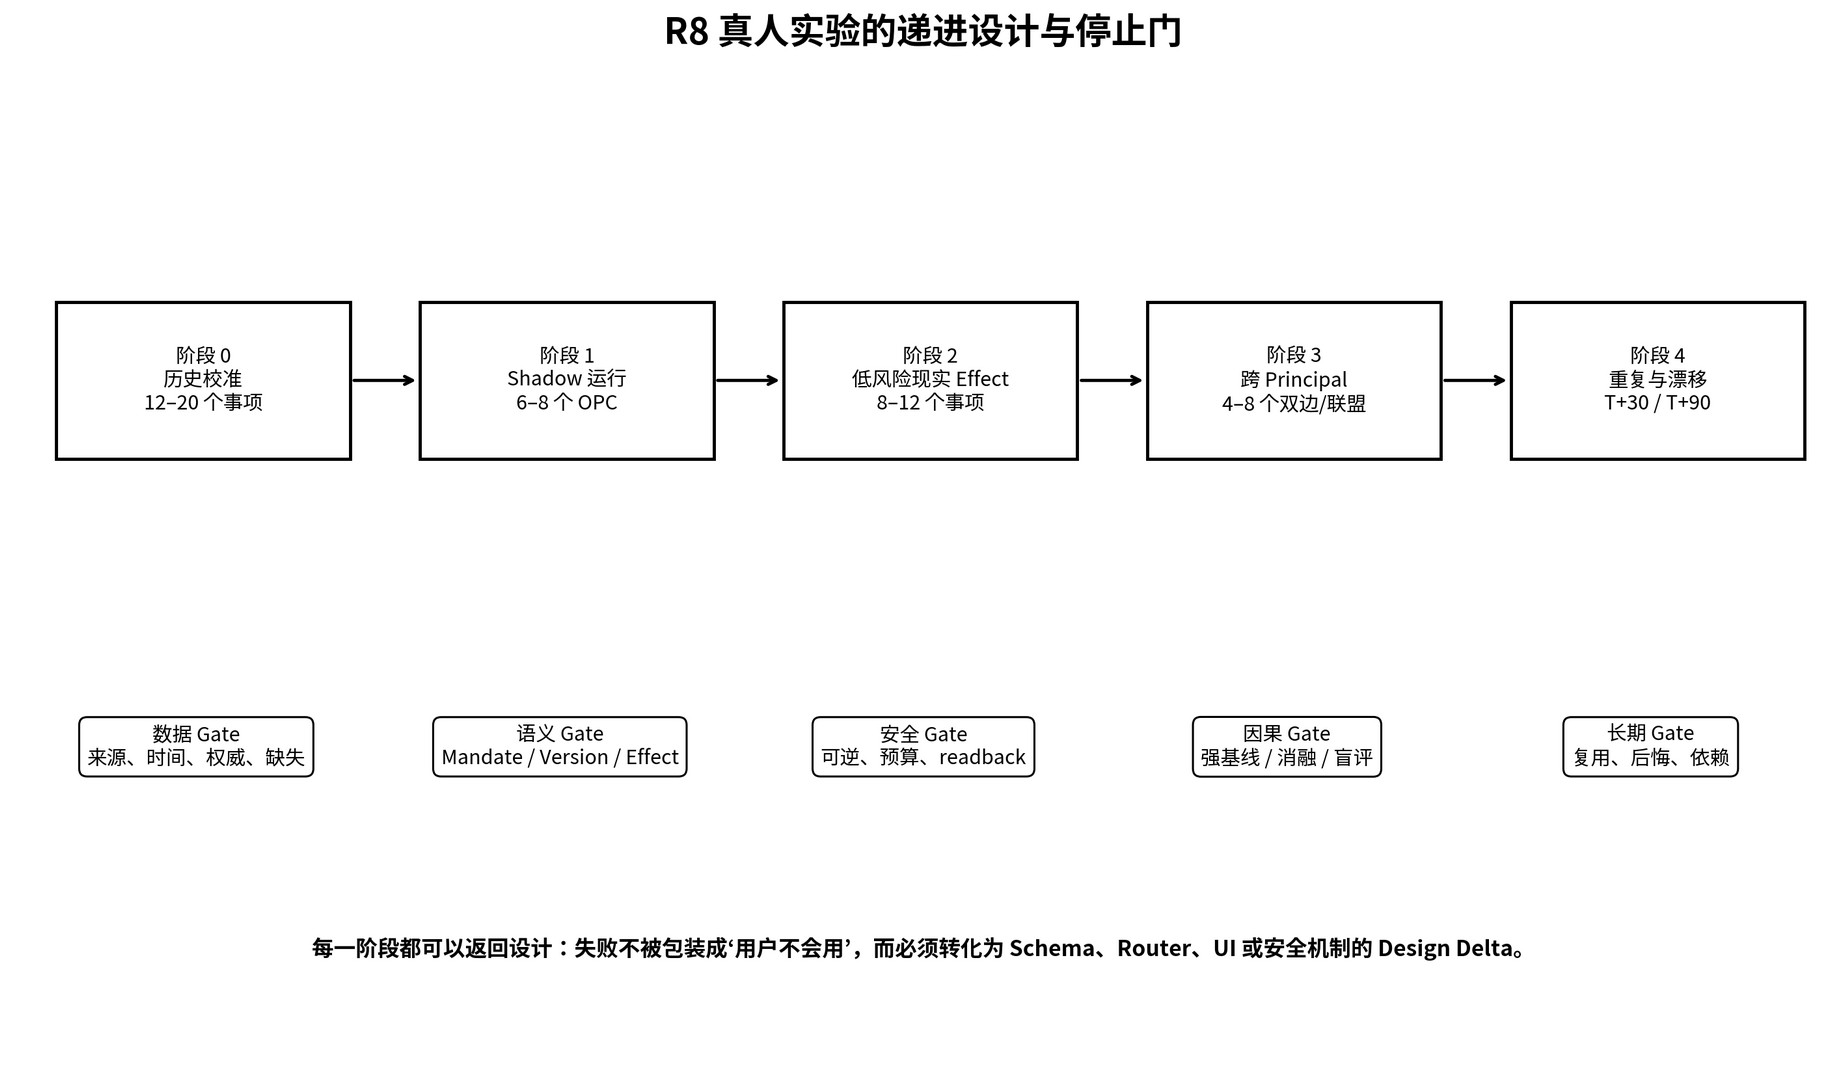 {width=96%}
OPC/超级个体参与者必须对至少一个真实经营域拥有原生决定权,例如品牌、预算、数据、账户、时间、交付或最终接受;可以有承包商和小团队,但必须能够识别外部责任根。跨责任根事项至少有两个不能互相代行的 Principal 或 Authority Locus。
一个 live matter 必须同时满足:正在发生或 30 天内发生;至少一个 material condition 不能被固定平台字段无损表达,或明确作为 CollapseSafe 负控制;首轮 Operation 低风险、可逆、可补偿或风险封顶;存在目标世界 before/after readback;参与者允许最少 T+7/T+30 随访;数据边界可以被分级。
标准付款、普通日历安排和已有成熟 SOP 的事项作为负控制;高风险医疗、重大法律/金融行动、未成年人、不可逆公开发布、重大自动支付、未经授权数据访问及无法获得真实决定者的事项排除。
研究的最小单位不是聊天消息,而是一个带来源、时间、版本、权威和现实后果的 Case Episode。每个 material event 至少保存:event_id、case_id、Entity/Authority Locus、RelationVersion、Mandate、事件类型、发生/观察/记录时间、actor/issuer、输入引用、输出或声明、provenance、Effect 引用、隐私级别和前序哈希。
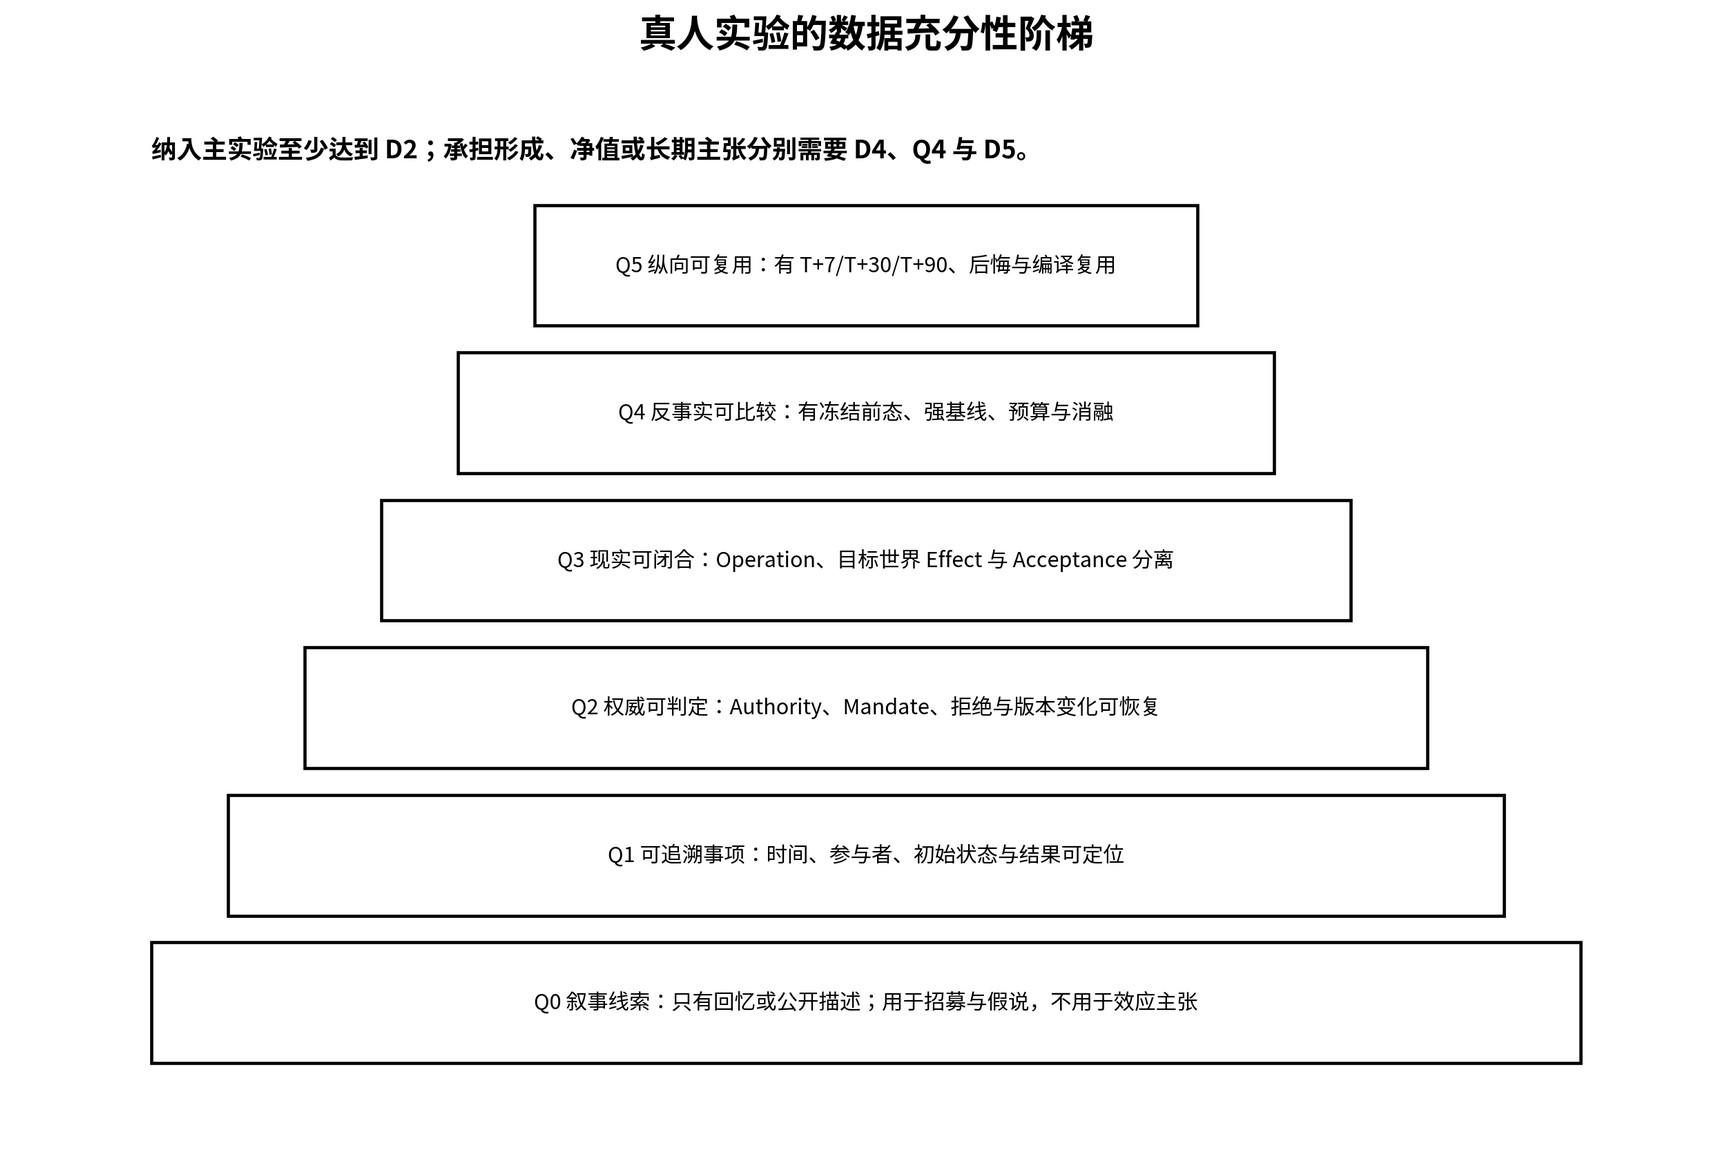
数据分为九类:D0 招募/同意;D1 Entity 与 Authority Map;D2 冻结的协调前私有前态;D3 Mandate 与策略;D4 RelationVersion 与 Stance;D5 Agent/模型/工具轨迹;D6 Operation、Effect 与目标世界证据;D7 Adoption、Acceptance、Settlement 与后悔;D8 成本、注意力、披露与体验。任何因果形成主张必须具有 D2、D4、D5、D6;任何真人闭环主张还必须具有 D3、D7 和随访。
数据充分性采用 Q0–Q5:Q0 只有叙事线索;Q1 可追溯事项;Q2 权威可判定;Q3 现实闭合;Q4 反事实可比较;Q5 有纵向复用和后悔。核心 H2/H3 结果至少达到 Q4,关于长期接受与编译价值的主张必须达到 Q5。
隐私采用 P0 Public、P1 Research-shareable、P2 Restricted、P3 Local-only 与 P4 Non-recordable。P3/P4 不因“模型需要上下文”而集中;系统保存相称主体已评估某边界的事件、cut、证明或聚合,不复制其内容。传输、计算、保留、派生、训练和再披露权分别记录。
 {width=90%}
每个事项至少产生:Case Screening;Participant/Entity/Authority Map;Frozen Pre-state;Mandate 与人工 Gate;RelationVersion 历史;Unknown/Defeater/Countercondition;Coordination Plan;Agent/工具/人工事件链;资源预留与 Commitment;Operation Specification;目标世界 Effect readback;Adoption/Acceptance/Reject/Defer/Dispute;成本与披露指标;独立 Outcome Adjudication;T+7/T+30(必要时 T+90)随访;以及本事项产生的 Design Delta。
参与者不需要填写一张巨大表单。典型投入是 20–35 分钟前态访谈、10–15 分钟 Mandate explain-back、每个 material change 5–10 分钟差异确认、一次低风险 Operation 决定、Effect 后 5–10 分钟接受判断,以及短随访。系统负责结构化和指出缺口;参与者只负责原生事实、授权、拒绝、承诺与接受。
真人研究使用五个条件:A 固定平台/标准表单;B 扁平强中心 Agent;C 权威感知中心 Hub;D 本地世界 + 联邦 Relation;E 有真实经验的人类经纪。A 必须是事项所在领域真实可用的平台流程;B 可以主动提问、调用相同工具和提出 probe,不能被故意削弱;C 保留 Authority、Mandate、RelationVersion、Effect/Acceptance,但部署集中;D 只在信息不可集中或 Hub 不可信时检验拓扑增量;E 不能由普通 LLM 角色扮演冒充。
各机器条件冻结同一前态,使用同一模型、temperature、工具、现实权限、token/提问/时间预算、重试和停止规则。研究系统不得独占更高质量的人工帮助。由于同一真实世界无法并行复制,首轮采用 live 运行 + 时间冻结离线 replay + 匹配事项/次序平衡 + 盲化独立裁决;不伪装成大样本随机对照。
主要假设为:H_sem 权威语义减少 wrong authority、false commitment 与 Effect/Acceptance 混淆;H_topology 在不可集中条件下减少敏感披露而不显著损失处置;H_formation 至少存在一条路径在可消融 formation operator 后才进入合格行动空间;H_routing 标准事项旁路重型形成;H_compile 重复运行降低高认知成本且 material change 只局部重开;H_explain Participant 能正确解释 Mandate、版本、下一 Operation、Effect witness 和撤销方法。
一条路径只有同时满足七项条件,才记为 causal formation candidate:冻结前态中不可达或不合格;形成动作可定位;动作后至少一个真实资格条件变化;相称 Authority 对新版本作出 Stance;进入 sandbox 或现实 Effect;移除该动作/伙伴/工具/授权/反条件后路径消失或降级;并记录“优秀经纪本可发现”“原信息遗漏”与“后见重写”等竞争解释。
主要终点不是成交率,而是:
T_truth:到达有证据的 COMMIT / REJECT / CONDITIONAL / DEFER_UNKNOWN / WITHDRAWN / DISPUTED 的时间;H_cog:需要理解、判断风险、授权和处理例外的人工分钟;首轮报告配对差异、区间、过程追踪、负例和 Design Delta,不用小样本 p 值包装普遍性。
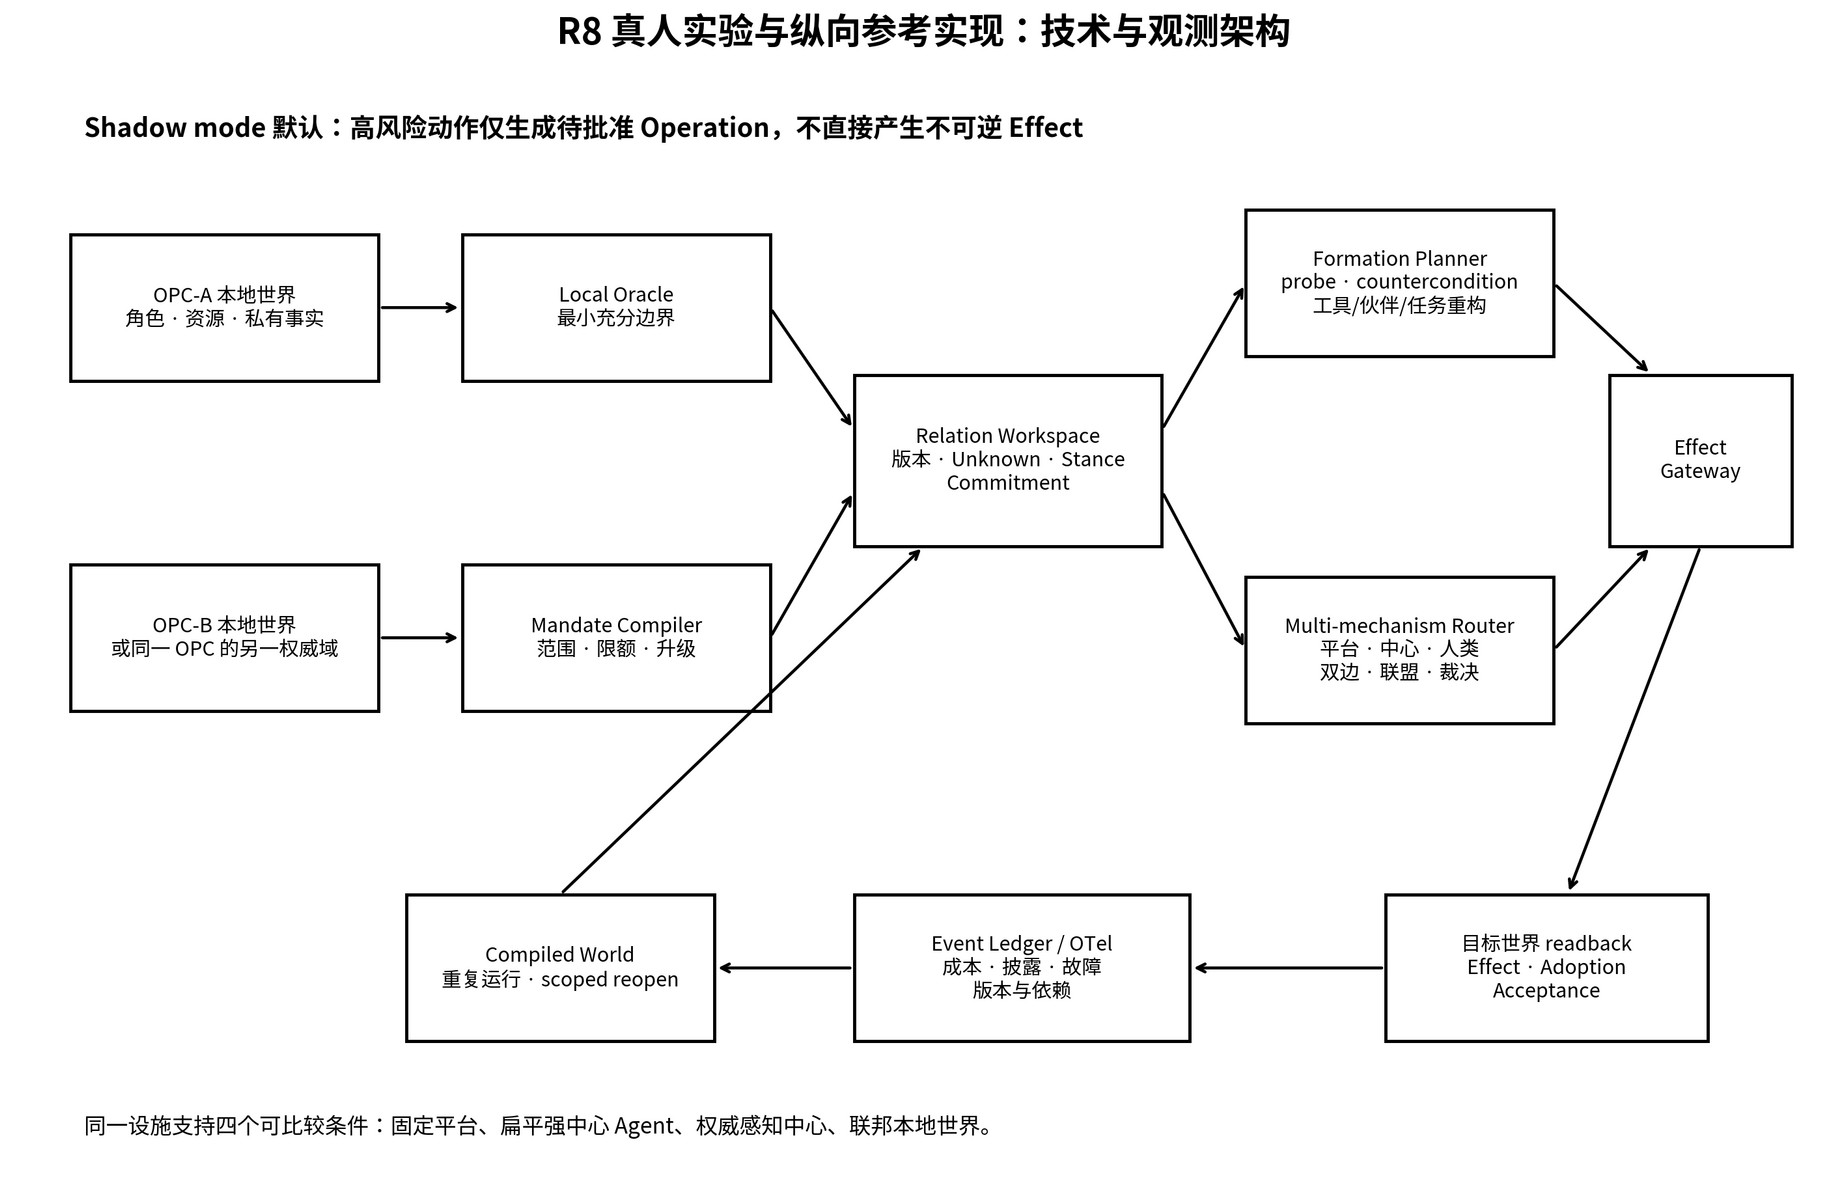
每个责任根拥有逻辑本地节点,内部可由 Interview、Mandate Compiler、Context Compiler、Boundary Oracle、Formation Planner、Router、Capability Assurance、Commitment、Operation 与 Observer 等角色协作。角色是权限和职责边界,不要求十个长期自治进程。Agent 之间交换的是 Entity/Mandate 引用、RelationVersion、Assertion、Unknown、countercondition、evidence reference、Capability assurance、Commitment、reservation receipt、Operation、Effect receipt、Acceptance 与 Defeater;自然语言是解释层,不是唯一权威状态。
 {width=96%}
最小基础设施包括:可认证 Entity 与工作负载身份;版本化 Mandate/Policy Store;本地世界与 Oracle;Relation Workspace;组合 Router;Reservation/Commitment Ledger;durable workflow;目标世界 Effect Connector;Acceptance Console;hash-chained Event Graph;模型/Prompt/Tool registry;成本与可观测性;隐私感知导出;撤销、冻结和补偿路径。
A2A 可以承载 Agent 的发现、Message/Task/Artifact;MCP/OAuth 可以承载工具和资源访问;VC/SPIFFE 可承担声明与工作负载身份;Cedar/OpenFGA 可作为策略和关系授权适配器;CloudEvents 可作为事件外壳;Temporal 可承担长周期可恢复工作流;OpenTelemetry 可采集 traces、metrics 和 logs。它们都是可替换组件,不替代 Principal、Mandate、RelationVersion、Commitment、Effect 或 Acceptance 的本文语义。
要验证的不是“消息能否互发”,而是:本地 Agent 是否只暴露任务相关边界;Coordinator 是否不能代替各方认领;Mandate 撤销是否传播;资源是否避免双重承诺;Operation 是否引用精确版本;Effect 是否由目标域而非执行方自证;同一关系中拒绝、退出和争议是否保持;稳定子图是否能被编译而 material Defeater 只重开依赖闭包。
推荐首例为三名 OPC 的受限数据联合交付。A 拥有客户关系和最终责任,B 提供数据处理,C 提供设计与演示;客户数据不得离开指定域、不得训练、预算和署名受限,最终验收尚未完全定义。固定平台能发现候选或支付;中心优化可排期;人类经纪可解释高语境;联邦形成负责本地数据边界、反条件与独立认领;确定性服务执行只读凭证和工单;目标域 connector 验证分析结果进入客户 backlog;最终 Acceptance 由 A 或客户权威完成。
建设性形成可能是:B 最初要求原始数据,数据 Authority 拒绝;系统提出“代码进入客户域、只读 query、禁止训练、结果脱敏、凭证自动过期”的 RelationVersion;sandbox probe 证明 B 的容器能在该边界运行;各方预留时间和预算后执行。若移除本地 Oracle、probe 或数据使用授权,路径不再合格,才支持形成主张。若权威感知中心 Hub 可以在相同披露边界下等价完成,则结论应是该事项不需要联邦拓扑。
首轮默认 shadow 或 human-in-the-loop;禁止自动重大付款、法律签署、删除、不可逆发布和未授权训练;凭证短期、最小权限、可撤销;P3 数据不出域。出现无法解释 Mandate、未经授权 Effect、预算超限、第三方被隐瞒、Effect 无法 readback、凭证无法撤销、严重角色胁迫或无法恢复时,立即停止,冻结新 Operation,撤销凭证和预留,保存事件链并进入事故复盘。
独立裁决者在盲化机制名称的条件下判断 truthful disposition、material conditions、正确 Authority、Effect、Acceptance、形成增量、竞争解释、第三方影响和 Q0–Q5 证据等级。系统输出不能同时充当结果真值。
该研究的理论价值是检验真实 Mandate、形成因果、Effect/Acceptance 与编译复用;技术价值是校准 Router、界面、Effect Connector、事件图、策略和重开;产品价值是识别用户真正愿意委托的边界、何时系统应退场以及价值主要来自形成还是复用。高价值负结果包括:人类经纪更优、中心部署已足够、用户无法维护显式 Mandate、Router 不可靠或重复运行不能降本;每一种都收缩适用域并改变架构。
进入扩大研究前至少要求:事件与版本可重放;零未经批准 Effect;explain-back 安全关键字段通过;至少一条可消融形成候选;标准任务不过度路由;第二次运行在至少一种真实成本上下降且错误不增。首轮 Owner 最小资源为:3–5 个可授权历史事项;6–8 位愿意参加 shadow 的 OPC,或先以 Owner 自身 10–20 个事项启动;2 个 30 天内可发生的低风险 live candidate;每个事项的真实决定者;可撤销 Effect 环境;一至两名独立裁决者;以及事件结构、耗时和脱敏结果的记录授权。
综合理论、实验和公开历史,以下结论目前具有最高稳定性:
开放任务中的行动空间会因工具、伙伴、授权、学习和任务重构而变化,任何固定 profile 都只能承担受限任务族中的投影。设计上,profile 用于提名,任务相关边界用于资格化。
一个候选被本地 Oracle 拒绝,可能暴露缺少的条件、工具、伙伴或执行位置。PFE 必须把 Unknown 和 Countercondition 转化为形成动作,而不是把所有拒绝当成永久失败。
能够运行一次不等于可承诺;工具成功不等于 Effect;Effect 不等于 Adoption;Adoption 不等于 Acceptance。系统必须保持成熟度和效力链。
模型可以高置信地错,也可以正确但无权作数。选择性执行、Mandate、Evidence 和 Authority 必须同时存在。
高阶互补可能创造新路径,但必须同时闭合资源、权威、Effect 和对外责任。
持续智能协商不是默认最优。零漂移与标准任务中,确定性机制更低成本;关系变化时只重开受影响子图。
以下主张已经获得明确但受限的机制证据:
这些结论不能直接外推为真实用户价值。
R5.4 只证明更丰富的规范表达。能力形成必须有可达路径变化、现实 probe、资源/授权变化或 Effect 证据。
R5 的 4.54 倍开销、标准任务旁路和公开制度负控制表明,中心化常是系统必要组件。正确命题是:权威和信息不可无损折叠的局部需要主权机制。
R5.2 能力 holdout 未通过预注册门槛,说明资格化、恢复和 freshness 必须长期维护。
NAC 保留为发现入口和多视角索引,不再承担开放世界本体。
技术域可以拥有状态与局部 Authority,却不具备人的价值认领、法律责任和长期接受。R5C 因此被限定为技术权威域证据。
58/58 映射只说明当前编码无残差,不排除编码者吸收偏差。七维是当前最简操作化候选,不是已证完备本体。
| 证据 | 否定/暴露 | 系统改动 | |---|---|---| | Boundary Oracle | 静态 profile 资格化失败 | 任务相关 Oracle、披露预算 | | Team Constitution | 成对/公开能力不见高阶互补 | COLUMN、临时联盟、超边 | | Probabilistic Oracle | 低熵/高置信可稳定错误 | abstain、风险门、Authority 分离 | | Trust Concurrency | check-then-write 超卖 | 原子 reservation | | R5 Effect | stdout/退出码冒充现实 | Effect Gateway、目标 readback | | R5 能力 | installed 冒充可达能力 | 环境/权限/审批绑定 | | R5.2 重建 | 单终态丢失 10/17 | Attempt/Effect/Adoption/Acceptance | | R5.2 holdout | 能力合同 4/6 未过门 | recovery、freshness、Unknown | | R5.4 | 更多语言≠更多能力 | 形成判据、强中心基线 | | R5C | 生产者不能自证 adoption | Target Authority、revoke/recovery | | v0.4 ontology | 对象增生/字段扁平化两端失败 | 六 roots + typed events/provenance | | v0.4 materiality | 永不/永远/任意 diff 重开均差 | typed materiality + scoped reopen | | 公开过程 | 成交不是唯一形成 | protective contraction、Standing | | Open Banking | 规则存在≠运行生效 | Enactment Assurance | | Crossrail | 局部完成≠端到端 Effect | dependency graph、system witness | | QDR | 相似顾虑≠唯一机制 | 组合 Router、情境化选择 | | 盲化诊断 | 结构模型不能精确预言 | 高召回 probe ranking | | Replay | 摘要/单状态丢失过程 | 版本化权威事件图 | | OPC fixtures | 初始 Router 漏资源/争议/自执行 | reservation、freeze、pre-effect Gate |
可以把本文的核心压缩为一条依赖链,但不能再把链条写成简单流程:
[ {W_i} \xrightarrow{boundary} \Gamma_v \xrightarrow{formation} Q_t, ]
[ Q_t \xrightarrow{qualification} Cap \xrightarrow{recognition/commitment} C, ]
[ C \xrightarrow{operation} Eff \xrightarrow{adoption/acceptance} S, ]
[ S \xrightarrow{compile/reopen} CW. ]
每个箭头都不是自动映射,而是一个需要相称证据、权威和失败处理的门。三个形成循环和五种贯穿语义使该链条可以递归返回。
本文的潜在原创贡献不应写成“首次提出权限、承诺、共同对象或多中心治理”。更准确的表述是:
本研究把任务相关主权边界、未预定义行动空间构成、条件性能力资格化、范围化授权与认领、目标世界效力、机制组合、局部确定性编译和 scoped reopen,组织为一套面向 Agent Entity、尤其是超级个体与 OPC 的统一可运行体系,并用正负实验持续改变其设计。
其原创性是否足以构成学术贡献,最终还取决于真实 OPC 结果和与强基线的比较。
对事项 (z),总成本至少包括:
[ C_{pre}(z)=C_{attention}+C_{disclosure}+C_{search}+C_{formation}, ]
[ C_{run}(z)=C_{verification}+C_{execution}+C_{delay}, ]
[ C(z)=C_{pre}(z)+C_{run}(z)+C_{governance}+C_{recovery}. ]
其中 OPC 最稀缺的往往是 C_attention:创始人必须处理高语境判断、解释、异常和责任。一个系统即使增加模型调用和机器交互,只要显著降低人的高认知时间,也可能有正净值;反之,形式对象越多、每次都要求本人确认,也可能让系统失去价值。
需要分别测量:
真实机制比较不能只看成交数。平台可能高效促成标准交易,却在非标准关系中产生大量 late reject;重型形成可能减少错误,却让简单任务成本过高。
本文建议以主体级和系统级两套价值函数报告。
主体 (i) 的净值:
[ V_i = B_i(Eff,Acc) - C_i - L_i - Risk_i - Regret_i. ]
系统级值不应简单求和,因为权力和外部性可能不可公度。至少应报告:
一个形成动作的价值可能来自三类结果:
因此,系统目标不是最大化 COMMIT,而是最小化达到真实处置的成本与错误。
首次形成可能昂贵,但稳定关系可以编译并复用。设初次形成成本 (F_0),每次编译运行成本 (c),开放重新协调成本 (f),关系复用 (N) 次,Defeater 概率 (p),重开成本 (r)。编译净节省为:
[ Saving(N)=N(f-c)-F_0-pNr. ]
这说明通爻更可能在有重复价值、边界可稳定且关系可编译的场景成立,而不是一次性、低价值、完全标准的事项。
未来实验必须使用强基线:
比较指标应包括:
真实处置时间
高认知人类分钟
总披露量与敏感披露
关键条件召回
错误 Authority 归属
False Commit / False Reject
现实 Effect 与 Acceptance
30/90 天后悔与 reopen
每次复用边际成本
若通爻只比弱聊天机器人好,不足以支持产品和理论价值。
对于 OPC,最初产品不应是一个“Agent 社交网络”,而可能是:
开放市场和 Agent-to-Agent 发现只有在这些纵向闭环成立后才有稳定地基。
主体可能隐藏容量、夸大能力、伪造证据、策略性提出 countercondition,或利用系统学习他人边界。廉价自报在早期合成实验中出现高虚假入选率;证据、声誉、验证和风险共担能降低,但不能消除。
系统需要组合:
即使数据和权威保持本地,协调器仍可能通过以下方式拥有巨大权力:
因此,Router、PFE 和诊断器必须可解释、可替换、可审计;关键排序规则和费用结构应能被主体理解和挑战。所谓“去中心化”若仍由一个黑箱协调器控制注意力和候选,也可能比传统平台更难审计。
即使授权 scope 精确,若优化目标属于平台而非 Principal,系统仍可能在合法动作内产生偏离。历史合成实验曾显示,在高能力条件下,使用 Principal 目标的机制相对平台目标显著降低后悔。精确数字因原始实现不足被降级,但结构问题成立:
[ Authorized(a) \nRightarrow Aligned(a). ]
Mandate 必须同时表达“能做什么”和“为了谁的什么目标”。
双边同意不保证关系合法或社会可接受。数据合作可能影响未参与的数据主体;平台匹配可能改变劳动条件;自动采购可能把风险转嫁给供应链;OPC 使用 Agent 承诺交付可能让外包者承担隐形加班。
系统必须允许:
Agent 可能比 Principal 更擅长表达,从而让其输出看起来“更像真正意图”。这既是价值,也是风险。informed recognition 至少需要:
未来实验不能只记录“用户点了同意”,而应评估其理解、后悔和长期一致性。
人类并非永远需要逐项审批。更合理的角色是:
系统的成功不在于删除人,而在于让人的注意力集中在只有人或相称制度能作数的地方。
| 威胁 | 失败方式 | 主要防护 | |---|---|---| | Prompt injection | 外部内容诱导 Agent 越权 | Mandate Gate、工具隔离、数据来源标记 | | Credential theft | 冒用 Entity/Authority | 强认证、短期令牌、硬件或多因素 | | Scope creep | 长期运行逐步扩大权限 | 版本化 Mandate、过期、差异检查 | | Evidence spoofing | 假日志/假回执 | 目标域 witness、签名、独立 readback | | Boundary reconstruction | 多轮查询还原私有世界 | 预算、粒度、速率、用途限制 | | Resource oversell | 多 Agent 重复承诺 | 原子 reservation | | Model projection | 把平台/模型目标写成用户偏好 | 来源分离、explain-back、人工 Gate | | Hidden externality | 双边关系伤害第三方 | Standing、政策门、审计与挑战 | | Stale compilation | 旧规则继续运行 | Defeater、health check、scoped reopen | | Collusion/strategic oracle | 多方合谋或虚假 countercondition | 证据、押金、随机审计、裁决 |
目前已经建立的不是一个经过市场证明的通用 Agent 经济协议,而是:
这些成果已经足以指导真实系统建设,但尚不足以证明整体产品价值。
当前决定体系是否最终成立的核心问题是:
真实 OPC 是否能够通过范围化 Agent 委托和多机制形成,因果地获得一项强平台、强中心 Agent 或优秀人类经纪无法以更低成本无损产生的联合能力,并在长期保持理解、责任、接受和正净价值?
它包含四个子问题:
若出现以下结果,本文核心理论应被显著修订或放弃:
在真实外部资源有限时,仍可继续:
强基线必须真正执行:
不允许把通爻实现成完整系统,却用简单表单或弱模型作为对照。
首个真实实验应为低风险、可逆、非标准、可产生真实 Effect 的合作。例如:一个 OPC 客户与一个 AI 服务 OPC 形成 7–14 天只读、无训练、预算封顶、可撤销的数据分析试点。
实验步骤:
主要终点:真实处置时间、人类高认知分钟、敏感披露、关键条件召回、错误 Authority、Effect/Acceptance、后悔和净值。
本轮已经实现 Fieldkit v0.8,而非仅保留为路线图。它在不增加 canonical root 的前提下加入三类派生视图/检查:一个定位外部责任、局部权威、有效委托与义务终止位置的视图;一个表达由人、Agent、工具、平台、承包商、社区、数据与编译服务组成的复数执行身体的能力图;一个在 Router 前对任务给出接受、重构、局部试探、保护性收缩或延迟未知建议的检查。37 项单元测试通过。
该实现只证明当前语义在研究仪器中一致,不证明真实 OPC 会理解、采用或获益。v0.9 的主要缺口是:真实身份与短期凭证;资源连接器和可撤销预留;cost-sensitive probe ranking;A2A/MCP/OAuth/VC 适配;生产 Effect connector 与 authoritative readback;explain-back/差异认领界面;Standing 与第三方外部性 Gate;强基线统一运行器;30/90 天 follow-up;模型升级、权限漂移和长周期故障注入。任何连接器都必须保持核心语义可替换,不能把具体平台写成理论本体。
从本版起,后续每轮研究必须写回同一篇论文:
本文研究的不是 Agent 如何互相发消息,而是智能主体如何在不可折叠主权条件下共同形成现实。其最小对象不是模型,而是一个对外连续、可认证、可授权、可追责,内部却允许人、角色、模型、工具、账户和非数字化判断共同存在的 Agent Entity。其核心过程不是静态匹配,而是:通过任务相关边界构成问题,通过形成算子创造或排除路径,通过 CRA 把候选转为条件性能力,通过 Authority、Recognition、Commitment 和资源预留使其获得规范效力,再通过 Operation、目标世界 Effect、Adoption、Acceptance 和 Settlement 进入现实。
这套体系不把中心化视为敌人。标准任务、公共计算、索引、排期、支付和重复运行都应充分利用中心平台和确定性服务;只有完整信息无法合法集中、权威不能被代行、关系语法未形成或现实变化需要主体重开时,主权 A2A 才具有结构必要性。系统的输出也不以成交为唯一成功:快速而真实的拒绝、保护性收缩和有证据的未知,同样是协调价值。
多轮证据已经建立若干稳定不变量,也留下明确限制。合成机制、真实仓库、跨技术域、公开历史和访谈证明这些结构并非纯粹形而上;但它们尚未替代真实 OPC 的委托、认领和长期净价值。下一阶段最重要的不是增加新术语或更大的合成样本,而是用强平台、强中心 Agent、优秀人类经纪和组合 Router 共同进入真实低风险事项,测量是否真的形成了原本不可达的能力,并把人的注意力保留在只有真实主体能够作数的位置。
主权代理操作系统的最终价值不在于让 Agent 彼此说更多话,而在于:让一个超级个体能够在不放弃自己的边界、责任和真实性的前提下,稳定地形成过去无法独自承担的现实行动。
本附录防止“没有出现在最新正文中”被误认为已经无损统一。每个历史概念均给出原始贡献、后续限制和当前身份。
| 概念 | 原始贡献 | 后续限制/反例 | 当前身份 | |---|---|---|---| | HDC | 多维语义位置与主体异质性 | 固定维度无法覆盖开放任务 | 历史发现层理论 | | FHRR | 关系、资源与需求的结构化表示 | 容易把投影当作完整世界 | 发现和候选生成方法 | | 多语义向量签名 | 避免单 embedding 压平语义 | 仍是静态投影 | 公共发现索引 | | NAC | 嵌套锚点、多视角进入主体 | 不具普遍语义完备性 | 边界发现接口候选 | | 四动词 | 发现—询问—验证—行动的最小交互 | 无法承担完整规范与效力本体 | API 兼容层 | | 类型账本 | 使行动、证据和对象可追溯 | 若平面化会对象增生 | Event Ledger 先驱 | | Flowness Harness | 上下文、工具、权限与执行闭环 | 早期未充分区分 Effect/Acceptance | 主权节点与执行环境基础 | | PRSE/PRSE-OS | 研究—设计—规格—工程往返 | 不是 A2A 协调本体 | 研究和系统构造方法 | | BIC | 以行为边界替代完整画像 | 仅在任务与风险范围内充分 | L1 核心理论 | | Boundary Oracle | cut、witness、unknown、refusal | 策略行为和重建攻击仍开放 | L1 运行接口 | | Coordination Schema | 形成角色、动作、权威、证据和结果语义 | 需要区分制度框架和关系实例 | L2 核心对象结构 | | SJAC | 主权联合行动构成 | 不应被物化成单一 root | L2–L5 理论过程 | | JAA | 版本化共同编辑介质 | 不能成为全局事实权威 | RelationVersion 的共同视图 | | PFE | 从 Unknown 选择形成动作 | 尚无现实最优性与成本校准 | L3 方法层 | | CRA | 能力资格化、反驳和保证 | 当前预测证据有限 | L4 方法层 | | CapabilityEnvelope | 条件性、版本化能力边界 | 不能替 Commitment 或 capacity reservation | 派生/运行视图 | | AssuranceCase | Claim、Evidence、Defeater 的结构化论证 | 证据充分性仍需主体和制度判断 | 认识与保证视图 | | Recognition | 对精确版本的理解与认领 | 不能缩为点击同意 | L5 规范事件 | | AuthorityGrant | 范围化委托 | 与身份、能力不同 | 统一为 Mandate | | Commitment | 未来义务与问责 | 不能从语言一致自动产生 | canonical root | | ResourceReservation | 防止并发超卖 | 需要真实资源连接器 | Commitment 激活前机制 | | ActionAttempt | 一次执行尝试 | 不证明目标状态 | Operation 运行事件 | | Effect | 目标世界状态变化 | 不能由调用方自证 | L6 核心事实 | | Adoption | 目标域纳入运行 | 不等于 Principal 接受 | L6 独立事件 | | Acceptance | 有权主体对 Effect/交付的认领 | 可能晚于或拒绝 Adoption | Stance/规范状态 | | Settlement | 义务与争议的当前处置 | 可被新证据重开 | 派生状态 | | Compiled World | 稳定关系的可运行投影 | 不能成为第二事实源 | L7 派生运行体 | | WoWok | 可编程信任、托管、仲裁等外部对象 | 不是唯一实现或理论前提 | TrustAdapter 示例 | | Relation Artifact | 共同关系对象的早期名称 | 与 JAA/RelationVersion 重叠 | 合并为 RelationVersion + shared view | | UsageGrant | 数据用途和使用授权 | 默认无需独立 root | Mandate scope;必要时独立 Commitment | | DataUseEvent | 实际数据使用 | 不是规范授权本身 | typed Event | | DerivationRecord | 输入—输出派生 | 默认无需独立生命周期 | provenance edge | | JointArtifactRights | 联合制品控制和收益 | 仅高风险时需独立治理 | conditional Commitment/policy | | LearningUpdate | 进入长期记忆或模型 | 关键在持久 Effect 和撤销义务 | Effect event | | Stability Axis | 统一成熟度直觉 | 单轴会掩盖技术/治理分裂 | 成熟度偏序 + 五维稳定向量 | | Agent-to-Agent | 最初项目名称 | 容易被误解为通信协议或全程去中心化 | 系统中的一种连接/协调形式 | | 主权代理操作系统 | 统一系统名称 | 需防止包住所有问题 | 当前工程—理论总称,受 CollapseSafe 与证据边界约束 |
以下为规范性摘要,不替代可执行 JSON Schema。
〔公开版删改 · R-01〕 本处原文为〔核心对象 Entity 的字段级 YAML Schema〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-01。此删改不改变本文任何实验结论的方向。
〔公开版删改 · R-02〕 本处原文为〔核心对象 AuthorityLocus 的字段级 YAML Schema〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-02。此删改不改变本文任何实验结论的方向。
AuthorityLocus 不必单独成为 canonical root;它可以作为 Entity 下的版本化权威记录,但其变更必须可追溯。
〔公开版删改 · R-03〕 本处原文为〔核心对象 Mandate 的字段级 YAML Schema〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-03。此删改不改变本文任何实验结论的方向。
〔公开版删改 · R-04〕 本处原文为〔核心对象 RelationVersion 的字段级 YAML Schema〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-04。此删改不改变本文任何实验结论的方向。
〔公开版删改 · R-05〕 本处原文为〔核心对象 Assertion 的字段级 YAML Schema〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-05。此删改不改变本文任何实验结论的方向。
模型 Assertion 与 Authority Assertion 使用相同外壳,但 issuer 和 epistemic_status 防止二者混淆。
〔公开版删改 · R-06〕 本处原文为〔核心对象 Commitment 的字段级 YAML Schema〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-06。此删改不改变本文任何实验结论的方向。
〔公开版删改 · R-07〕 本处原文为〔核心对象 Operation 的字段级 YAML Schema〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-07。此删改不改变本文任何实验结论的方向。
〔公开版删改 · R-08〕 本处原文为〔核心对象 EventEnvelope 的字段级 YAML Schema〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-08。此删改不改变本文任何实验结论的方向。
DRAFT
  ├─ propose → PROPOSED
  └─ abandon → WITHDRAWN
PROPOSED
  ├─ material revision → DRAFT(new version)
  ├─ all required stances → RECOGNIZED
  ├─ reject → REJECTED
  └─ defer → DEFERRED
RECOGNIZED
  ├─ capability/evidence/resource gates → COMMIT_READY
  └─ defeater → REOPENED
COMMIT_READY
  ├─ commitments active → ACTIVE
  └─ expiry/material change → REOPENED
ACTIVE
  ├─ obligations complete → COMPLETED
  ├─ dispute → DISPUTED
  ├─ withdrawal/termination → TERMINATED
  └─ defeater → REOPENED
PROPOSED → ACTIVE → NARROWED → REVOKED
                  └→ EXPIRED
规则:narrow 只减少权限;扩展必须生成新版本并由 issuer 重新签发。Revocation 不自动撤销已经发生的 Effect,但会阻止后续 Operation,并触发依赖 Commitment 检查。
PROPOSED
→ RECOGNIZED
→ RESERVED
→ ACTIVE
→ FULFILLED / BREACHED / WITHDRAWN / DISPUTED
→ SETTLED / REOPENED
RESERVED 不代表义务已激活;它表示关键资源已被原子占用。若 reservation 过期,Commitment 回到待资源状态而非继续有效。
SPECIFIED → AUTHORIZED → ATTEMPTED
ATTEMPTED → NO_EFFECT | PARTIAL_EFFECT | EFFECT_CONFIRMED | EFFECT_UNKNOWN
EFFECT_CONFIRMED → ADOPTED | NOT_ADOPTED | REVOKED
ADOPTED → ACCEPTED | CONDITIONAL | REJECTED | DISPUTED
〔公开版删改 · R-09〕 本处原文为〔Materiality 判定算法的可执行伪代码〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-09。此删改不改变本文任何实验结论的方向。
〔公开版删改 · R-10〕 本处原文为〔Scoped reopen 依赖闭包遍历的可执行伪代码〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-10。此删改不改变本文任何实验结论的方向。
| ID | 实验/材料 | 对象 | 关键结果 | 最高等级 | 当前可承担主张 | 主要不能承担 | |---|---|---|---|---|---|---| | P-V15 | 协议 v1.5 | 设计、NAC、四动词、类型账本 | 保留问题与接口谱系 | E0–E2 mixed | 早期发现与生成动机 | 现实频率、商业价值 | | R2-B | Boundary Oracle | 私有线性约束 | adaptive 可行率 1.0;披露 22/25/31/46;full 90;static 0 | E2 | 受限世界中交互边界可减少披露 | 真实披露意愿、通用最优 | | R2-T | Team Constitution | 隐藏贡献模式 | price-guided 可行 1.0、成本比 1.000354;profile 0.02 | E2 | 开放列优于公开 profile | 真实策略行为 | | R2-P | Probabilistic Oracle | 漂移/高置信错误 | unguarded 0.5603/0.6683;gate 错误 0.0479/0.0612,覆盖 0.03/0.0235 | E2 | 风险门需 abstain,低熵非权威 | 现实最优阈值 | | R2-C | Trust Concurrency | 共享预算并发 | check-then-write overspend 0.60461;reservation 0 | E2–E3 | Commitment 前原子预留 | 生产性能 | | R5-L | 本地现实 | macOS/Git/Docker/FS | 18 证据仅 2 可达;stdout/exit 4/9;Effect contract 9/9;主权开销 4.54x | E4 | Effect Gateway、环境/权限能力 | 多 Principal 与商业价值 | | R5.2-E | Effect 重建 | Harness 真实事件 | naive 17 场景错 10;显式重建 17/17 | E4 | 四阶段语义不可折叠 | 法律/业务接受 | | R5.2-C | 能力 holdout | 6 个真实动作 | 合同 4/6,低于 80%;installed 3/6 | E4 | 能力需环境/恢复/freshness | 广泛预测力 | | R5.4 | 真实模型协商 | 两个合成权威 | 条款更丰富;无签署/补丁/adoption;AcceptedOriginalValue 0;成本约 2.49x | E6 limited | 语言形成不等于能力 | 中心基线、真实偏好 | | R5C | 跨技术域闭环 | source/target authority | adopted→revoked→offline→adopted;wrong authority 失败 | E5 | probe+countercondition 可形成技术路径 | 人类认领、独特净值 | | L8 | 早期八组摘要 | 合成 | 精确数字无原始包 | reported | 研究问题线索 | 独立复现、现实频率 | | R6 | 18 万/210 万摘要 | 合成 | 报告存在、原始实现不足 | reported | 假说与压力测试设计 | 精确数字、强证据 | | V04-O | 本体收敛 | 50k 场景×5 查询 | 收敛表示 0 错;flatten 48,926/250k;24.624% rights 升级 | E2 | 减少 roots 可保留给定查询 | 唯一性、法律充分 | | V04-S | Schema materiality | 30k 变化 | typed 0 错;any diff 26.76%;always 44.74%;never 55.26% | E2–E3 | materiality 可操作化 | 自动解决现实争议 | | V04-F | Fieldkit | 单元/虚构样例 | 11 测试;21 事件;2 版本 | E3 | 真实实验可结构化记录 | 可用性/安全 | | V05-P | PEA-10 | 正式制度档案 | 1 expansion、3 transformation、5 contraction、1 clarification;外部 Authority 7/10 | H/E4 | 形成包括保护性收缩 | 频率、Agent 因果 | | V05-R | 三案过程 | 33 事件 | 28/33 完整;公告召回 18.2%/25.8%/25.0% | H/E4 | 摘要丢失形成过程 | 七维完备、真实 Mandate | | V05-SH | Shadow cases | 3 历史案 | 7 版本、17 事件、4 material transition | E3/H bridge | Fieldkit 可表达公开结构 | 历史反事实优越性 | | V06-7 | 七案扩展 | 58 事件 | 37 material、51 critical、53/58 完整、6 Standing、3 declared/enacted | H/E4 | Standing、稳定向量、Enactment | 完备性与因果 | | QDR | 52 访谈 | SGMA 协调 | 18 流域 15 配置;nearest same 1/18;审计 42/7/5 | H | 相似顾虑不唯一决定机制 | OPC 频率 | | BC-11 | 盲化 checkpoint | 11 时间截点 | F1 0/0.516/0.677/0.756;recall 0.891;exact 0/11 | H/E2 bridge | 结构诊断用于 probe 排序 | 自动预言 | | Replay | 三机制表示 | 58 事件 | 公告 10.2%;单状态 7.0%;版本图 100% | E2–E3 | 版本图保留已编码结构 | 自动抽取与价值 | | OPC-24 | 构造 Router | 24 场景 | 平台 6/24;全局 Agent 0/24;修复 Router 24/24 | E2–E3 | 暴露结构缺口 | 现实成功率 | | FK-07 | Fieldkit v0.7 | 研究仪器 | 31 单元测试 | E3 | 状态机和对象可实现 | 生产安全/用户接受 |
| 主张 | 当前状态 | 支持证据 | 竞争解释/缺口 | 下一判别实验 | |---|---|---|---|---| | 静态画像不普遍充分 | F + M | 命题 1、R2-B、R2-T | 受限任务可充分 | 明确任务族的现实 OPC 对照 | | 任务相关边界可减少披露 | M scoped | R2-B | 现实主体可能不愿回答;重建攻击 | 真实边界访谈 + 披露审计 | | 高阶互补需要超边/列 | F + M | 命题 3、R2-T | 人类经纪可能隐式完成 | 多方 OPC 联合投标强基线 | | 概率与权威正交 | F + M/E | 命题 4、R2-P、R5.4 | 强模型可降低错误但不产生权威 | 高能力模型 + 固定/范围 Mandate | | 能力是条件性合约 | E scoped | R5、R5.2-C | 当前合同预测力不足 | 多环境 holdout 与长期 drift | | 一次成功不等于能力 | F + E | 命题 5、R5.2-C | 某些低风险任务 demo 足够 | 风险分层资格化对照 | | Attempt/Effect 分离必要 | E strong local | R5、R5.2-E | 单域简单任务可合并视图 | 多域 Effect connector 实验 | | Adoption/Acceptance 分离必要 | E5/H | R5C、公开过程 | 某些自动系统无独立业务接受 | 真实 OPC 交付和验收 | | 多轮语言协商不等于形成 | E6 negative | R5.4 | 任务本身可能可折叠 | 强中心和现实 probe 对照 | | probe+countercondition 可形成新路径 | E5 scoped | R5C | 同权限中心也可能形成 | matched central baseline | | 形成后局部编译可降成本 | F/M candidate | 命题 11、合成报告 | 现实漂移或重开成本过高 | 90 天重复关系实验 | | 原子预留防超卖 | F+M | 命题 7、R2-C | 实际资源连接器复杂 | OPC 时间/预算真实预留 | | Relation Schema materiality 可操作化 | M/E3 | V04-S | 生成器自证、隐式依赖 | 双人历史编码 + runtime defeater | | 七维 Schema 足够 | open | 58/58 映射 | 单编码者吸收偏差 | 独立编码与残差收集 | | Standing 与 Authority 应分离 | H + design | Sidewalk、监管案 | 具体效力高度制度依赖 | OPC 第三方/数据主体案例 | | Declared ≠ Enacted | H + E intuition | Open Banking、R5 | 可能只是治理执行问题 | Enactment Assurance 预测 | | 多机制 Router 优于单一机制 | open | QDR、OPC fixtures | 场景与 Router 同源 | 强基线真实/历史 replay | | OPC 是合适首发域 | hypothesis | 结构分析、可实验性 | 多角色复杂度可能高于收益 | 2–4 个 live OPC cases | | 组合系统提高净价值 | unproven | 无 E7 | 人类经纪/平台可能更好 | 随机/交叉强基线比较 | | 真实主体可理解精确 Mandate | unproven | 无 E7 | 形式化增加认知负担 | explain-back、后悔与撤回测量 |
Principal:能够产生原生认领、授权、承诺、接受并承担责任的规范主体。
Agent Entity:对外可寻址、可认证、具有连续性和责任映射,内部可由人、模型、工具、工作流和账户组成的代理实体。
Authority Root:身份、责任或权威可被外部验证的信任来源。
Authority Locus:在特定范围内拥有提出、认领、签署、执行、见证、采用、接受或挑战权限的位置。
Mandate:Principal/Authority Locus 对 Agent Entity 或 Execution 的版本化、范围化、可撤销委托。
AgentExecution:在特定 Mandate、上下文、执行器、工具和预算下发生的一次运行。
Sovereign World:主体本地的历史、目标、能力、资源、权威、政策、制度和执行环境;不可假设被中心无损复制。
Boundary Oracle:在不暴露完整世界的情况下返回任务相关 cut、witness、column、unknown、refusal 或 countercondition 的接口。
BIC:Behavioral Interface/Boundary Sufficiency;任务相关边界充分性理论。
NAC:Nested Anchor Coordinates;早期多视角发现表示,当前作为 discovery interface 候选。
Coordination Schema:(\Gamma=\langle R,V,T,A,E,D,O\rangle),描述角色、词汇、转移、权威、证据、数据权利和结果语义。
Institutional Frame:法律、行业、组织或平台预先提供的关系元规则 (\Gamma^I)。
RelationVersion:特定事项的版本化关系结构与参数 (\Gamma^R_v)。
SJAC:Sovereign Joint-Action Constitution;多个主权主体共同形成联合行动结构的过程理论。
JAA:Joint Action Artifact;版本化共同协调介质,不是全局事实权威。
Unknown:尚未闭合的认识、语义、能力、权威、资源、权利、偏好、策略、环境或规范缺口。
Formation Operator:能够改变候选空间、可行条件、参与结构、能力、权威或证据的受控动作。
PFE:Possibility Formation Engine;选择和执行形成动作的策略层。
ECVI:Expected Coordination Value of Intervention;形成动作对合格行动空间的预期净价值。
Capability Claim:在具体执行器、环境、权限、资源、输入、时间和恢复条件下产生某 Effect 的主张。
CRA:Capability Realization and Assurance;将候选路径转化为资格化能力的生成—反驳循环。
CapabilityEnvelope:某能力在当前条件和保证范围内的派生视图。
AssuranceCase:围绕 Claim 的证据、假设、论证、Defeater 与残余风险结构。
Recognition:相称 Authority 对精确版本的理解和认领。
Stance:主体对 Claim、RelationVersion 或 Effect 的版本化立场事件。
Commitment:在条件成立时产生未来义务、资源和补救的规范对象。
ResourceReservation:Commitment 激活前对稀缺资源的原子预留。
Operation:受 Mandate 和 RelationVersion 约束的可执行动作规范。
ActionAttempt:Operation 的一次运行尝试。
Effect:目标世界中由相称 witness 观察到的状态变化。
Verification:对 Claim 的证据支持判断。
Adoption:目标域将结果纳入真实运行状态。
Acceptance:有权主体对 Effect 和交付义务的认领。
Settlement:义务与争议在当前制度下达到的处置状态。
Defeater:使 Claim、Capability、Mandate、Effect、Acceptance 或编译状态失效/降级的新证据或变化。
Compiled World:稳定关系子图的确定性运行投影,不是第二事实源。
CollapseSafe:中心机制可在保持信息、权威、Standing、结果语义和成本条件下无损替代联邦机制的充分性候选。
Standing:对关系提出挑战、要求解释、参与审查或获得救济的资格,不等同于最终签署权。
Enactment Assurance:规则在运行中被观察、执行、升级和补救的保证,而不只是文档存在。
OPC Operating Envelope:一人公司当前目标、角色、Mandate、资源、承诺、能力、风险和编译关系的派生运行视图。
Harness:将上下文、工具、权限、执行、证据和现实效力连接起来的运行环境。
Context Compiler:按任务和 Mandate 从本地世界生成最小充分上下文、未知和来源引用的组件。
Effect Gateway:执行 Operation 并从目标域获取 authoritative readback 的组件。
Event Ledger:保存版本、来源、Authority 和因果历史的事件图。
TrustAdapter:连接支付、托管、凭证、仲裁、Repository、法律签署或其他效力基础设施的可替换适配器。
v0.7 被判定为扩展研究计划而非正式统一论文,主要因为其正文把历史形成过程和证据压成最新判断。v1.0 回收了以下六层:
本版不要求所有历史术语进入顶层本体,但要求每个术语有明确去向。完整逐项 42 条损失审计随论文单独发布。
核心历史案例需要责任根、至少两个时序事件、过程丰富的一手来源、形成/编译/失败结构和明确限制。每例记录 task family、capability nodes、八类协调机制、authority pattern、formation actions、compiled assets、principal constraints、failure/reopen 和 event stream。frontier_low_assurance 不进入核心归纳。当前 20 例与 59 事件全部通过 JSON Schema 验证,但尚无双人编码一致性。
〔公开版删改 · R-11〕 本处原文为〔参考实现一致性清单(安全不变量到内部函数/模块符号的映射表)〕,因协议设计文本目前处于闭源阶段,公开版移除。移除范围与理由见包内 REDACTIONS.md 条目 R-11。此删改不改变本文任何实验结论的方向。
每个 live case 至少包含:CaseScreen、Consent/DataBoundary、FrozenPreState、AuthorityMap、MandateBundle、RelationVersionHistory、FormationTrace、CoordinationPlan、Commitment/Reservation、OperationTrace、EffectEvidence、Adoption/Acceptance、CostLog、IndependentAdjudication 和 FollowUp。完整方案书与十二份表单作为本文的复现附件发布。
[1] S. Russell and P. Norvig, Artificial Intelligence: A Modern Approach, 4th ed. Pearson, 2021.
[2] B. J. Grosz and S. Kraus, “Collaborative plans for complex group action,” Artificial Intelligence, vol. 86, no. 2, pp. 269–357, 1996. doi: 10.1016/0004-3702(95)00103-4.
[3] M. P. Singh, “Agent communication languages: Rethinking the principles,” Computer, vol. 31, no. 12, pp. 40–47, 1998. doi: 10.1109/2.735849.
[4] A. K. Chopra and M. P. Singh, “Multiagent commitment alignment,” in Proc. 8th Int. Conf. Autonomous Agents and Multiagent Systems, 2009, pp. 937–944.
[5] V. Dignum, A Model for Organizational Interaction: Based on Agents, Founded in Logic. Utrecht University, 2004.
[6] A2A Protocol Project, “A2A Protocol Specification,” 2026. https://a2a-protocol.org/latest/specification/ (accessed Jul. 25, 2026).
[7] Model Context Protocol Project, “Model Context Protocol Specification: Authorization,” version 2025-11-25, 2025. https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization (accessed Jul. 25, 2026).
[8] W3C Verifiable Credentials Working Group, “Verifiable Credentials Data Model v2.0,” W3C Recommendation, 2025. https://www.w3.org/TR/vc-data-model-2.0/.
[9] P. Kasselman, J. Lombardo, Y. Rosomakho, B. Campbell, N. Steele, and A. Parecki, “AI Agent Authentication and Authorization,” Internet-Draft draft-klrc-aiagent-auth-03, Jul. 2026. Work in progress.
[10] K. McGuinness, “Mission-Bound Authorization for OAuth 2.0,” Internet-Draft draft-mcguinness-oauth-mission-00, Jul. 2026. Work in progress.
[11] T. Sato, “The Mandate JWT (MJWT) for Agentic AI Systems,” Internet-Draft draft-sato-soos-mjwt-02, Jun. 2026. Work in progress.
[12] N. Tishby, F. C. Pereira, and W. Bialek, “The information bottleneck method,” arXiv:physics/0004057, 2000.
[13] D. Blackwell, “Equivalent comparisons of experiments,” Annals of Mathematical Statistics, vol. 24, no. 2, pp. 265–272, 1953. doi: 10.1214/aoms/1177729032.
[14] M. Braverman, “Interactive information complexity,” SIAM Journal on Computing, vol. 44, no. 6, pp. 1698–1739, 2015. doi: 10.1137/130938517.
[15] H. Nissenbaum, Privacy in Context: Technology, Policy, and the Integrity of Social Life. Stanford University Press, 2010.
[16] J. F. Benders, “Partitioning procedures for solving mixed-variables programming problems,” Numerische Mathematik, vol. 4, pp. 238–252, 1962. doi: 10.1007/BF01386316.
[17] G. B. Dantzig and P. Wolfe, “Decomposition principle for linear programs,” Operations Research, vol. 8, no. 1, pp. 101–111, 1960. doi: 10.1287/opre.8.1.101.
[18] A. Solar-Lezama, L. Tancau, R. Bodik, S. A. Seshia, and V. Saraswat, “Combinatorial sketching for finite programs,” in Proc. ASPLOS XII, 2006, pp. 404–415. doi: 10.1145/1168857.1168907.
[19] R. B. Myerson and M. A. Satterthwaite, “Efficient mechanisms for bilateral trading,” Journal of Economic Theory, vol. 29, no. 2, pp. 265–281, 1983. doi: 10.1016/0022-0531(83)90048-0.
[20] J. W. Hatfield and P. R. Milgrom, “Matching with contracts,” American Economic Review, vol. 95, no. 4, pp. 913–935, 2005. doi: 10.1257/0002828054825466.
[21] E. Ostrom, “Beyond markets and states: Polycentric governance of complex economic systems,” American Economic Review, vol. 100, no. 3, pp. 641–672, 2010. doi: 10.1257/aer.100.3.641.
[22] S. E. S. Crawford and E. Ostrom, “A grammar of institutions,” American Political Science Review, vol. 89, no. 3, pp. 582–600, 1995. doi: 10.2307/2082975.
[23] M. P. Herlihy and J. M. Wing, “Linearizability: A correctness condition for concurrent objects,” ACM Transactions on Programming Languages and Systems, vol. 12, no. 3, pp. 463–492, 1990. doi: 10.1145/78969.78972.
[24] K. M. Chandy and L. Lamport, “Distributed snapshots: Determining global states of distributed systems,” ACM Transactions on Computer Systems, vol. 3, no. 1, pp. 63–75, 1985. doi: 10.1145/214451.214456.
[25] H. Garcia-Molina and K. Salem, “Sagas,” in Proc. ACM SIGMOD, 1987, pp. 249–259. doi: 10.1145/38713.38742.
[26] P. Bailis, A. Fekete, M. J. Franklin, A. Ghodsi, J. M. Hellerstein, and I. Stoica, “Coordination avoidance in database systems,” Proceedings of the VLDB Endowment, vol. 8, no. 3, pp. 185–196, 2014. doi: 10.14778/2735508.2735509.
[27] M. Kleppmann and A. R. Beresford, “A conflict-free replicated JSON datatype,” IEEE Transactions on Parallel and Distributed Systems, vol. 28, no. 10, pp. 2733–2746, 2017. doi: 10.1109/TPDS.2017.2697382.
[28] J. H. Saltzer, D. P. Reed, and D. D. Clark, “End-to-end arguments in system design,” ACM Transactions on Computer Systems, vol. 2, no. 4, pp. 277–288, 1984. doi: 10.1145/357401.357402.
[29] S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal, “Detecting hallucinations in large language models using semantic entropy,” Nature, vol. 630, pp. 625–630, 2024. doi: 10.1038/s41586-024-07421-0.
[30] S. Bates, A. N. Angelopoulos, L. Lei, J. Malik, and M. I. Jordan, “Distribution-free, risk-controlling prediction sets,” Journal of the ACM, vol. 71, no. 2, 2024. doi: 10.1145/3636514.
[31] J. C. Perdomo, T. Zrnic, C. Mendler-Dünner, and M. Hardt, “Performative prediction,” in Proc. 37th Int. Conf. Machine Learning, vol. 119, 2020, pp. 7599–7609.
[32] M. E. Bratman, Shared Agency: A Planning Theory of Acting Together. Oxford University Press, 2014.
[33] J. R. Searle, Speech Acts: An Essay in the Philosophy of Language. Cambridge University Press, 1969.
[34] L. A. Suchman, Plans and Situated Actions: The Problem of Human-Machine Communication. Cambridge University Press, 1987.
[35] K. E. Weick, K. M. Sutcliffe, and D. Obstfeld, “Organizing and the process of sensemaking,” Organization Science, vol. 16, no. 4, pp. 409–421, 2005. doi: 10.1287/orsc.1050.0133.
[36] J. G. March, “Exploration and exploitation in organizational learning,” Organization Science, vol. 2, no. 1, pp. 71–87, 1991. doi: 10.1287/orsc.2.1.71.
[37] S. L. Star and J. R. Griesemer, “Institutional ecology, ‘translations’ and boundary objects,” Social Studies of Science, vol. 19, no. 3, pp. 387–420, 1989. doi: 10.1177/030631289019003001.
[38] W3C Provenance Working Group, “PROV-O: The PROV Ontology,” W3C Recommendation, 2013. https://www.w3.org/TR/prov-o/.
[39] D. Hardt, “The OAuth 2.0 Authorization Framework,” RFC 6749, IETF, 2012. doi: 10.17487/RFC6749.
[40] National Institute of Standards and Technology, Artificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1, 2023. doi: 10.6028/NIST.AI.100-1.
[41] M. Lubell, M. Robins, and X. Wang, “Institutional design and coordination under California’s Sustainable Groundwater Management Act,” Journal of Public Administration Research and Theory, vol. 34, no. 2, pp. 255–273, 2024.
[42] Qualitative Data Repository, “Coordination and institutional design under SGMA: De-identified interview transcripts and supporting data,” dataset, doi: 10.5064/F6QHVGUI.
[43] Competition and Markets Authority, Open Banking: Lessons Learned Review, United Kingdom, 2022.
[44] National Audit Office, Completing Crossrail, United Kingdom, 2019.
[45] Waterfront Toronto, Quayside: Round One Public Consultation Feedback Report, 2019.
[46] European Commission, “Case M.8124 — Microsoft/LinkedIn,” merger decision, 2016.
[47] European Commission, “Case M.10920 — Amazon/iRobot,” merger proceedings and decision materials, 2023–2024.
[48] U.S. Government Accountability Office, “Human Landing System procurement protest decisions and related NASA records,” 2021–2024.
[49] P. Belt, J. Paloniemi, and H. V. Väänänen, “One-Person Enterprises and Business Growth,” Journal of Enterprising Culture, vol. 23, no. 3, 2015. doi: 10.1142/S0218495815500132.
[50] S. M. E. van den Groenendaal, J. Akkermans, C. Fleisher, D. T. A. M. Kooij, R. F. Poell, and C. Freese, “A qualitative exploration of solo self-employed workers' career sustainability,” Journal of Vocational Behavior, vol. 134, article 103692, 2022. doi: 10.1016/j.jvb.2022.103692.
[51] 通爻研究计划,《Agent-to-Agent 研究交接全量档案 v1.0》,内部研究档案,2026。
[52] 通爻研究计划,《通爻协议设计语料库 v1.5》,内部规范与实验档案,2026。
[53] 通爻研究计划,《从搜索到行动构成》,第二轮理论论文,2026。
[54] 通爻研究计划,《边界预言机与生成式协调引擎》,第二轮系统与实验论文,2026。
[55] 通爻研究计划,《第五阶段首次本地现实返回》,真实工作区实验包,2026。
[56] 通爻研究计划,《R5.2 Effect Reality Reconstruction and Capability Holdout》,内部实验包,2026。
[57] 通爻研究计划,《R5.4 真实模型协商负对照》,内部实验包,2026。
[58] 通爻研究计划,《R5C 跨技术权威域形成闭环》,内部实验包,2026。
[59] 通爻研究计划,《Towow A2A Independent Research v0.4》,理论、规范、Fieldkit 与构造实验发布包,2026。
[60] 通爻研究计划,《Towow A2A Independent Research v0.6: Public Institutional Process Calibration》,公开证据研究包,2026。
[61] 通爻研究计划,《Towow Agentic OPC Research v0.7》,OPC、QDR、Router 与 Fieldkit 研究包,2026。
[62] WoWok Project, “Programmable trust objects for AI collaboration,” project documentation, 2026. https://www.wowok.net/launch.
[63] Carta, “Solo Founders Report 2025,” Dec. 2025. https://carta.com/data/solo-founders-report/ (accessed Jul. 27, 2026).
[64] S. T. Howell and C. B. Bingham, “Solo vs. Co: The Founder’s Dilemma and Venture Resource Mobilization,” working paper / qualitative study of 59 ventures, 2024–2025.
[65] L. Lamport, Specifying Systems: The TLA+ Language and Tools for Hardware and Software Engineers. Addison-Wesley, 2002; TLA+ project documentation and TLC model checker. https://lamport.azurewebsites.net/tla/tla.html.
[66] AJ, “Examining the Repeated Successes of a Product-Focused Solo Founder,” Indie Hackers Podcast, 2019. https://www.indiehackers.com/podcast/087-aj-of-carrd.
[67] Pieter Levels, “Confronting Your Fears and Taking a Leap with Pieter Levels,” Indie Hackers Podcast, 2018. https://www.indiehackers.com/podcast/043-pieter-levels-of-nomad-list.
[68] Mike Perham, “Building a $1 Million Business Solo with Mike Perham of Sidekiq,” Indie Hackers Podcast, 2017. https://www.indiehackers.com/podcast/016-mike-perham-of-sidekiq.
[69] Jen Yip, “Acquiring the Experience to Make It as a Solo Founder with Jen Yip of Lunch Money,” Indie Hackers Podcast, 2020. https://www.indiehackers.com/podcast/150-jen-yip-of-lunch-money.
[70] Moritz Dausinger, “From Side Projects to Serial Entrepreneur with Moritz Dausinger,” Indie Hackers Podcast, 2017. https://www.indiehackers.com/podcast/024-moritz-dausinger-of-docparser.
[71] Christy Laurence, “Bootstrapping to $1 Million in Two Years as a Non-Technical Solo Founder,” Indie Hackers Podcast, 2018. https://www.indiehackers.com/podcast/071-christy-laurence-of-plann.
[72] Derrick Reimer, “How to Take On Huge Incumbents as a Solo Founder with Derrick Reimer of SavvyCal,” Indie Hackers Podcast, 2021. https://www.indiehackers.com/podcast/210-derrick-reimer.
[73] Jordan O'Connor, “Building a $38k/Month SaaS Business as a Solo Founder,” Indie Hackers Podcast, 2020. https://www.indiehackers.com/podcast/187-jordan-oconnor-of-closet-tools.
[74] Ben Tossell, “Creating a $200k Side Project Without Writing a Line of Code,” Indie Hackers Podcast, 2019. https://www.indiehackers.com/podcast/106-ben-tossell-of-makerpad.
[75] Chris Oliver, “How a Solo Founder Got to $1M in Revenue with Chris Oliver of GoRails,” Indie Hackers Podcast, 2020. https://www.indiehackers.com/podcast/183-chris-oliver-of-gorails.
[76] Mike Carson, “Making $125,000 a Month as a Solo Founder with Mike Carson of Park.io,” Indie Hackers Podcast, 2017. https://www.indiehackers.com/podcast/034-mike-carson-of-park-io.
[77] Adam Wathan; Steve Schoger, “How to Make $2.5MM as a Solo Founder by Teaching What You Know,” Indie Hackers Podcast, 2019. https://www.indiehackers.com/podcast/098-adam-wathan-of-refactoring-ui.
[78] Taylor Otwell, “Creating an Ecosystem for Millions by Building for Yourself,” Indie Hackers Podcast, 2019. https://www.indiehackers.com/podcast/137-taylor-otwell-of-laravel.
[79] Evan You, “Taking on Google and Facebook as a Solo Open-Source Founder,” Indie Hackers Podcast, 2018. https://www.indiehackers.com/podcast/078-evan-you-of-vue.
[80] Arvid Kahl; Danielle Simpson, “Vital Learnings from Bootstrapping and Selling a $55k a Month Business,” Indie Hackers Podcast, 2019. https://www.indiehackers.com/podcast/140-arvid-kahl-of-feedbackpanda.
[81] Sahil Lavingia, “From Aspiring Billionaire to Indie Hacker with Sahil Lavingia,” Indie Hackers Podcast, 2019. https://www.indiehackers.com/podcast/100-sahil-lavingia-of-gumroad.
[82] Joe Howard, “Quick Chat with Joe Howard of WP Buffs,” Indie Hackers Podcast, 2019. https://www.indiehackers.com/podcast/107-quick-chat-with-joe-howard.
[83] John Doherty, “From Laid Off to Generating $25,000 in Monthly Revenue with Credo,” Indie Hackers Podcast, 2018. https://www.indiehackers.com/podcast/059-john-doherty-of-credo.
[84] anonymous self-reporting solo developer, “I shipped a productivity SaaS in 30 days as a solo dev—what AI actually changed,” Indie Hackers, 2026. https://www.indiehackers.com/post/i-shipped-a-productivity-saas-in-30-days-as-a-solo-dev-heres-what-ai-actually-changed-and-what-it-didn-t-15c8876106 (low-assurance self-report; hypothesis generation only).
[85] solo founder, “Growing a fully autonomous business to a large monthly run rate in three months,” Indie Hackers, 2026. https://www.indiehackers.com/post/tech/growing-a-fully-autonomus-business-to-a-500k-mo-in-3-months-diZ8gkqMHm0CvEsc7Pfo (low-assurance self-report; hypothesis generation only).
[86] S. D. Sarasvathy, “Causation and Effectuation: Toward a Theoretical Shift from Economic Inevitability to Entrepreneurial Contingency,” Academy of Management Review, vol. 26, no. 2, pp. 243–263, 2001.
[87] T. Baker and R. E. Nelson, “Creating Something from Nothing: Resource Construction through Entrepreneurial Bricolage,” Administrative Science Quarterly, vol. 50, no. 3, pp. 329–366, 2005.
[88] K. Muszyński et al., “Entrepreneurial Opportunities and Working Conditions of Self-Employed Online Freelancers in the Platform Economy: Lessons from the COVID-19 Pandemic,” OECD SME and Entrepreneurship Papers, no. 45, 2023. doi: 10.1787/ebc310de-en.
[89] U.S. Census Bureau, “Nonemployer Statistics: 2023 Data and Small Business Landscape,” 2025–2026. The program reports establishment counts and receipts for U.S. businesses with no paid employees.
DOWNLOAD · VERIFY · CITE